









| 查看: 41 | 回复: 0 | |||
[交流]
Nature|scBERT如何用预训练模型完成细胞注释
|

|
导读 2022年,腾讯 AI Lab 与上海交通大学团队在 Nature Machine Intelligence 发表 scBERT,首次把 Transformer 架构引入单细胞 RNA 测序的细胞类型注释。模型在 PanglaoDB 百万级无标注细胞上自监督预训练,再以少量标注数据微调,在 9 个数据集、17 个器官、逾 50 种细胞类型上多数指标领先;跨平台胰腺数据准确率达 0.992,并能识别参考集中不存在的新细胞类型。该工作为单细胞注释提供了可迁移、可解释的通用表征范式。 研究背景 单细胞 RNA 测序已在单细胞分辨率上刻画复杂组织与器官,但准确注释细胞类型仍是疾病机制解析与肿瘤微环境研究的前置环节。 现有注释方法可分三类:依赖人工 marker 基因的方法受研究者先验与 marker 可及性限制;基于相关性的方法易受批次效应与高维稀疏数据影响;监督分类方法多需先做高变基因选择与降维,会丢失基因级可解释性并引入人工偏倚。 自然语言处理中的 BERT 以预训练加微调的范式实现了通用表征的突破,启发了把它迁移到转录组这一“基因的语言”上,以未标注数据学习跨批次的通用模式。 研究方法 研究以 BERT 的预训练—微调范式为核心,构建面向单细胞转录组的 scBERT,并从多个维度系统评估其注释性能: 嵌入设计:以 gene2vec 生成基因身份嵌入,将表达值离散分箱,再映射为 200 维表达嵌入,与 gene2vec 基因嵌入相加后输入模型。 模型骨干:用 Performer 替代标准 Transformer 编码器,以近线性复杂度把输入基因数扩展到两万以上,无需高变基因选择与降维。 两阶段训练:先在 PanglaoDB 百万级无标注细胞上以掩码重构做自监督预训练,再以带标注参考数据微调分类器。 评测体系:在 9 个数据集、17 个器官、逾 50 种细胞类型、逾 50 万细胞上,与 marker、相关性、监督分类三类主流方法做交叉验证对比。 核心发现 1、提出 scBERT:把预训练—微调范式迁移到单细胞转录组 研究提出 scBERT,一个面向单细胞 RNA 测序细胞类型注释的统一深度模型。 它沿用 BERT 的预训练—微调思想:先在海量无标注细胞上学习基因—基因交互的“通用语法”,再以少量标注参考数据微调出分类器。 关键设计在于用 gene2vec 提供基因身份嵌入,将分箱表达值映射为表达嵌入并与基因身份嵌入相加,再用 Performer 把输入扩展到两万基因的全基因组尺度。(图 1 见附件) 图 1 《scBERT 模型总览:自监督预训练与监督微调两阶段架构》 · 来源:Yang et al., 2022, Nature Machine Intelligence · 模型架构示意图 全图分两阶段:上部为无标注数据经随机掩码、gene2vec 基因嵌入与表达分箱后送入 Performer,用重构损失自监督预训练;下部为带标签数据经同一编码器加一维卷积与分类器输出细胞类型。读图先看两阶段共用的编码器与各自独立的损失,再对照 (b) 中基因嵌入与表达嵌入相加的示意。 2、批内基准测试中总体表现领先,并在类别失衡测试中保持优势 在涵盖 17 个器官、逾 50 种细胞类型、逾 50 万细胞的 9 个数据集上做五折交叉验证,scBERT 在多数数据集的准确率与宏 F1 领先。 在细胞类型严重失衡、亚型高度相似的 Zheng68K 外周血数据上,其 F1 达 0.691、准确率 0.759,均高于其他方法的最好成绩。 仅用 30% 参考细胞时 scBERT 仍胜过所有对比方法,且在人为构造的失衡数据上误分率最低。(图 2 见附件) 图 2《批内交叉验证的注释性能与稳健性评估》 · 来源:Yang et al., 2022, Nature Machine Intelligence · 箱线图与 t-SNE 图 完整研究在九个数据集上开展五折交叉验证;本图 (a) 展示其中六个数据集的准确率,F1 及其余数据集结果见扩展数据图 2。Zheng68K 上 scBERT 的 F1=0.691、准确率=0.759,高于其他方法最好值 0.659 与 0.704。读图先看 (a) 各方法准确率的中位数与四分位数,再看 (b) 真值与预测标签的 t-SNE 分布及 (c) 混淆矩阵;结合 (d) 查看参考集比例对准确率的影响,(e) 展示人为构造失衡数据上的预测混淆矩阵。 3、跨队列、跨测序平台仍保持高准确率 研究用留一数据集策略评估跨队列泛化:以 Baron、Muraro、Segerstolpe、Xin 四个独立队列的人胰腺数据互为参考与查询,四个队列分别采用不同测序平台。 scBERT 取得 0.992 的准确率,明显高于 scNym 的 0.904;在 Muraro 数据中正确注释逾 97% 的细胞,其余三个数据集超过 99%。 对比方法 scNym 会把 α 细胞误判成 β 细胞并混淆 β 与 δ,显示其跨批次稳定性不足。(图 3) 图 3 / Figure 3《跨独立数据集与跨测序平台的注释性能》 · 来源:Yang et al., 2022, Nature Machine Intelligence · t-SNE 图与箱线图 四个平台(inDrop、CEL-Seq2、Smart-Seq2、SMARTer)的胰腺数据做留一验证,scBERT 准确率 0.992,优于 scNym 的 0.904,scNym 会把 α 细胞误判为 β 并混淆 β 与 δ。读图先看 (a)(b) t-SNE 按数据来源与细胞类型的着色分布,再看 (c)(d) 箱线图中各方法 accuracy 与 F1 的高低与离散度;最后对照 (e)(f),查看 scBERT 与 scNym 对 α、β、δ 细胞的预测差异。 4、发现参考集中不存在的新细胞类型 为检验新类型发现能力,研究在训练时从人肝 MacParland 数据中移除 αβ T 细胞、γδ T 细胞、成熟 B 细胞与浆细胞四类群体,再评估已知类和未见类的识别性能。 scBERT 对未见过的新颖类准确率达 0.329,高于 SciBet 与 scmap_cluster 的 0.174;对已知类仍保持 0.942 的高准确率。 模型对低置信度细胞输出“未指派”,避免把新类型强行塞进最近的已知类,兼顾了发现与稳健。(图 4) 图 4《新细胞类型的识别》 · 来源:Yang et al., 2022, Nature Machine Intelligence · 箱线图与桑基图 在 MacParland 人肝数据中移除四类细胞后的评测中,scBERT 对新颖类准确率为 0.329,SciBet 与 scmap_cluster 均为 0.174;scBERT 对已知类准确率为 0.942。读图先看 (a) 移除四类细胞后 Novel 与 Known 的准确率和 F1 箱线图;(b) 左侧展示置信度分布,右侧桑基图以训练中未见的浆细胞为例,展示其被标为 Novel 的预测流向。对所有已知类型的预测概率均低于 0.5 的细胞,被视为潜在新类型,即“未指派”出口。 5、以注意力权重提供基因级可解释性 由于未做高变基因选择与降维,scBERT 的注意力机制能对每个基因给出贡献权重。 在胰腺胰岛数据中,高注意力基因既包含 LOXL4(α 细胞)、ADCYAP1(β 细胞)等已知 marker,也包含被 DESeq 判为差异表达的新候选 marker。 其细胞嵌入在聚类上比原始表达更可分(ARI 0.95 对 0.87),说明模型学到了带基因级线索的细胞特异表征。(图 5) 图 5 / Figure 5《模型可解释性分析》 · 来源:Yang et al., 2022, Nature Machine Intelligence · 热图与点阵图 注意力权重热图列出每种胰腺胰岛细胞的前 10 个高注意力基因:α 细胞命中 LOXL4、β 细胞命中 ADCYAP1,其余多被 DESeq 判为差异表达基因。读图先看 (a) 注意力权重热图:每行对应一个基因、每列对应一个细胞,顶部色条标识细胞类型;再结合 (b) 查看高注意力基因的细胞类型富集结果,(c) 查看各细胞类型与基因对应的 z-score,最后对照 (d) 中 scBERT 嵌入与原始表达的 UMAP 分群(ARI 0.95 对 0.87)。 核心结论速览 - scBERT 是较早把 Transformer 用于单细胞注释的预训练模型。 - 在 9 个数据集、逾 50 万细胞上多数指标领先,并对类别失衡稳健。 - 跨平台胰腺数据准确率 0.992,跨队列泛化优于对比方法。 - 可识别参考集中不存在的新细胞类型,并给出“未指派”出口。 - 注意力权重提供基因级可解释性,可直接读出候选 marker。 研究意义 科学价值:把自然语言处理的预训练—微调范式引入单细胞转录组,以全基因输入与自监督学习统一注释流程,并证明基因级可解释性可以随模型自然获得。 临床价值:更稳更准的细胞类型注释是疾病微环境解析等下游工作的前置环节,有助于减少人工 marker 依赖带来的偏倚。 局限与下一步方向 作者指出三类局限:表达分箱会损失部分分辨率;基因调控网络与生物信号通路等先验知识未显式纳入模型,未来可借图神经网络聚合邻居信息;预训练只对非零值掩码可能降低数据利用率,需为单细胞数据设计更优掩码策略。后续工作拟将 scBERT 拓展到基因—基因交互、批次矫正、聚类与差异分析等任务。 FAQ Q:scBERT 与传统 marker 基因注释有何本质区别? 传统方法依赖人工整理的 marker 列表,结果受先验偏倚影响;scBERT 在无标注数据上自监督学习基因—基因交互,再用少量标注数据微调,不依赖高变基因选择与降维,跨批次泛化与稳健性更好。 Q:为什么 scBERT 能发现参考集中没有的细胞类型? 模型会输出每个细胞属于各已知类型的概率,当全部概率都低于阈值时判为“未指派”,从而避免强行归类;同时注意力机制能捕捉新类型与已知类型之间的细微差异。 Q:模型的可解释性来自哪里? 来自 Transformer 的自注意力权重:每个基因在决策中获得一个权重,权重高的基因即模型判型的主要依据,可直接与已知 marker 及差异表达分析结果对照。 Q:这项工作的主要限制是什么? 作者提到表达分箱带来分辨率损失、基因调控网络等先验未显式建模、只掩码非零值的策略可能降低数据利用率,并计划将模型拓展到更多下游分析任务。 君录视角 · 虚拟细胞 解决的问题:单细胞注释长期依赖人工 marker 基因、高变基因选择与降维,跨批次、跨平台时泛化性差、易过拟合。scBERT 把注释从“依赖先验 marker”改为“数据驱动的基因—基因交互表征”,在百万级无标注细胞上预训练、再以少量标注微调,并保留“未指派”出口以容纳参考集中不存在的新类型。 集成判断:模型的关键增量在于基因身份嵌入(gene2vec)与分箱表达嵌入相加、再以 Performer 把输入扩展到约两万基因的全基因组尺度,从而不做降维也能保留基因级可解释性;这一“预训练+微调”骨架可复用于注释之外的多种下游任务,构成虚拟细胞方向可插拔的表征层。 原文信息 Yang F, Wang W, Wang F, et al. scBERT as a large-scale pretrained deep language model for cell type annotation of single-cell RNA-seq data. Nature Machine Intelligence. 2022;4:852–866. doi:10.1038/s42256-022-00534-z 关于我们 君录生物 · 以数据驱动创新药早期开发,自建心血管专病数据基座+分析平台, 做靶点发现与药物管线早期资产。 本文由AI辅助生成,内容基于已公开发表的学术论文进行科学讨论,不涉及任何未披露的产品信息、临床试验数据或公司管线进展;仅用于生物医药科普及行业学习,不构成医学建议、用药建议或投资建议。如需引用,请参阅原文。转载请注明出处。AI生成内容仅供参考,不构成任何专业建议或决策依据,最终解释权归君录生物所有。 君录生物 · Junlu Biotech 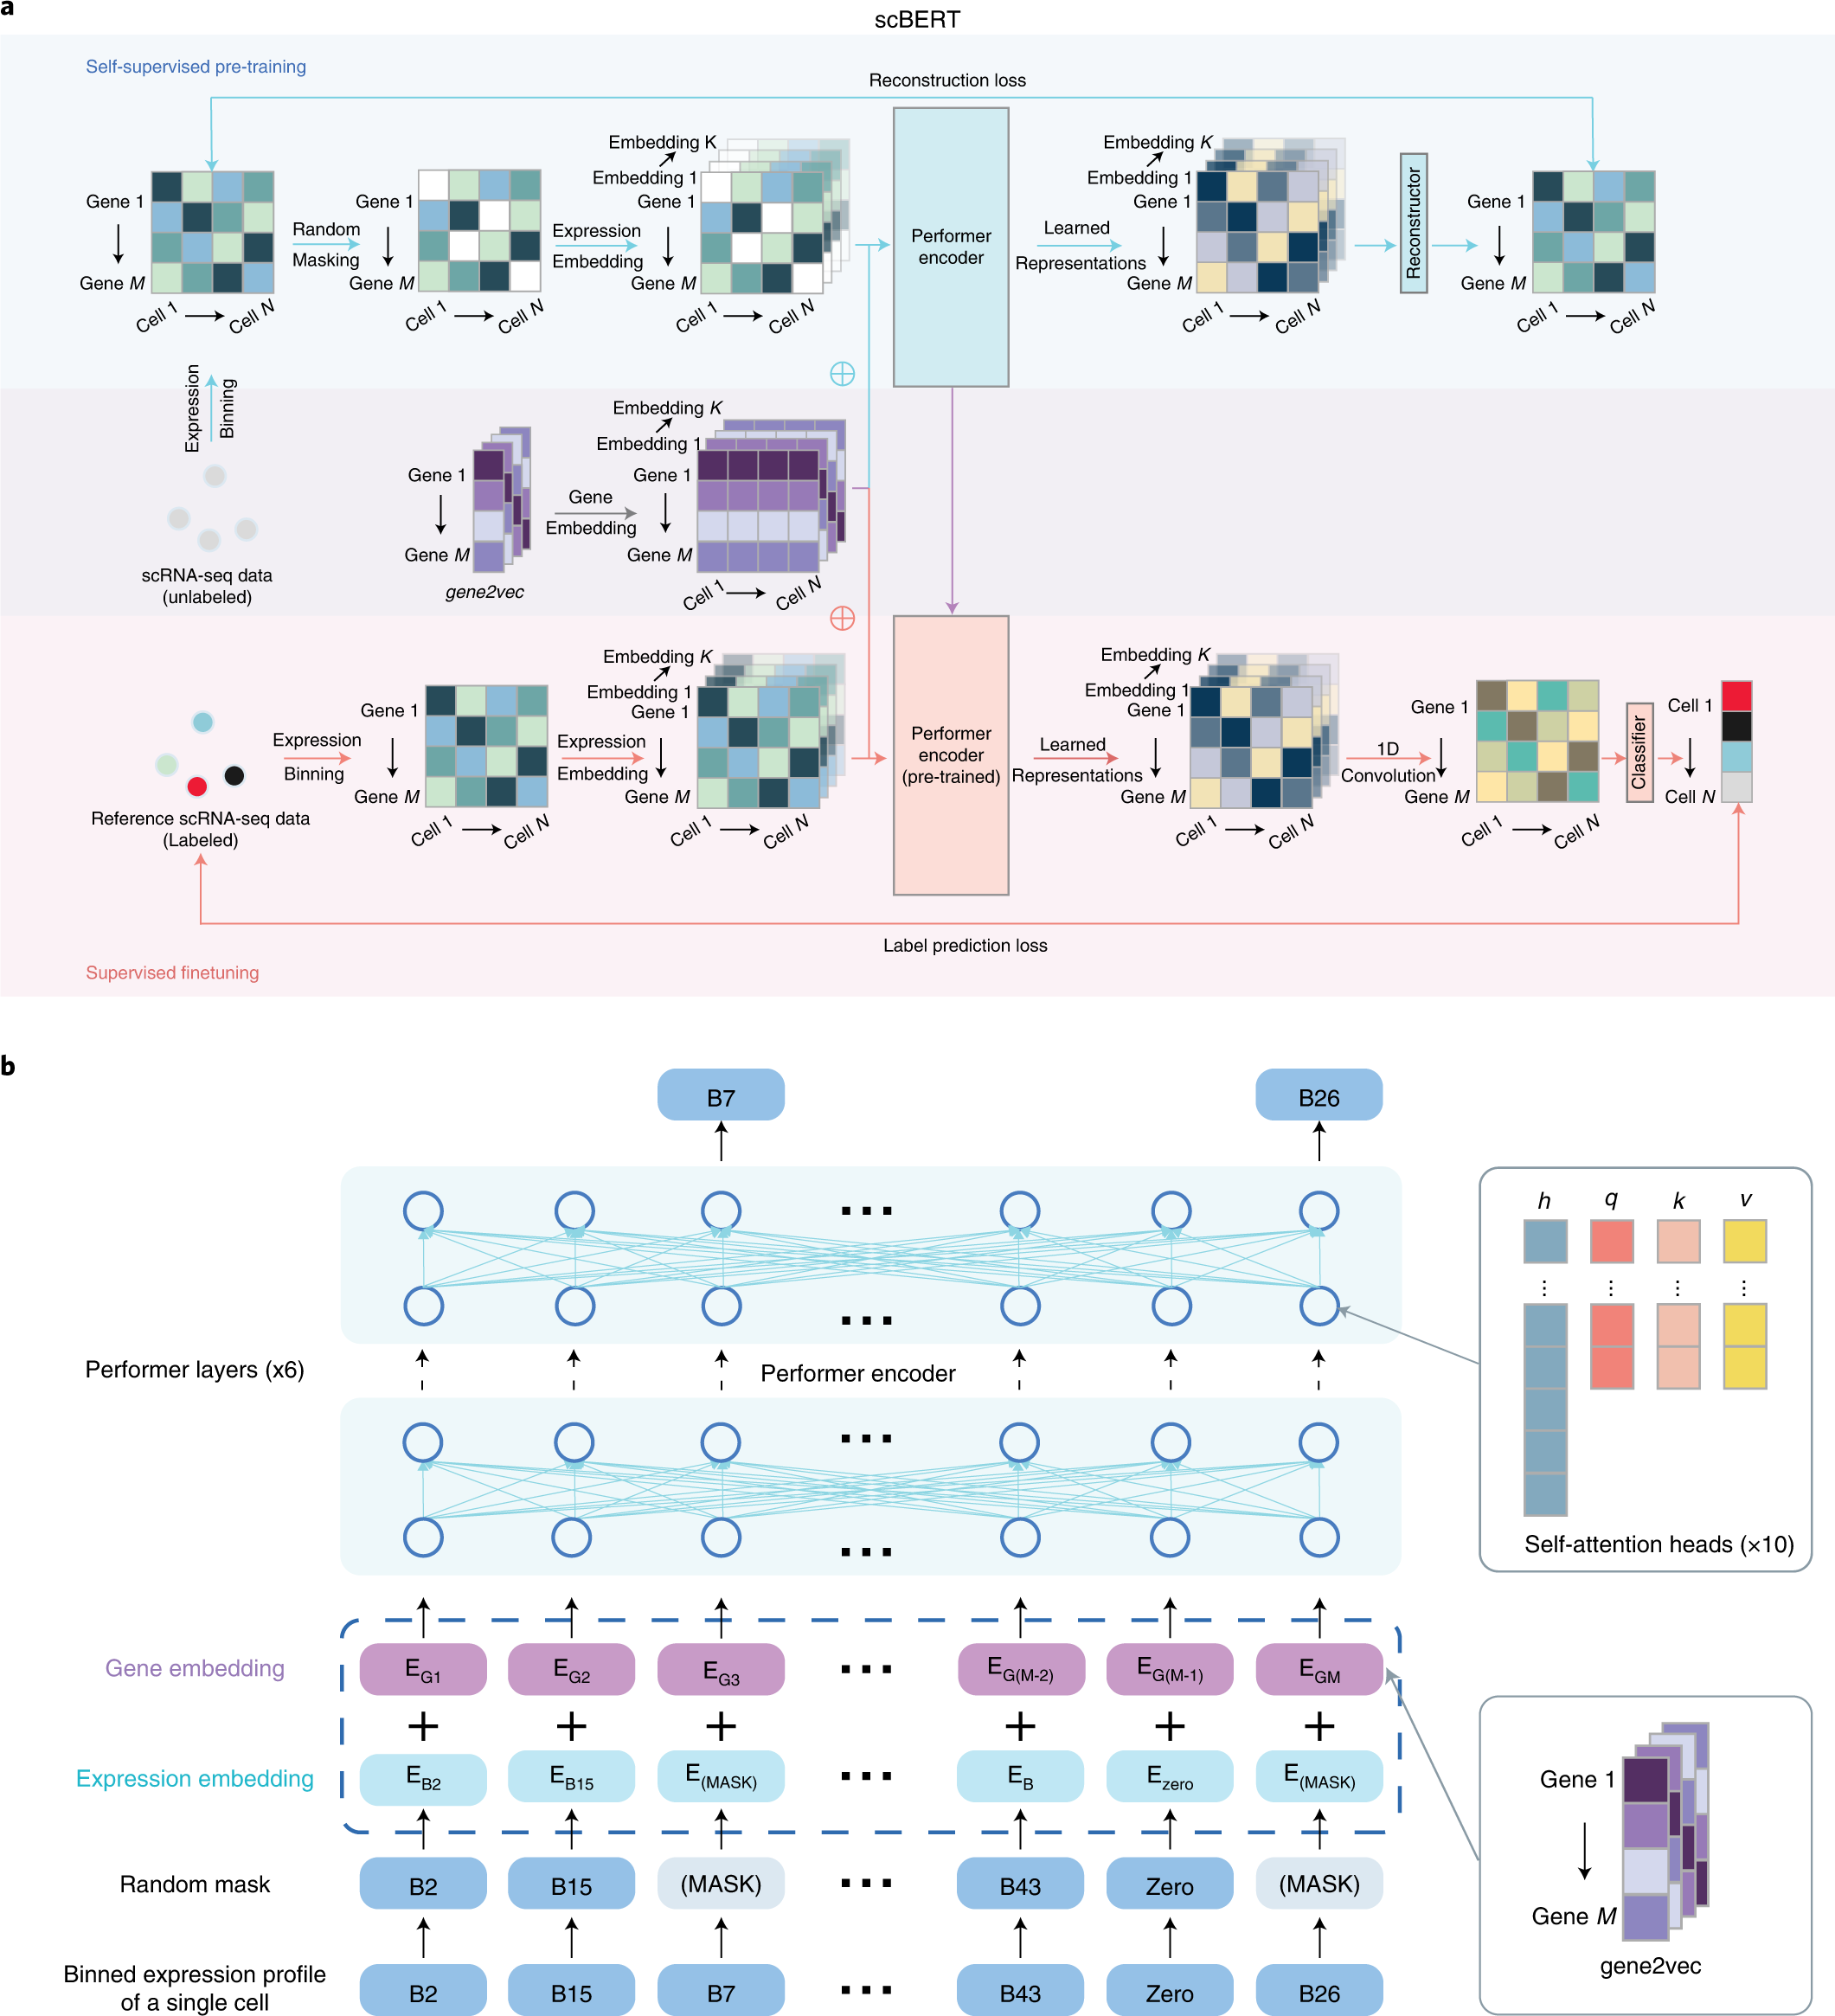 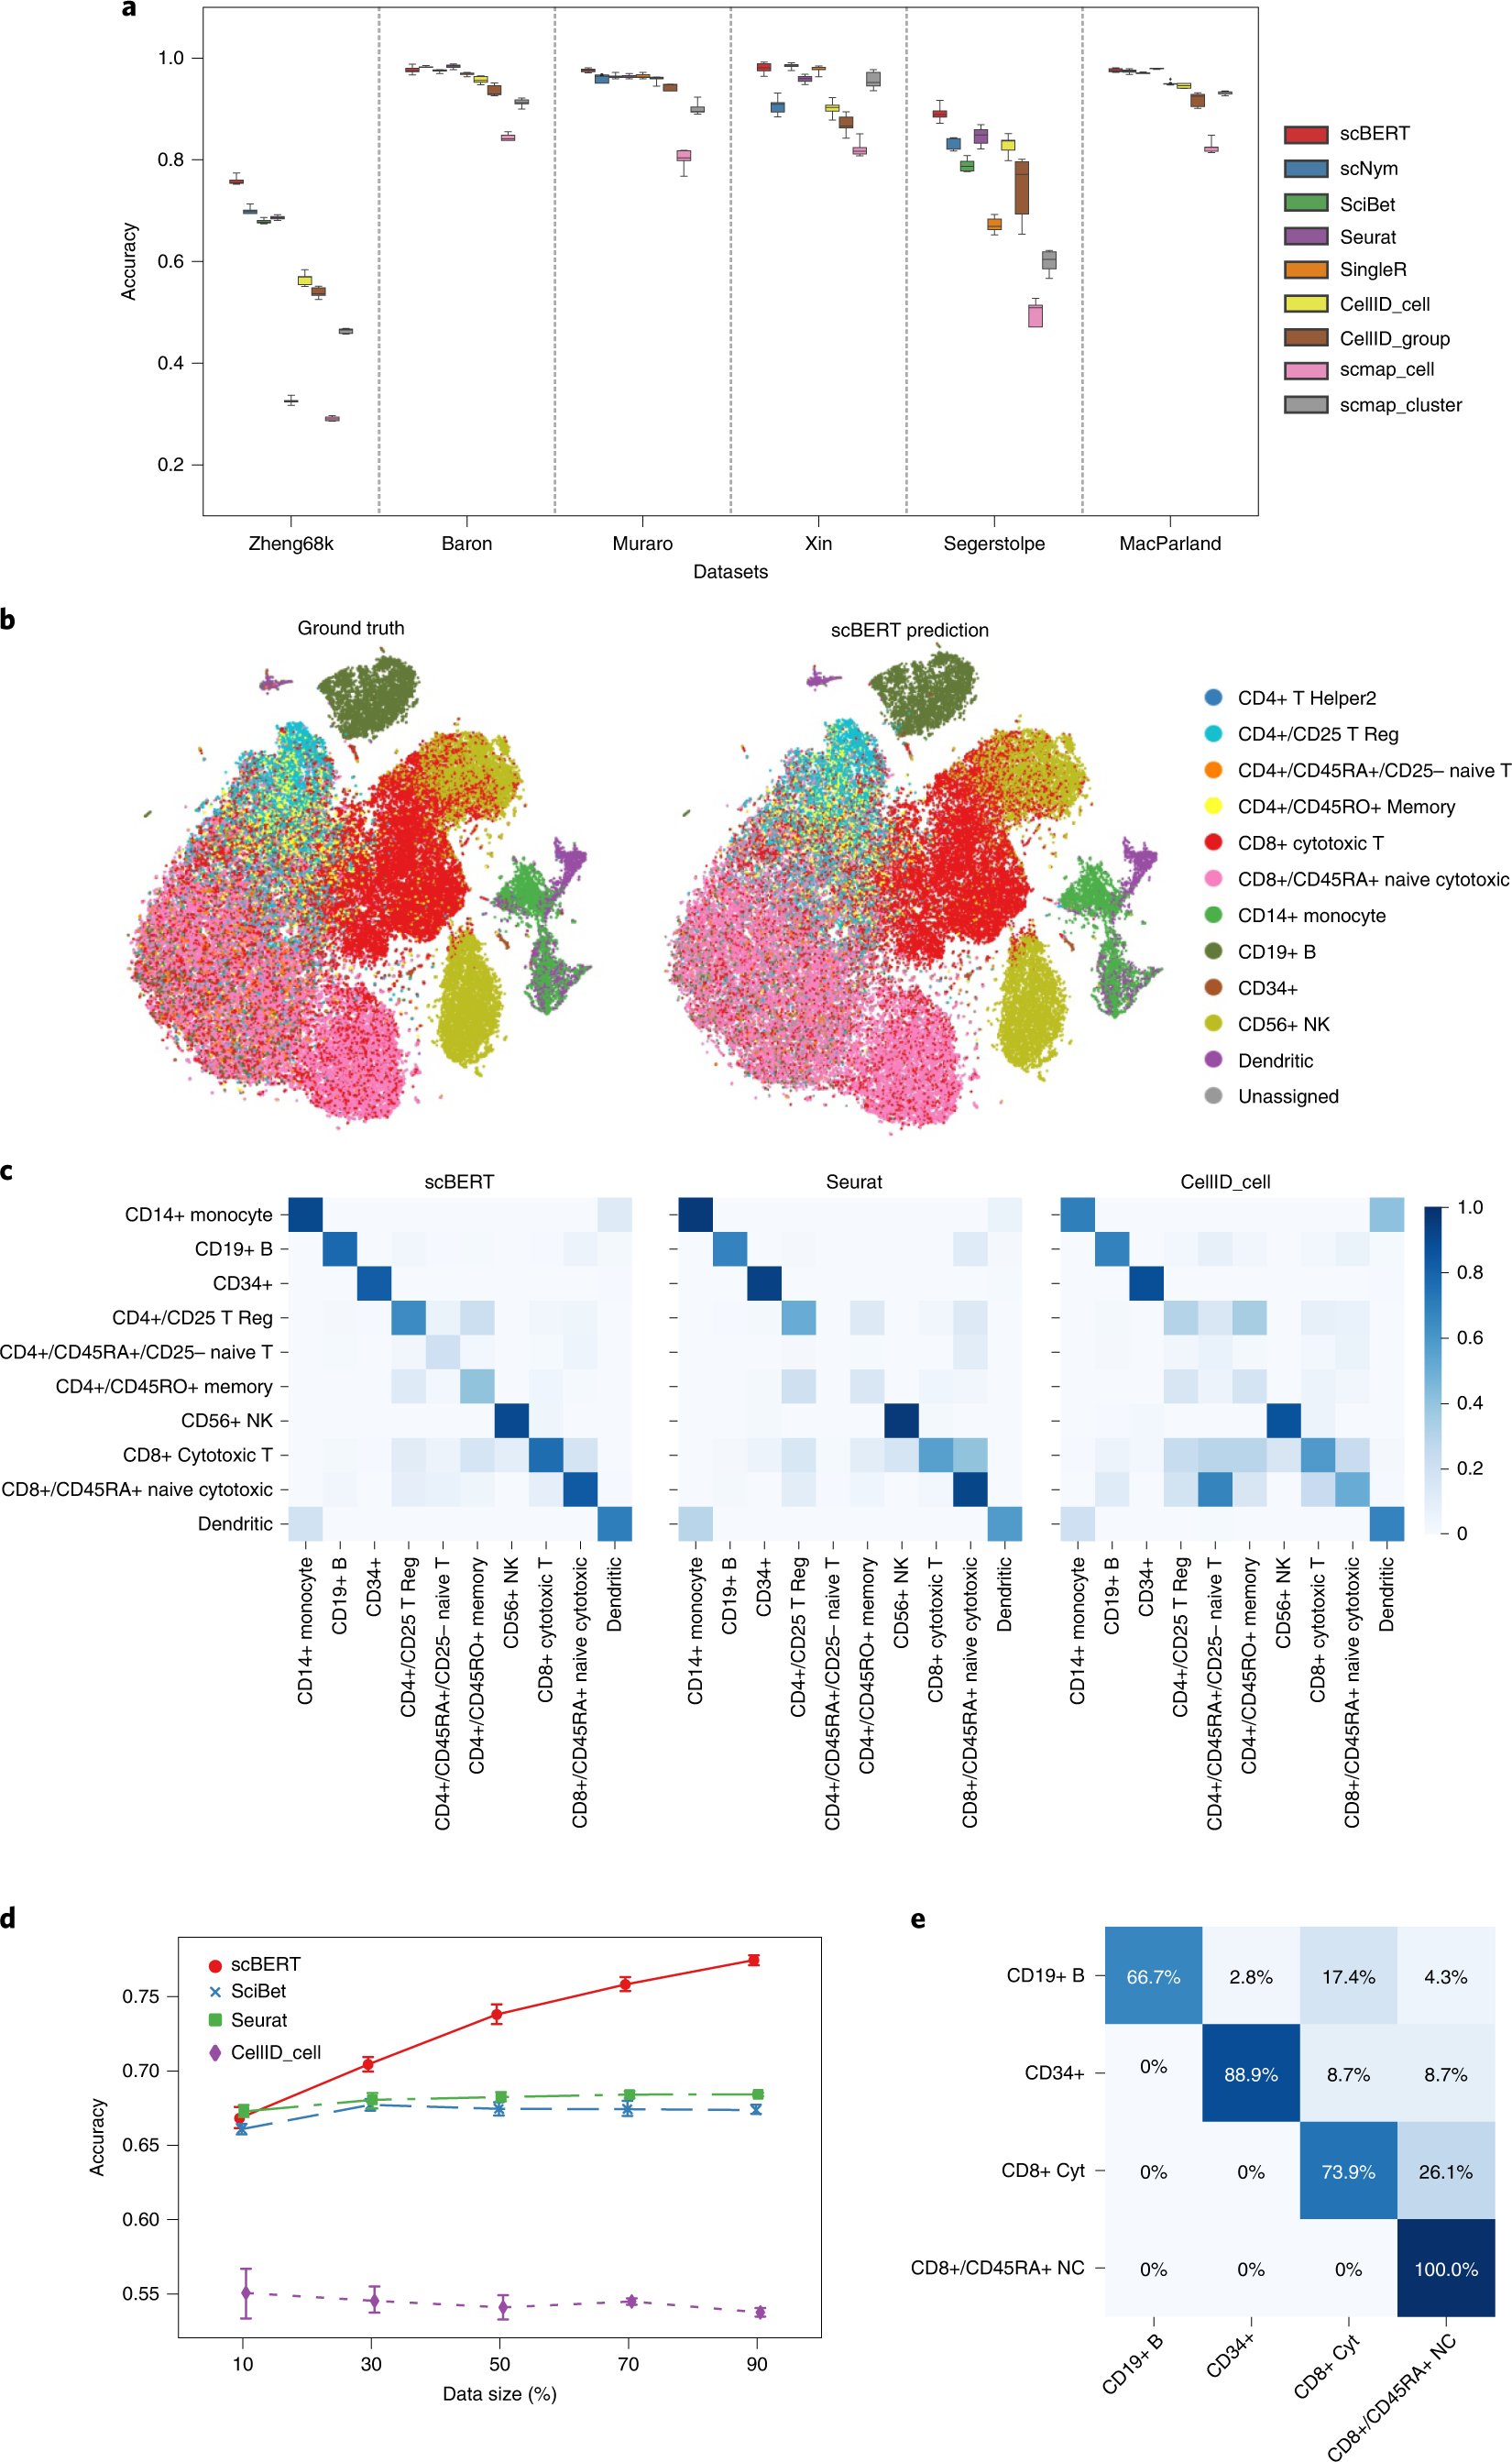 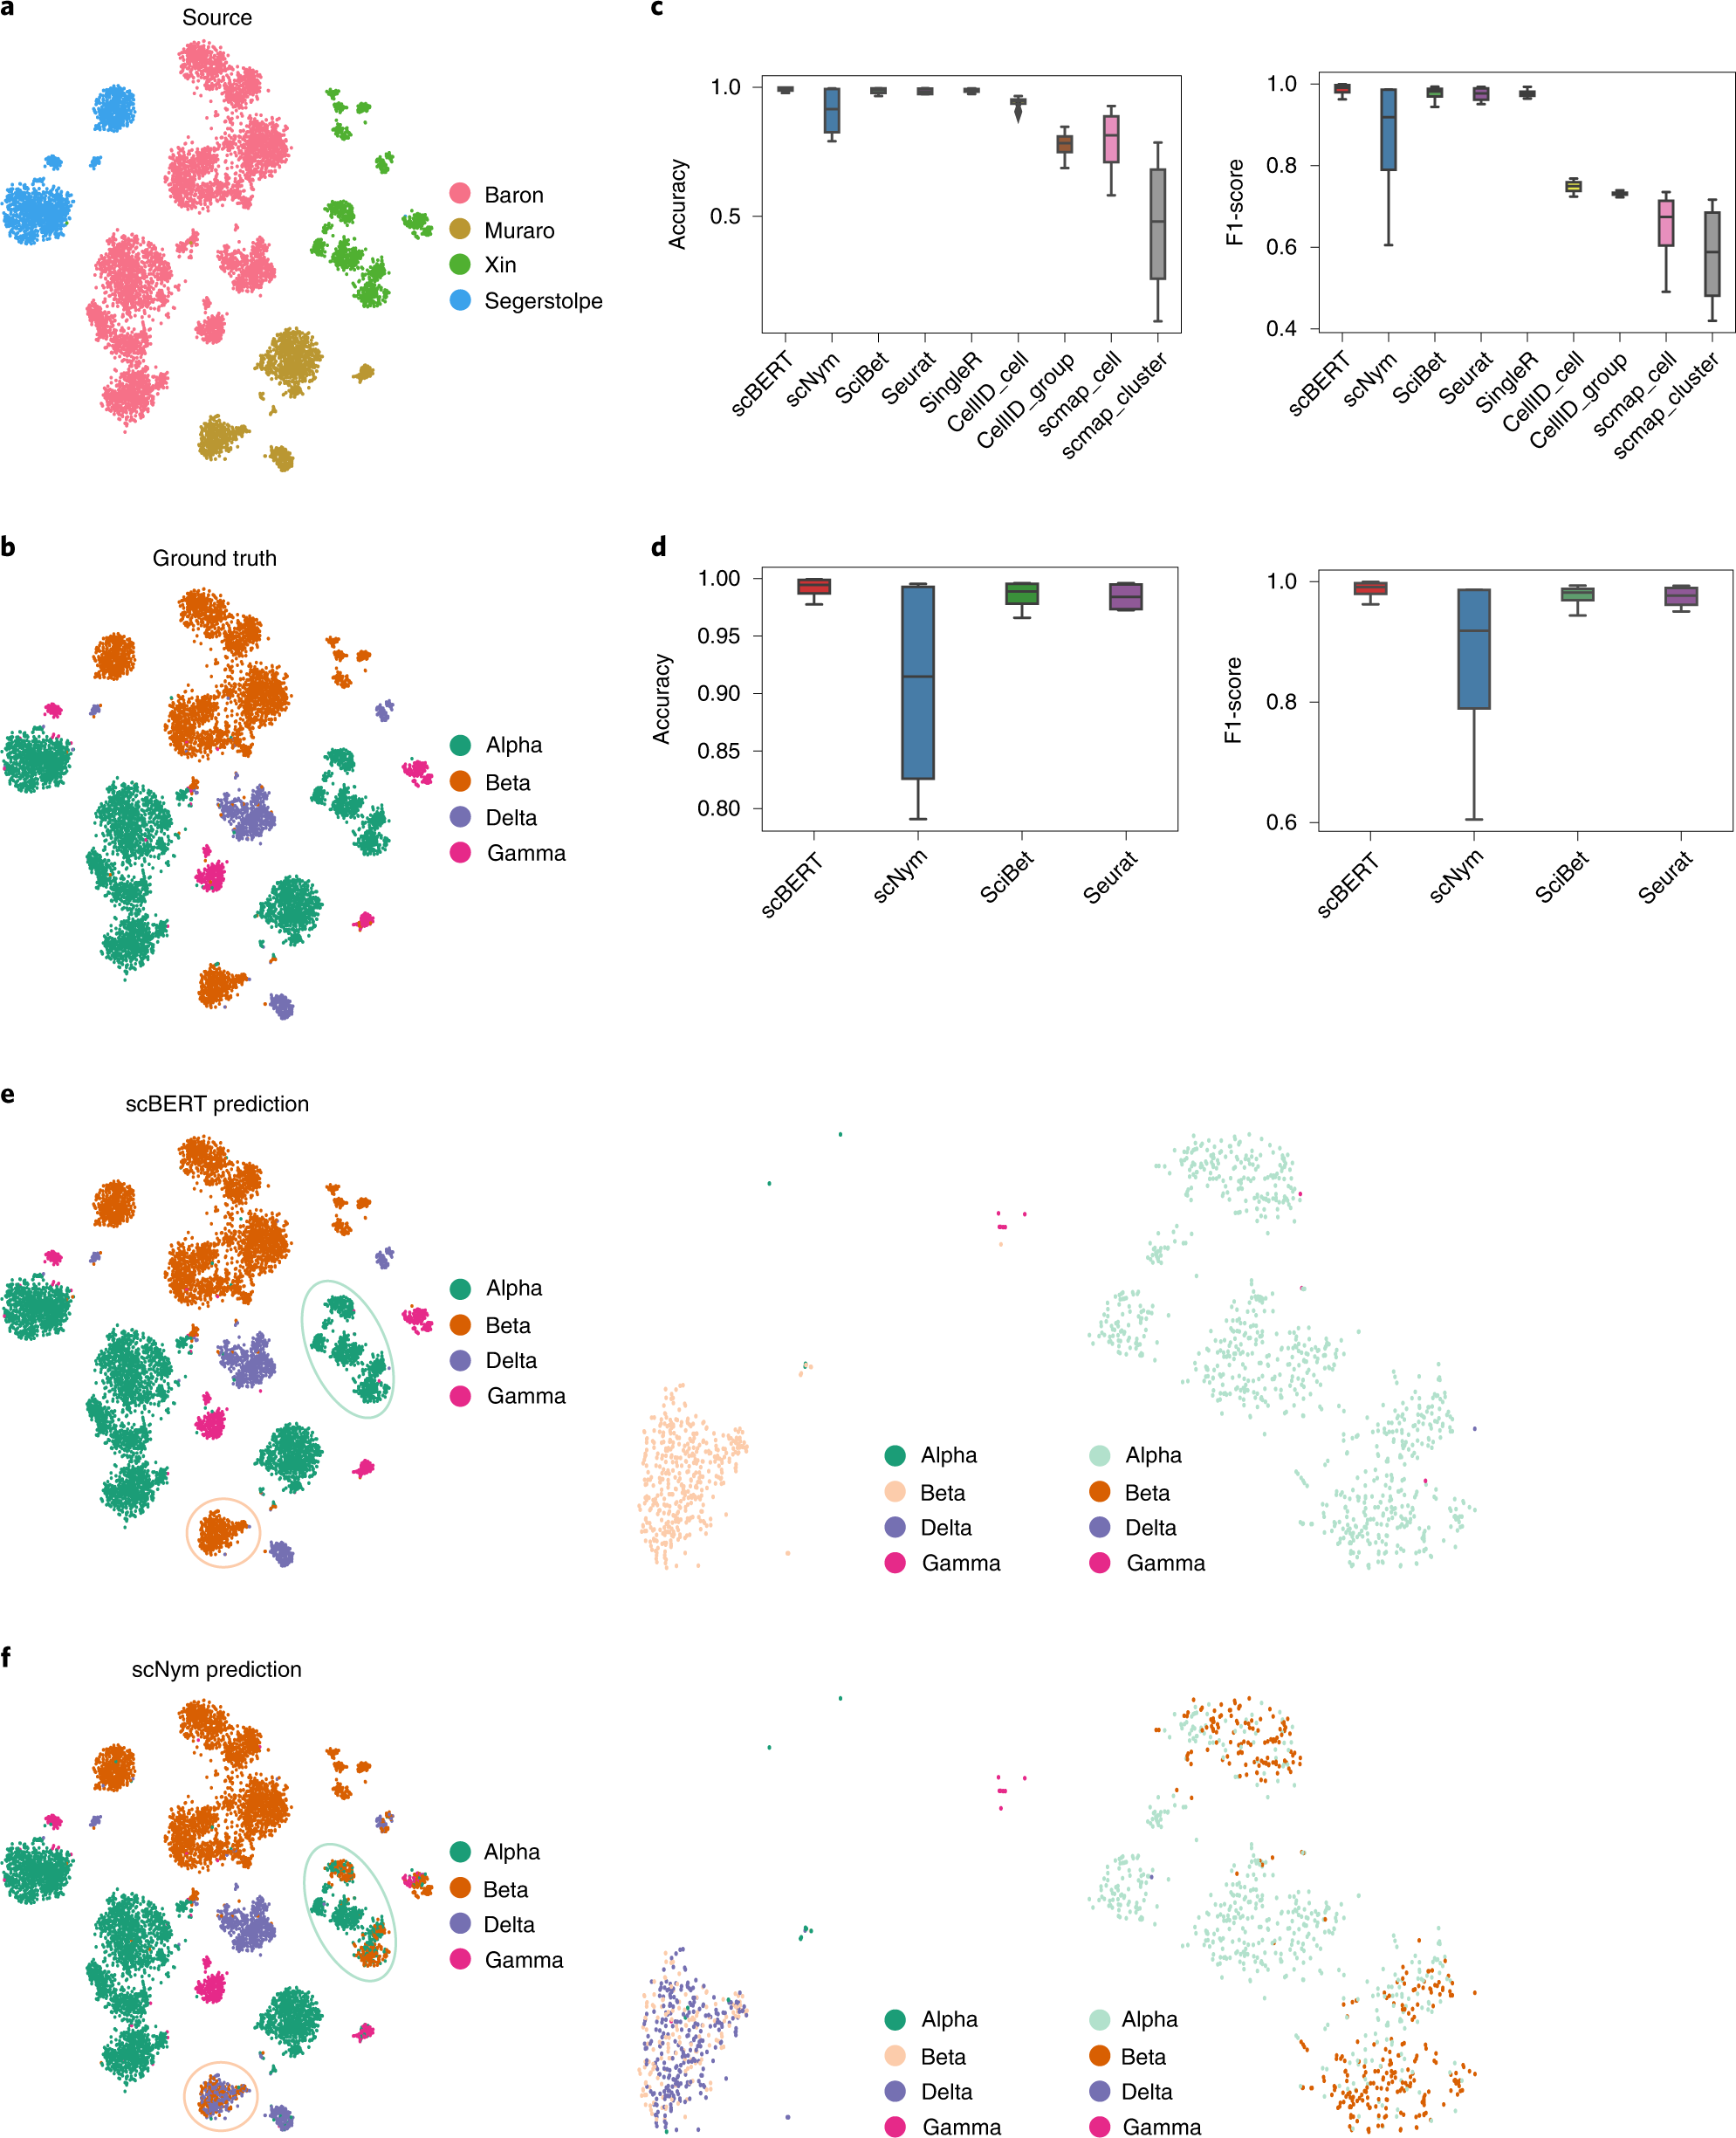 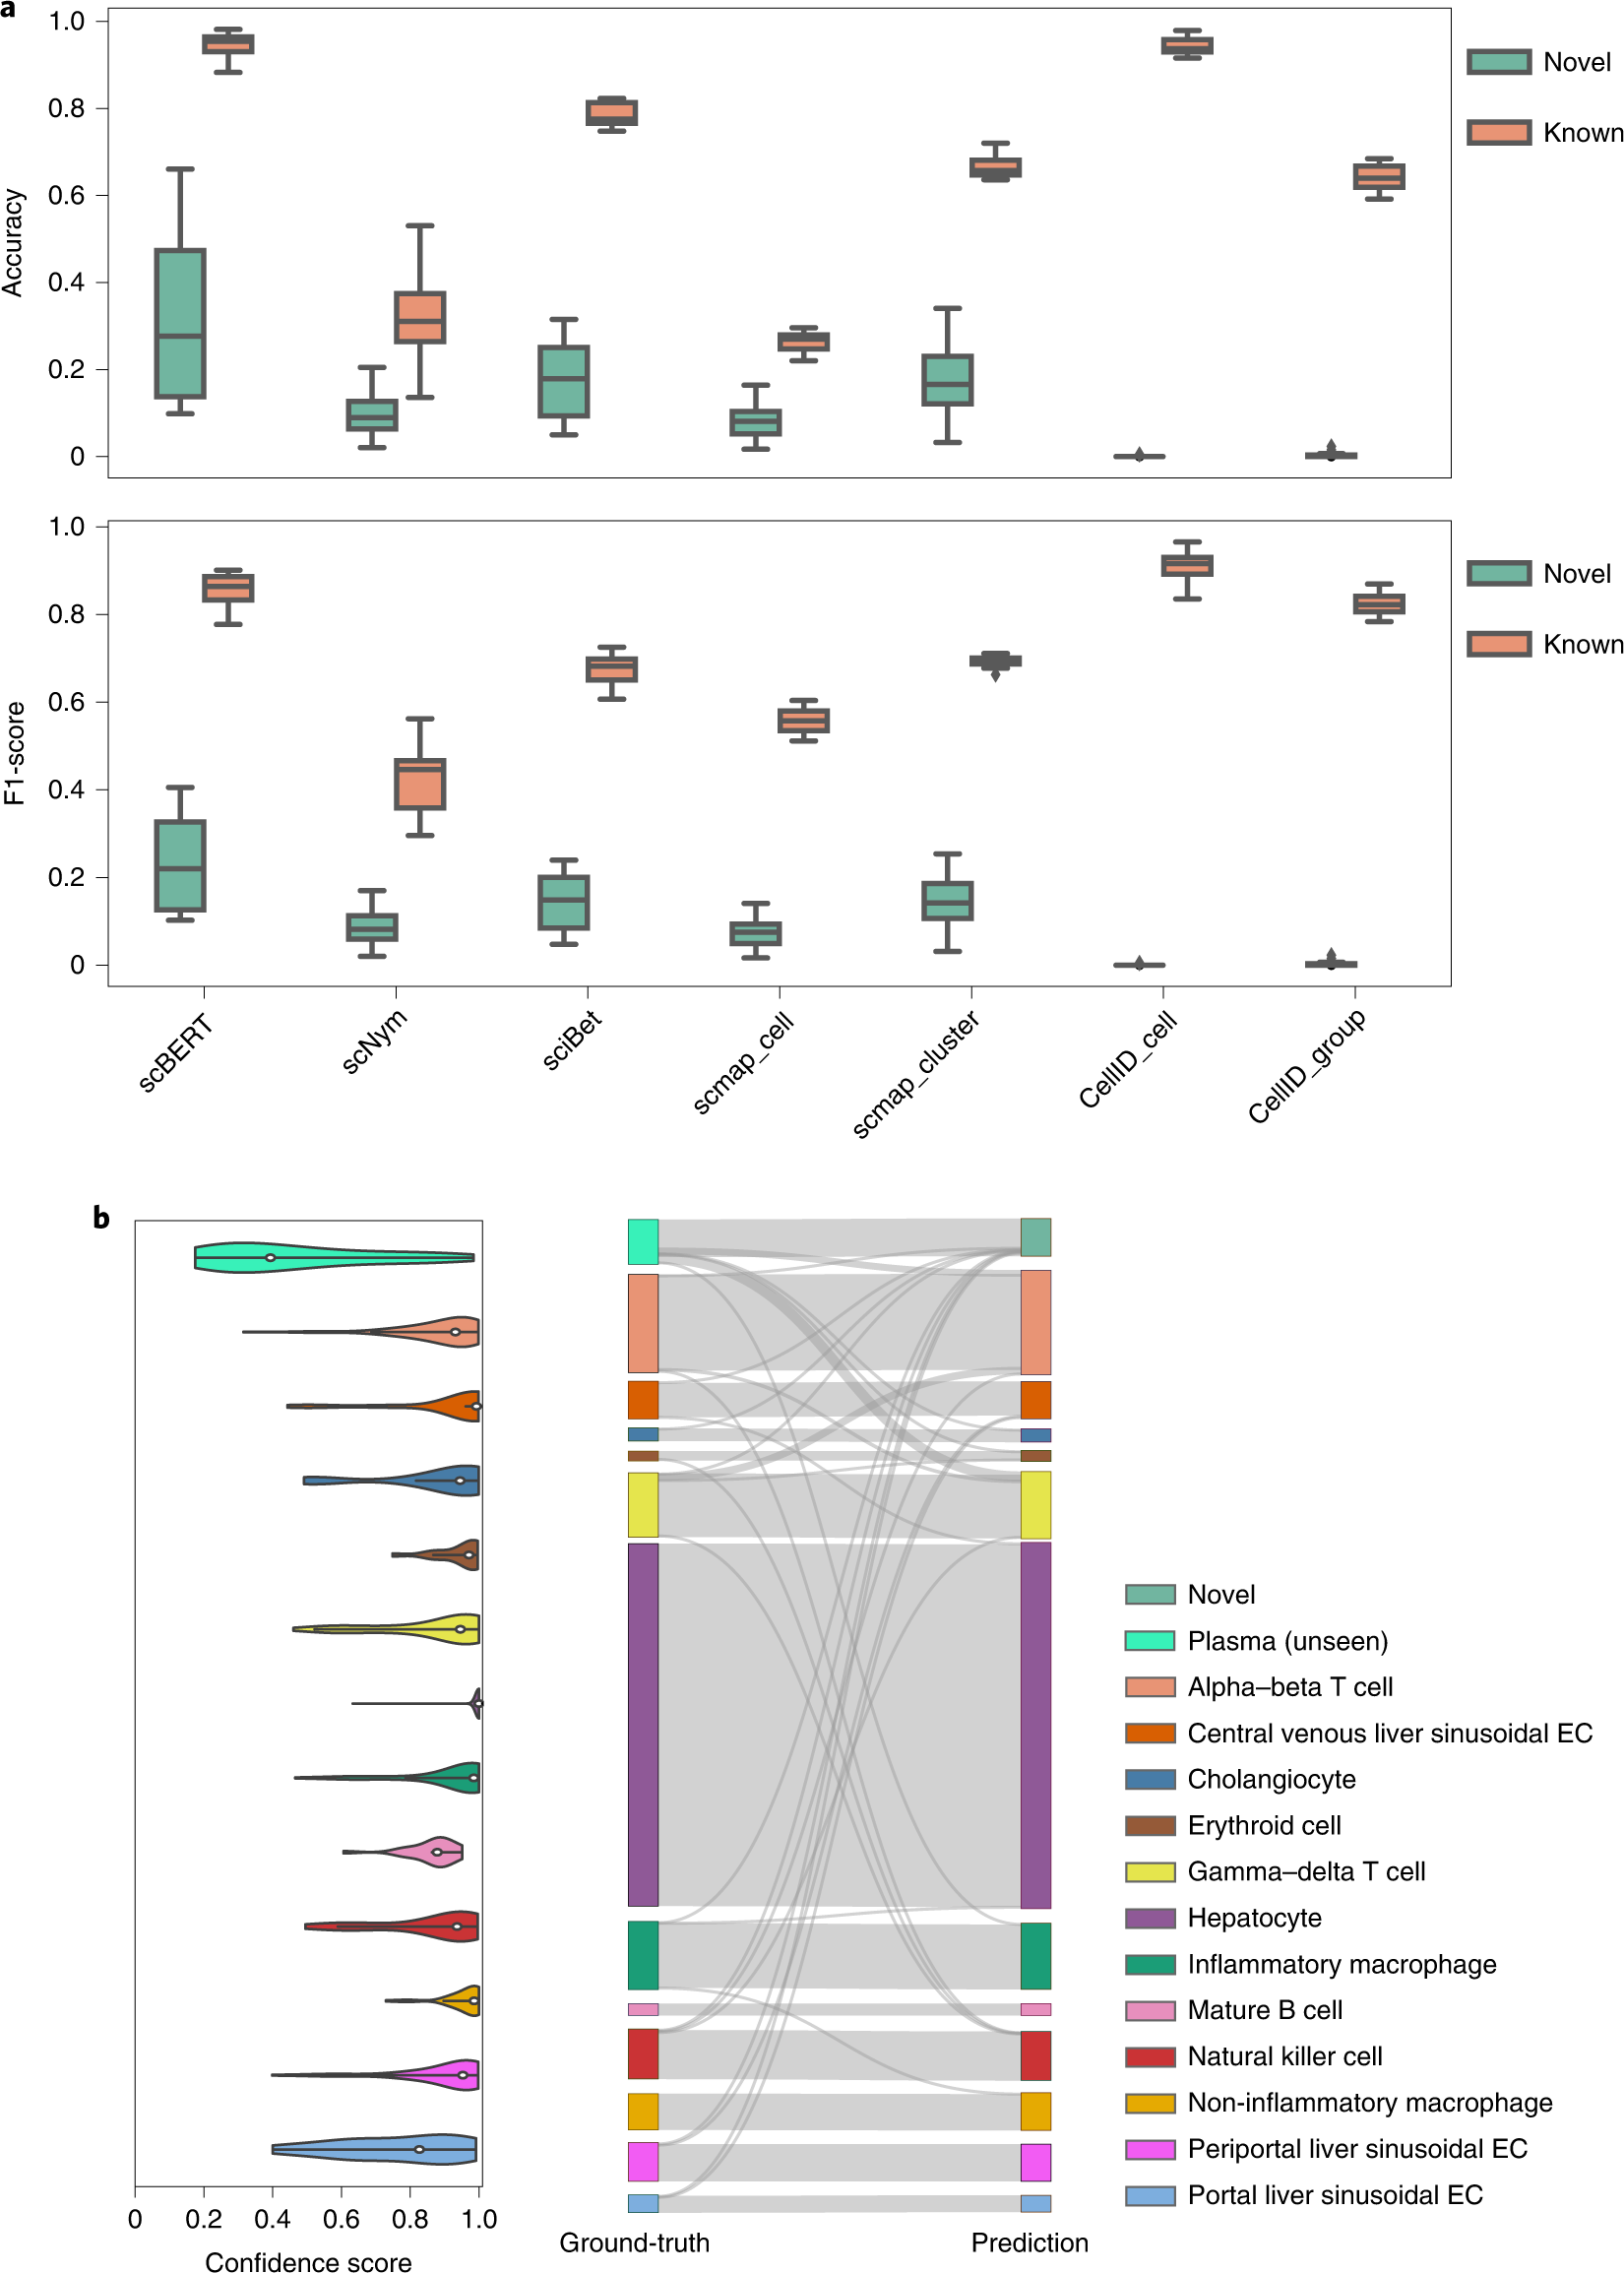 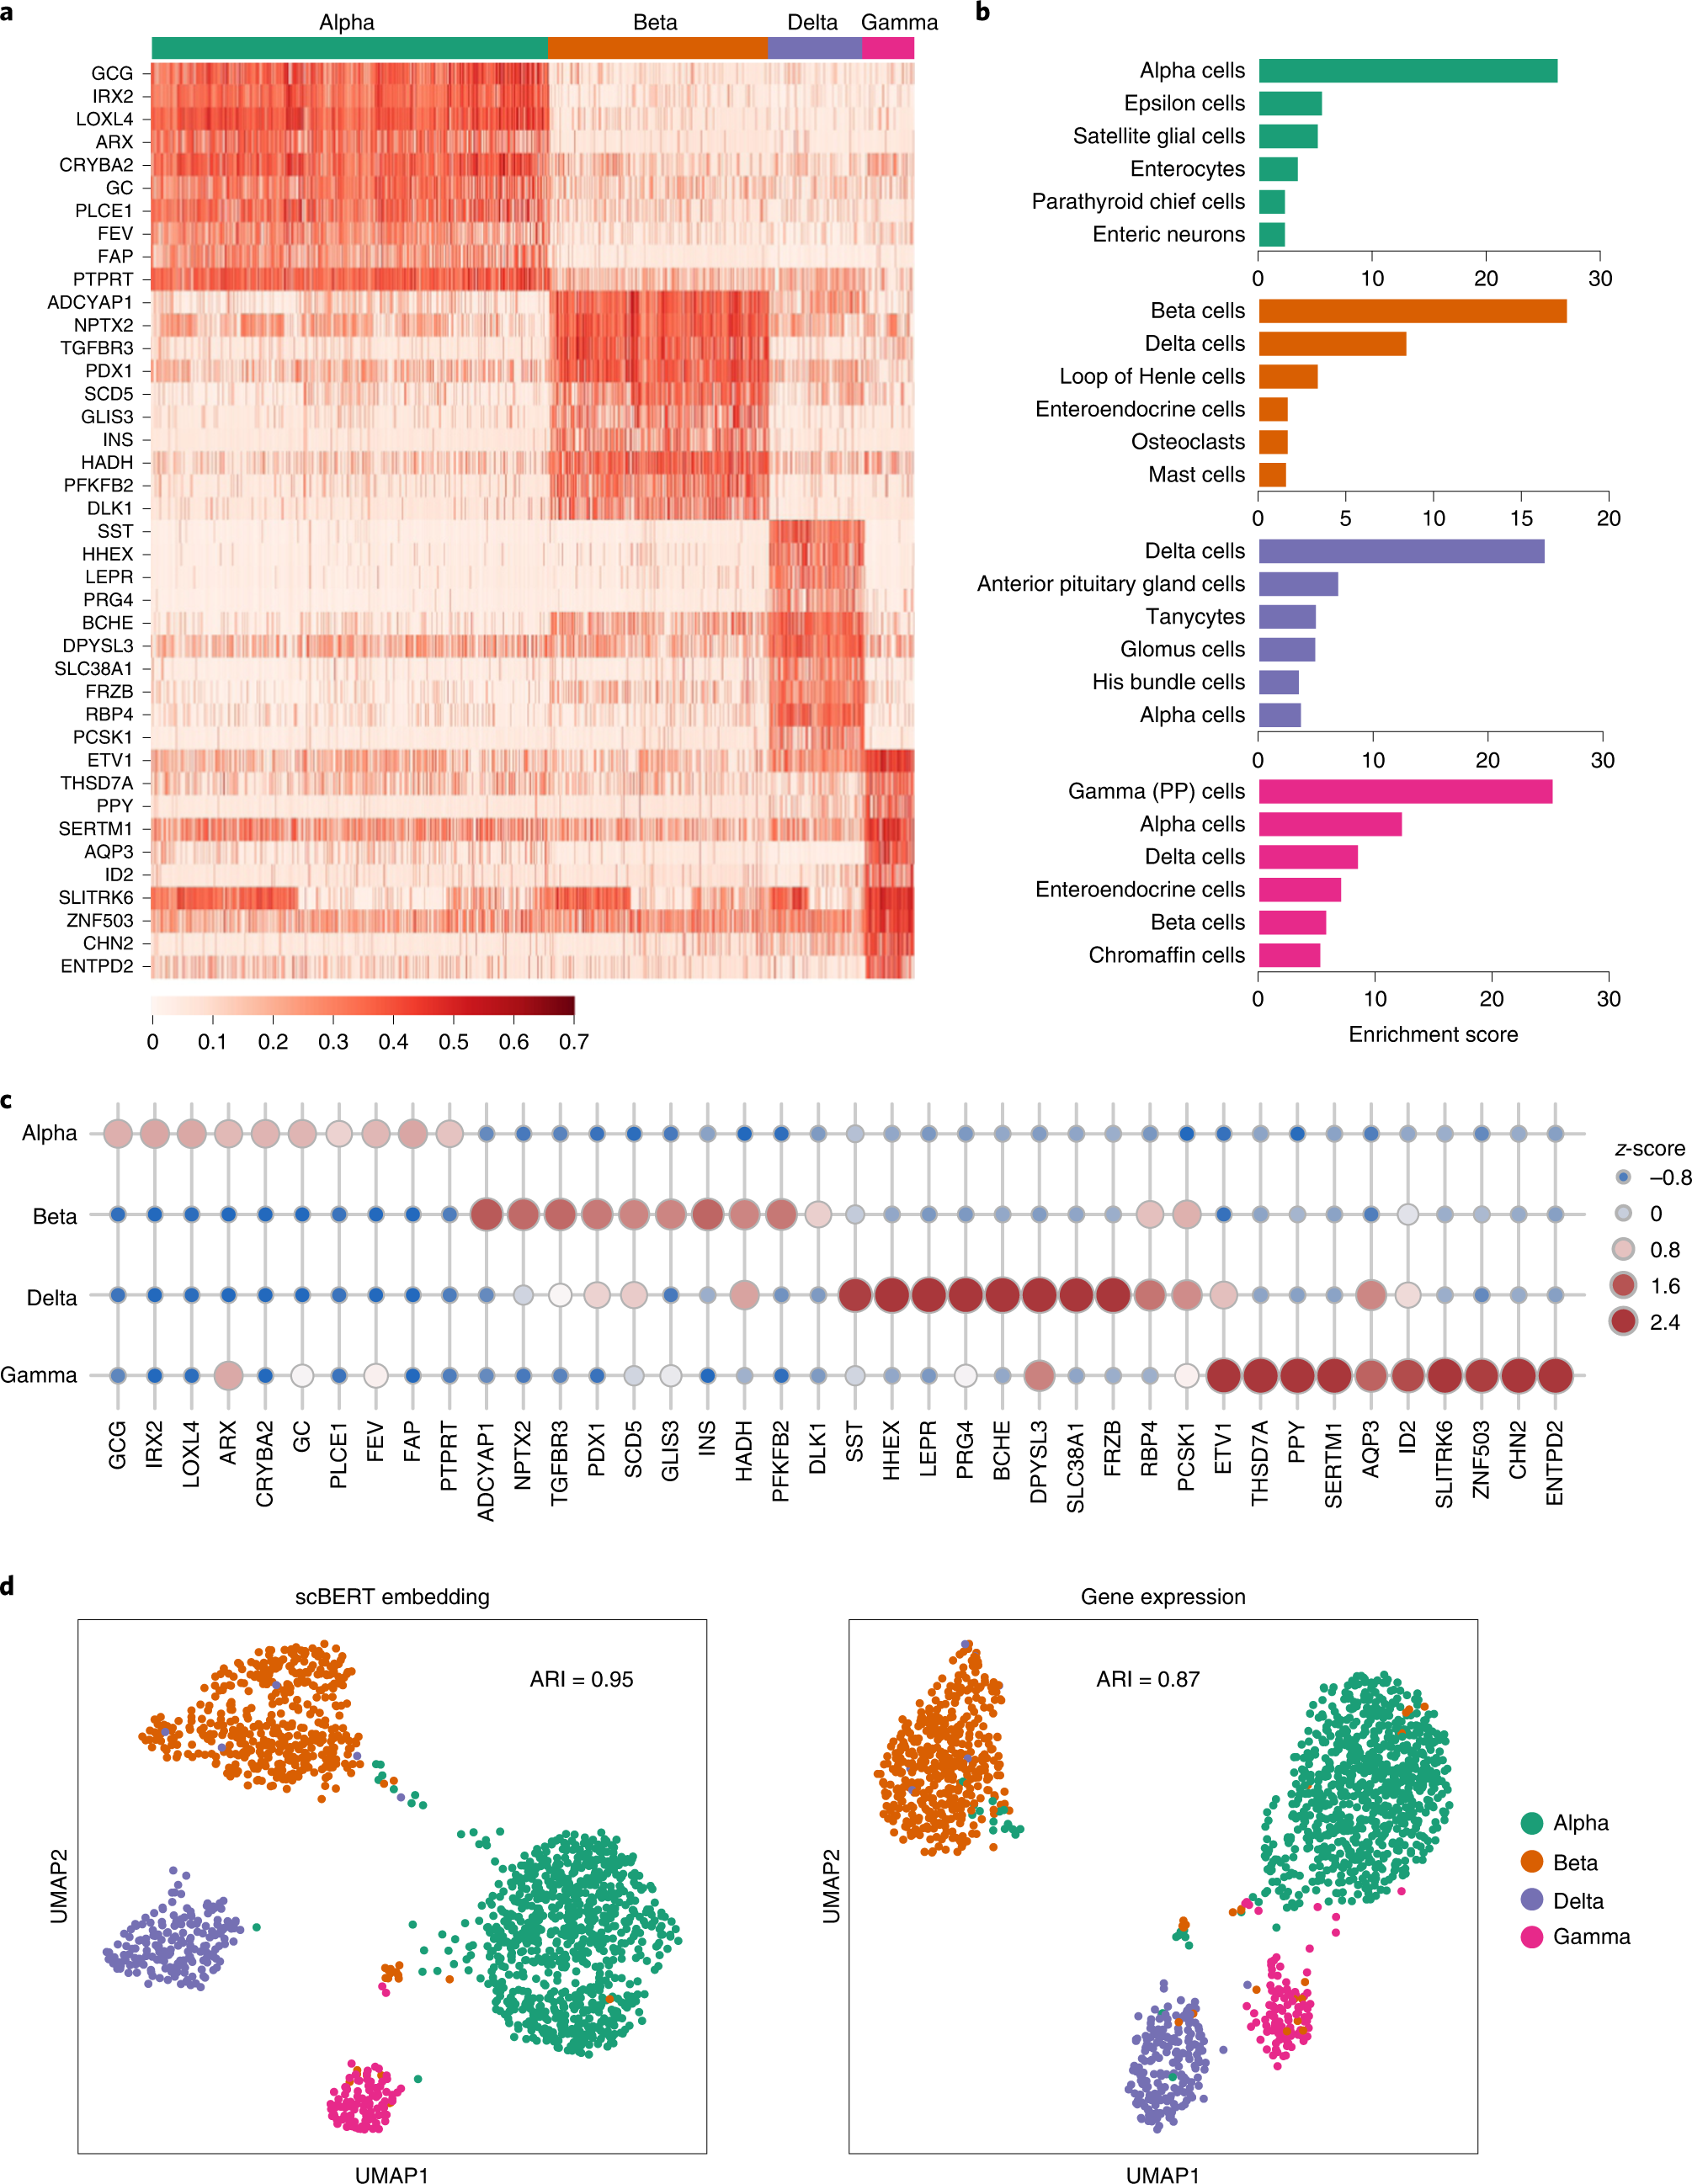 |
 回复此楼
» 猜你喜欢
 PRMT5·MTA 抑制剂 MRTX1719 的科研应用
已经有0人回复
-
SW033291 科研使用解析:分子特征、储存与实验获取要点
已经有0人回复
-
化学工程及工业化学论文润色/翻译怎么收费?
已经有127人回复
-
泛 RAS 抑制新思路:大环肽拟似物如何同时牵住突变型与野生型 RAS?
已经有0人回复
-
TYK2/JAK1 双靶点工具化合物 Brepocitinib:激酶选择性、研究进展与实验应用全解析
已经有0人回复
-
矢车菊素-3-O-葡萄糖苷质控实录:从一张HPLC图谱读懂纯度与稳定性
已经有0人回复
-
恩诺沙星(Enrofloxacin)科研解析:分子特征、LC-MS/MS 检测与实验室使用要点
已经有0人回复
-
Calderasib理化性质与实验操作技术笔记
已经有0人回复
-
RMC-6291怎么用?RAS(ON) 三重复合物工具化合物的实验室实操要点
已经有0人回复
-
苯并呋咱全解析:NBD 荧光衍生化试剂母核的化学特性与实验室应用
已经有0人回复
-
生物质炭与活化剂氢氧化钾混合注意事项
已经有0人回复
» 本主题相关商家推荐: (我也要在这里推广)




 200
