









| 查看: 67 | 回复: 4 | |||
| 【有奖交流】积极回复本帖子,参与交流,就有机会分得作者 peterfxmc 的 1 个金币 ,回帖就立即获得 1 个金币,每人有 1 次机会 | |||
peterfxmc新虫 (小有名气)
|
[交流]
新能源并网仿真:AI实现规程问答与试验报告生成,电磁暂态图形工作站硬件配置方案
|
||

|
新能源并网仿真:AI大模型本地部署实现规程问答与试验报告生成,电磁暂态图形工作站硬件配置方案 起点:一台笔记本和一个并网逆变器 2024年秋,一名电气工程专业的研究生背着一台轻薄本走进实验室。导师给的第一个课题很具体:搭一台三相LCL型并网逆变器的仿真模型,验证一下弱电网条件下锁相环参数对稳定性的影响。MATLAB/Simulink里拖模块、设参数、跑波形,笔记本还能应付;再把模型搬到PSCAD里做电磁暂态验证,一个几微秒步长、跑两秒动态过程的算例,风扇转了一整夜。 那时他觉得,这台笔记本大概能撑过硕士三年。 这个判断错得离谱。因为新能源并网这个方向,计算量的膨胀速度远超大多数人的预期。过去五年,随着风光装机占比不断攀升,研究对象早已从“一台逆变器”变成“一个风电场”,再变成“机-场-群多层级系统”--逆变器、场站、电网、柔直外送通道层层叠叠,每一层都有自己的控制环路和动态特性。仿真规模每上一个台阶,硬件需求就换一种吃法。 技术难点:从单机模型到机-场-群,算力是怎么被吃掉的 第一阶段:单机并网与阻抗建模 并网逆变器接入弱电网时,逆变器控制环路与电网阻抗之间会相互作用,引发宽频振荡。这类问题的经典分析手段是阻抗建模:在并网点注入谐波扰动,扫出逆变器阻抗和电网阻抗的幅频、相频曲线,再用奈奎斯特判据评估稳定裕度。单台逆变器的序阻抗模型推导可以在纸面上完成,但一旦涉及三相不平衡、频率耦合、数字控制延时,解析模型很快失效,必须回到时域仿真里做谐波线性化。 这一步对硬件的第一个要求是CPU单核性能。电磁暂态仿真(EMT)的步长通常在微秒级,求解器逐点推进、严格时序依赖,几乎无法跨核并行。笔记本的散热压不住长时间满载,很快就遇到降频,算例越跑越慢。 第二阶段:场站聚合与批量扫频 硕士中期,课题升级为“多场站接入下的振荡风险分析”。一个新能源基地可能有几十台逆变器、多套SVG、一条柔直外送线路。阻抗扫描要在多个运行工况、多个频率点之间反复调用仿真,单次全频段扫描动辄数千个工况点。这类任务的本质是“海量中小型算例的批量执行”--每个算例不大,但总量惊人。 这一阶段,内存和全核性能开始吃紧。多开几个MATLAB实例并行扫频,内存占用直线上升;几十个工况排队跑,CPU全核频率决定总耗时。笔记本到这里基本趴窝,连开机都卡。 第三阶段:真实研究前沿长什么样 这个方向的真实研究前沿,可以从公开报道里窥见一斑。南京航空航天大学自动化学院陈新教授团队长期从事新能源并网稳定控制研究,其“机-场-群多层级新能源发电系统并网稳定控制与试验关键技术”获得2023年江苏省高等学校科技进步一等奖;2025年,团队“大规模新能源发电系统并网稳定控制与全周期仿真试验关键技术”又获得江苏省电源学会科技进步二等奖。团队发表于弱电网并网逆变器阻抗相角动态控制方向的论文,入选ESI高被引论文。 这些成果背后有一个共同的技术底座:全周期仿真试验。也就是说,仿真不只是在电脑上跑波形,还要覆盖“建模-离线仿真-实时仿真-硬件在环”的完整链条。机-场-群层级的电磁暂态模型,网络节点数动辄上万,波形数据以TB计;硬件在环(HIL)要求仿真步长严格小于实时,算力余量不够就直接失步。课题组多人共用时,排队时间甚至比计算时间还长。 算力需求不会线性增长,它会指数级跳变。 AI大模型本地部署:并网研究的第二台发动机 仿真之外,并网方向的科研还有大量“文字密集型”工作:查阅并网技术标准与规程、整理试验记录、撰写仿真报告、调试控制代码。这两年,本地部署开源大模型已经成为不少课题组的效率工具,原因有三。 其一,数据出不去。并网仿真实验数据常涉及电网运行参数或企业委托项目,并网规程、试验报告更是敏感文档,上传云端API存在合规风险,本地部署才能闭环。其二,长期成本低。一个课题组每天几百次调用,按量付费的API账单一年下来并不便宜,本地一次投入、长期可用。其三,离线可用。实验室、现场试验站网络条件不可控,本地模型随叫随到。 模型选型上,两档组合比较务实。轻量级选Qwen3-14B(140亿参数),负责并网规程问答、仿真报告初稿生成、MATLAB与PSCAD脚本辅助;推理增强档选GLM-4.5-Air,智谱开源的MoE架构模型,总参数1060亿、激活参数120亿,擅长多文档比对与长链路分析,适合把几十页的技术标准、试验大纲、历史报告放在一起交叉核查。 显存估算有个简单公式: 所需显存 ≈ 参数量(B) × 量化字节数 × 1.2 FP16为2字节/参数,Q8为1字节,Q4为0.5字节,系数1.2预留给KV cache和系统开销。照此估算: 模型 FP16 Q8 Q4 Qwen3-14B 约34 GB 约17 GB 约9 GB GLM-4.5-Air(106B MoE) 约254 GB 约128 GB 约64 GB 注意MoE的特殊性:显存按总参数量计算,激活参数再小也省不了显存,省的是算力。GLM-4.5-Air哪怕每次只激活120亿参数,Q4量化后依然要占约64 GB显存,单张消费级显卡装不下,需要96 GB级专业计算卡才从容。Qwen3-14B则友好得多,Q4约9 GB,算上长文档的上下文余量,16 GB显存即可舒适运行。 量化等级上,FP16无损但显存翻倍,Q8几乎无损,Q4的精度损失在日常问答和报告生成场景几乎无感,是消费级部署的默认选择。速度量级同样关键:纯CPU推理(靠内存跑)通常只有个位数tokens/s,单卡GPU则能达到几十到上百tokens/s,体验完全是两个世界--这正是仿真工作站区别于普通电脑的分水岭。 最后区分微调与推理。LoRA轻量化微调14B级模型,显存增量约3~5 GB,入门显卡也能做领域适配;全参数微调哪怕7B模型也要80 GB以上显存--这是“推理机”和“训练机”的分水岭,直接决定配置档位能否上探。 主要软件工具链 并网方向的工作流是一环扣一环的,每一段都有对应的软件。 PSCAD/EMTDC:电磁暂态仿真的主力,微秒级步长、严格时序,吃CPU单核与全核性能,是宽频振荡和暂态过电压分析的核心平台。 MATLAB/Simulink:控制策略设计、阻抗建模、扫频批处理与数据分析的通用底座,多实例并行时对内存容量敏感。 PSASP / DIgSILENT PowerFactory:机电暂态与大电网潮流计算,适合场站级、区域级系统研究。 RT-LAB / OPAL-RT类实时仿真平台:硬件在环试验的载体,要求仿真步长稳定小于实时,对整机持续算力和IO延迟都是硬约束。 Python生态:波形后处理、试验数据管理、以及调度本地大模型做报告生成,是串联整条流水线的胶水。 UltraLAB配置推荐:按成长阶段对号入座 带学生的老师都知道,实验室那台老机器一到毕业季就排队,跑个场站级算例要等两三天,学生急得直跳脚。与其让大家抢一台顶配,不如按研究方向和课题阶段拆成几套不同定位的配置。下面这张表,是按前面讲的计算类型--电磁暂态、阻抗扫频、硬件在环、本地大模型--分别梳理的参考方案,你可以根据自己所处的阶段对号入座。 方案A:入门档--课程算例与单机并网研究 适用场景:单逆变器/单场站电磁暂态仿真、MATLAB建模与课程级算例、轻量化AI辅助(依赖内存推理)。 推荐机型:A350 156128-MCA 价格区间:5~6万 CPU:Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷(全核超频实测优化频率) GPU:Quadro T400 内存:128GB DDR5 存储:4TB NVME (14GB/s) 显存带宽:80.00 GB/s 方案B:进阶档--场站级仿真与AI推理 适用场景:多场站阻抗批量扫频、宽频振荡分析、PSCAD大算例,本地部署Qwen3-14B做规程问答与报告生成,GLM-4.5-Air量化推理。 推荐机型:AX430 127128-MCF 价格区间:16~17万 CPU:Xeon金牌6530 32核2.7G(全核超频实测优化频率) GPU:RTX Pro 6000 96GB 内存:128GB DDR5 存储:4TB NVMe 显存带宽:1.79 TB/s 方案C:课题组公用档--全周期仿真试验与私有模型服务 适用场景:机-场-群多层级电磁暂态仿真、硬件在环试验、多人并发提交任务、本地大模型共享服务与长期知识库问答。 推荐机型:GX660M 227512-MD3F 价格区间:49~50万 CPU:2×Xeon金牌6530 64核2.7G(全核超频实测优化频率) GPU:3×RTX Pro 6000 96GB 内存:512GB DDR5 存储:8TB NVMe 显存带宽:1.79 TB/s(单卡) 方案D:平台档--区域级大电网与长期算力基建 适用场景:新能源基地全电磁暂态仿真、多年数据积累与波形库管理、课题组私有算力平台与多节点协同。 推荐机型:分布式集群 8.6 科学计算通用型 价格区间:79~80万 计算节点: CPU:2颗AMD霄龙9575F(128核4.5GHz) / Ultra9 285K(8核 5.6GHz)(全核超频实测优化频率) GPU:RTX4090D / RTX A4000 内存:768GBDDR5 / 64GB DDR5 存储:2TBNVME / 2TB NVME 显存带宽:RTX4090D 1.01 TB/s / RTX A4000 448.0 GB/s(单卡) 存储管理节点: CPU:2颗Xeon银牌 4310(24核) 内存:192GB DDR4 存储:126TB存储 如果他们一开始就知道这些 回看整个成长路径,几乎每个节点都有本可以避免的弯路。 内存一次配够。阻抗扫频要同时开多个MATLAB和PSCAD实例,内存不足时系统开始swap,速度断崖式下跌。加内存是最便宜的升级,但也是最常被拖到最后才做的升级。 别只看核心数。电磁暂态仿真吃全核频率,主频每高一点,两秒动态过程的算例就省一截时间。买机器前先弄清自己的主力软件瓶颈在单核、多核还是显存。 硬件在环按峰值配。HIL仿真要求步长严格小于实时,按“平均负载”配的机器,遇到故障暂态过程立刻失步。实时性场景永远要留余量。 存储IO别拖后腿。机-场-群仿真的波形数据以TB计,机械硬盘写入会卡住后处理环节,系统盘和数据盘要分开规划。 AI部署早做打算。等课题做到报告自动化阶段才发现显存不够,面临的可能是整机更换而不是加一张卡。 常见问题 电磁暂态仿真到底吃CPU还是GPU? PSCAD这类EMT工具的主求解器是时序推进的,几乎无法并行,瓶颈在CPU单核与全核频率;GPU只在部分加速模块和后处理里派上用场。所以入门和进阶档把钱优先花在CPU和内存上,比堆显卡更对路。 笔记本加装内存能不能撑过硕士阶段? 如果只做控制策略验证和小算例,可以撑;一旦进入多场站阻抗扫描或硬件在环,散热和持续满载能力就是硬伤。笔记本的设计目标是便携和短时峰值性能,不是7×24小时的仿真负载。 课题组已经有服务器,还需要工作站吗? 两者是互补关系。服务器适合机房集中调度,工作站适合工位级的日常建模、调试和实时仿真--尤其是HIL场景,对IO延迟敏感,工位旁的就近部署往往更稳。 本地部署大模型和调用云端API怎么选? 看数据性质。公开的、脱敏的知识问答用API没问题;涉及电网参数、试验报告、委托项目数据的场景,本地部署是合规前提。长期高频调用下,本地部署的总成本也更低。 配置应该一步到位还是分批升级? 平台型机器(方案C及以上)建议一步到位,因为主板、电源、散热的升级空间在出厂时就定了;入门档可以先满足当下需求,给内存和显卡留好升级口子。 结语 新能源并网的仿真需求,从一台逆变器到一个基地,再到机-场-群多层级系统,每一步升级都在考验算力储备。那位当年背着笔记本进实验室的研究生,后来博士课题做到了多场站宽频振荡抑制--他的算力路线,也按计划从入门档一路走到了课题组公用平台。算力规划的本质,是给未来的课题留出余地:机器会过时,但好的平台能撑过好几届学生的毕业周期。 UltraLAB专业图形工作站定制 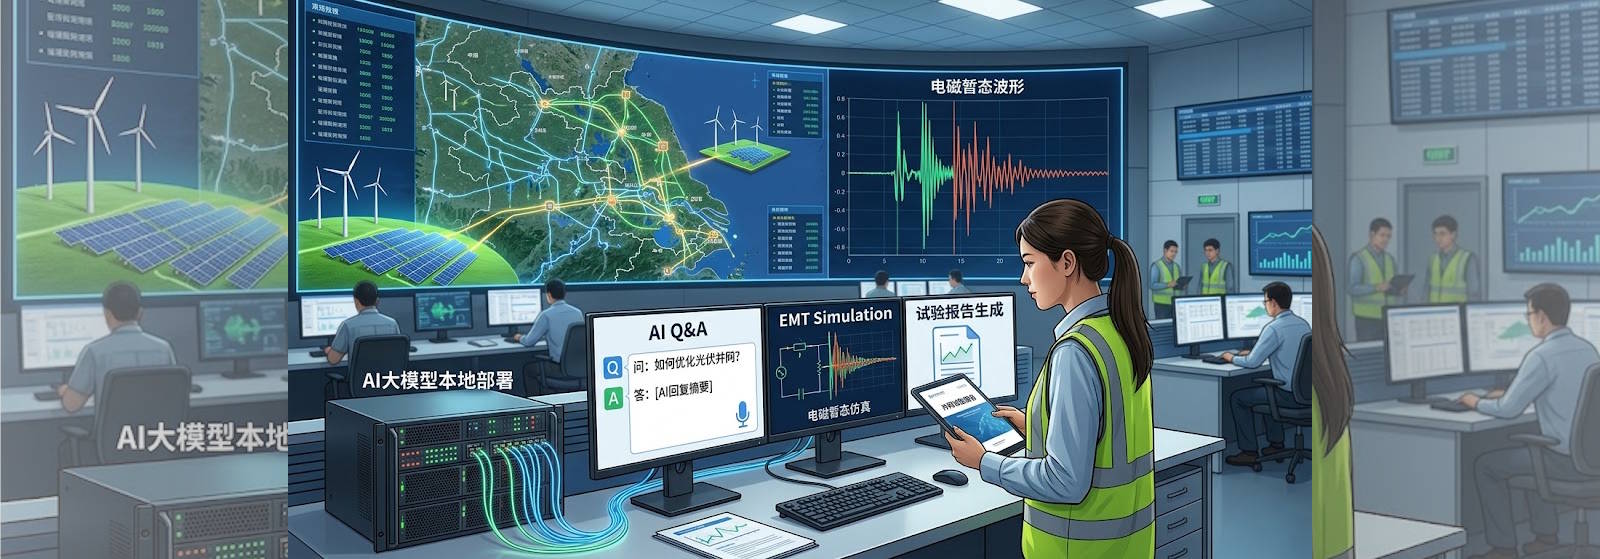 |
 回复此楼
» 猜你喜欢
 售SCI一区T0P文章,我:8.O.55.1.O.5.4,科目全,可+急
已经有7人回复
-
售一区SCI文章T0P,我:8O.551.O54,科目全,可十急
已经有6人回复
-
售SCI一区T0P文章,我:8.O55.1.O.54,科目全,可十急
已经有6人回复
-
售SCI一区文章,我:8O5.5.1.O5.4,科目全,可伽急
已经有7人回复
-
售SCI一区T0P文章,我:8.O55.1.O.54,科目全,可十急
已经有5人回复
-
售SCI文章,我:8O.5.5.1O.54,科目全,可十急
已经有5人回复
-
售SCI一区T0P文章,我:8O.55.1.O.5.4,科目齐全,可+急
已经有6人回复
-
售SCI一区T0P文章,我:8O.55.1.O.54,科目全,可伽急
已经有4人回复
-
售SCI一区T0P文章,我:8.O.55.1.O54,科目全,可伽急
已经有7人回复
-
售SCI文章,我:8O5.5.1.O.54,科目齐全,可+急
已经有6人回复
» 抢金币啦!回帖就可以得到:
-
2026年人文教育与社会发展国际会议(HESD 2026)
 +1/886
-
求助DL 5009.1-2014
规程 第1部分:火力发电》
+1/487
-
沈阳工业大学 环境电化学技术研究团队 招收硕士研究生(学硕/专硕)
+2/84
-
爱丁顿实验
+1/36
-
细胞检定样品,您用对了吗?
+1/3
-
委托检验的安全锁:质量保证协议,你签了吗?
+1/3
-
CAHSS(艺术、人文与社会科学国际会议)
+1/2
-
ICoEP(教育与心理学国际会议)
+1/2
-
ICoAAD(建筑、艺术与设计)
+1/2
-
GCHSD(全球文化遗产可持续发展大会)
+1/2
-
仪器验证全生命周期管理:检测数据精准与否的前提
+1/2
-
智能传感器网络实时数据处理:时序分析、DNN调度与MQTT边缘AI工作站配置
+1/1
-
清华大学-区域环境安全全国重点实验室招聘地下水科学/水文地质方向助理研究员/副研究�
+1/1
-
ICoFEE(林业、生态与环境)
+1/1
-
单细胞VDJ测序:从B细胞库中精准挖掘抗体药优势克隆
+1/1
-
CoIMCT(信息、媒体与通信技术)Informatics, Media and Communication Technology
+1/1
-
ECNLPIR(自然语言处理与信息检索)
+1/1
-
ECSFS(能源、气候与可持续发展峰会)
+1/1
-
CoEES(能源与地球科学)2027 International Conference on Energy and Earth Science
+1/1
-
新能源并网仿真:AI实现规程问答与试验报告生成,电磁暂态图形工作站硬件配置方案
+1/1
简单回复
宁静致远sy2楼
2026-10-10 16:29
回复
ckxbear3楼
2026-10-10 17:00
回复
peterfxmc(金币+1): 谢谢参与

2026-10-10 19:32
回复
peterfxmc(金币+1): 谢谢参与
2026-10-10 21:00
回复
peterfxmc(金币+1): 谢谢参与