









| 查看: 13027 | 回复: 6 | |||
| 当前只显示满足指定条件的回帖,点击这里查看本话题的所有回帖 | |||
[求助]
画系统发育树时bootstrap value很低的原因是什么? 已有1人参与
|
|||

|
本人是用已知序列在NCBI上找了相似度基本都在97%以上的菌株,调方向之后用CLUSTAL W对序列进行ALIGN,ALIGN后删掉了序列的头尾,基本不存在gap了。但是用MEGA5.0画树的时候,bootstrap value依旧会很低,大部分在10—20之间。 在论坛上看见有大神说这种情况是因为序列相似度太高导致的,但是不应该相似度越高代表具有同源性的可能性越大吗?而且我的树上少部分bootstrap value会高达80以上,我看他们的相似性也在97%以上啊,又为什么会出现这种情况呢? 下面两幅图都是同一棵树上的。。。 求助各位虫子了! 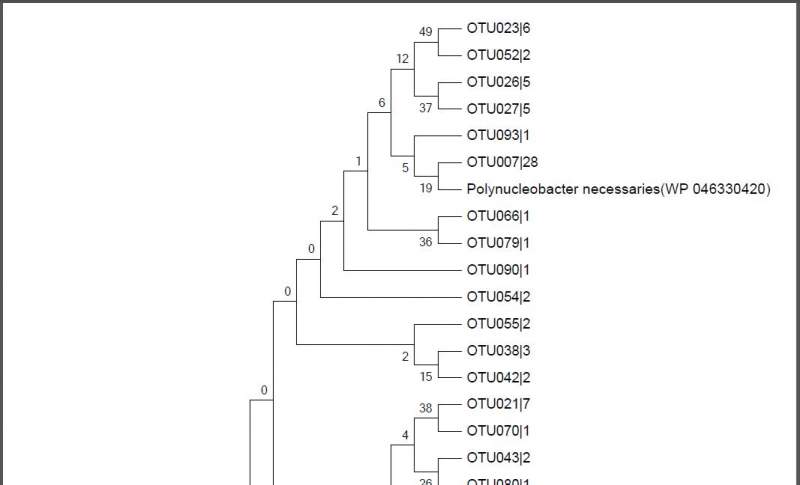 1.jpg 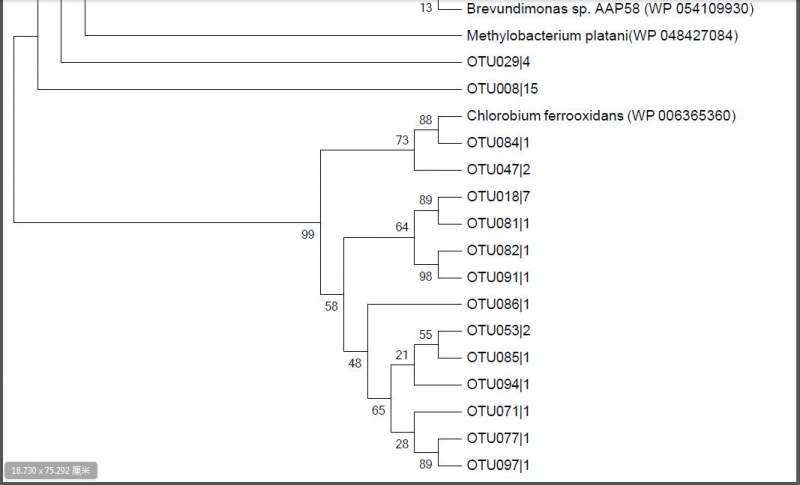 2.jpg |
 回复此楼
» 收录本帖的淘帖专辑推荐
 生物软件学习 |
» 猜你喜欢
 TYK2/JAK1 双靶点工具化合物 Brepocitinib:激酶选择性、研究进展与实验应用全解析
已经有0人回复
-
矢车菊素-3-O-葡萄糖苷质控实录:从一张HPLC图谱读懂纯度与稳定性
已经有0人回复
-
化学工程及工业化学论文润色/翻译怎么收费?
已经有147人回复
-
恩诺沙星(Enrofloxacin)科研解析:分子特征、LC-MS/MS 检测与实验室使用要点
已经有0人回复
-
Calderasib理化性质与实验操作技术笔记
已经有0人回复
-
RMC-6291怎么用?RAS(ON) 三重复合物工具化合物的实验室实操要点
已经有0人回复
-
苯并呋咱全解析:NBD 荧光衍生化试剂母核的化学特性与实验室应用
已经有0人回复
-
生物质炭与活化剂氢氧化钾混合注意事项
已经有0人回复
-
科研人必读:新一代 KRAS G12C 抑制剂 Olomorasib 的研究进展
已经有0人回复
-
BT-11(Omilancor)研究化合物全解析:从分子结构到实验应用要点
已经有0人回复
-
富马酸贝达喹啉:二芳基喹啉类工具化合物的化学特征
已经有0人回复

3楼2015-11-23 08:10:32
2楼2015-11-22 23:52:38
【答案】应助回帖
|
no.no可能你理解的有偏差。。首先说一下,为什么是因为序列高度同源导致的,在建立系统发育关系的时候并不是同源性越高越好,这取决于你分子数据差异度,建树是实质上就是一类聚类分析,把相似性高的聚在一起,把相似性低的按照差异度排列远近关系,中间又不同于一般性的聚类分析,尤其是mega这个软件,它定义树枝都是二元制的,也就是不管序列的相似性多高,它都默认的按照二元分法给你分下来,这样就会导致一个结果,如果序列的差异性正好合适,那么算出来的树就会很好,如果序列的差异性不合适,那么算出来的树就会有很大的误差。另外,Bootstrap方法不等于序列同源度水平,不是同源度水平高就Bootstrap value就很高,他们之间没有任何必然的联系,Bootstrap 方法是自举法,或者也叫自助法,是一种有放回的抽样方法,树枝中间的数值是Boostrap的统计数值,也就是两次计算他们的聚类都聚在一块这就是2,三次都聚在一块都是3,以此类推,如果1000次 bootstrap有1000次在二元分法情况下A和B都聚在一块他们就是1000,换算成百分制就是100,如果是1000次只有200次聚在一块,那就是200换算成百分制就是20,这也就是bootstrap支持率的原理,明白了这个,就很好解释你序列中为什么同源性高,但是bootstrap value很低了,因为A、B和C序列的关系太近了,差异性太小了,A和B聚在一起或者跟C聚在一起,软件都会默认成有效的,有统计价值的,无法分辨出他们真正的系统发育关系。这样在抽样放回,在抽样的时候,尤其是很多个序列差异度都非常小的情况下,每一次A和B真正能聚在机会其实是很小的。这就是你结果跟你期望不符的原因。 另外,我是做脊椎动物系统发育关系的,我们选择的建树,并不在mega上建的(可以搜下相关系统发育文章,一般是没有在mega上建树的),我们一般是在其他软件,用最大似然法或者贝叶斯法构建,具体的你要搜文章看了,在种水平下,我们一般是群体遗传学的研究范围了,我建议你如果只是鉴别菌株,确定是否构建好重组DNA的序列话,并不一定要建树的。 |

4楼2015-11-24 13:51:58
6楼2015-12-16 21:59:11