









| 查看: 10 | 回复: 0 | |||
| 【有奖交流】积极回复本帖子,参与交流,就有机会分得作者 君录生物 的 5 个金币 ,回帖就立即获得 1 个金币,每人有 1 次机会 | |||
[交流]
bioRxiv|Stack:上下文学习如何重塑单细胞基础模型
|
|||

|
▍导读 2026年6月8日,Arc Institute 等团队在 bioRxiv 发布 Stack v2:它在 149 million human single cells 上预训练,用表格注意力让每个细胞的表征由所在细胞集合(上下文)决定。经自蒸馏后训练后,Stack 可用「细胞提示」预测未见条件下的表达谱,并在 31 项上下文学习评测中有 28 项排名第一。v2 生成的 Perturb Sapiens 扩展至 28 组织、40 细胞大类、892 种药物、细胞因子和遗传扰动,并新增 DiseasePert-3M(来自 40 位供体、覆盖 14 种疾病、经 11 种细胞因子刺激的 T 细胞)对供体特异性响应进行验证。 ▍研究背景 单细胞转录组测序已在物种、疾病与各类生物条件上刻画细胞表型的多样性,公开数据规模已达数亿细胞量级,为单细胞基础模型提供了自监督学习所需的海量素材。 但现有单细胞基础模型多把每个细胞独立建模:预训练目标停留在单细胞层面,把模型训练成通用去噪器,能看到基因间依赖却看不到群体尺度的状态偏移;叠加基因表达计数本身的高噪声,缺乏跨细胞的信息聚合,表达模式的信噪比难以提升。 同时,这类模型通常依赖在有限数据上做任务特定的微调,而不是像大语言模型那样在推理时进行稳健的上下文学习,因此难以在未见过的生物条件或全新任务上完成无监督发现。 ▍研究方法 Stack 是一个自监督的编码器-解码器模型,以「细胞集合」为输入单元,通过改造的表格注意力同时建模胞内与胞间信息流;研究从预训练、后训练到下游评测构建了完整链路: 预训练数据与目标:在 scBaseCount 的 148.8 million cells(19,978 个 SRX 样本)上预训练,用矩形掩码任务遮蔽全部细胞的同一批基因并重建表达分布,掩码比例取自均匀分布以防简单填充。 基因模块 token 化:用单层感知机把表达向量投影为固定 100 个可训练的「基因模块 token」,不依赖外部基因语义信息,让模型隐式学出有生物学意义的基因分组。 表格注意力骨干:每个 block 依次堆叠胞内多头注意力、胞间多头注意力与逐 token 前馈网络,并施加分布正则以逼近非线性潜变量模型的线性可辨识条件。 自蒸馏后训练:后训练数据按原文为 approximately 55M cells;将细胞集合按细胞类型分成 prompt 与 target,用另一条件的同类型 query 细胞替代 target,以教师-学生自蒸馏在嵌入与表达空间做分布对齐,实现「细胞提示」。 评测体系:发展探针与整合两套评测(逐细胞类型线性/MLP 探针、scIB),并在观测与扰动数据上系统比较零样本、微调与从头训练基线。 ▍核心发现 1、用「细胞集合」取代「单个细胞」:表格注意力让表征带上上下文 研究提出 Stack,一个以「细胞集合」而非单个细胞为输入单元的单细胞基础模型,把每个细胞的上下文定义为其所在集合中的其余细胞。 其核心是新的表格注意力块:先在单个细胞内对基因模块 token 做胞内多头注意力,再在细胞集合维度做胞间多头注意力,叠加逐 token 前馈网络,并用分布正则以逼近潜变量的线性可辨识条件。 在 scBaseCount 的 148.8 million cells 上预训练后,Stack 无需针对测试数据微调即可输出细胞嵌入与表达,成为后续零样本分析与「细胞提示」任务的主干。(图 1) 《Stack:利用细胞上下文增强表征的单细胞基础模型(模型总览)》 · 原文 Figure 1 · Dong et al., 2026, bioRxiv v2 · 模型架构示意图 A 为数据与应用总览;B 为胞内/胞间表格注意力骨干;C 为推理时的 prompt–query 上下文学习;D 展示不同唯一细胞数量下的验证集重建损失;E 为基因模块 token 的 GO 富集。 2、零样本嵌入在疾病/状态探针与批次整合上全面领先 研究用探针与整合两套框架评估 Stack 嵌入:前者以线性/MLP 探针预测疾病、生理状态与细胞类型,后者用 scIB 指标衡量细胞类型保留与批次校正。 在五套观测数据集(肾、淋巴结、脑、肺及 Tabula Sapiens)上,Stack 在疾病与其他状态分类的探针得分普遍领先;将细胞跨供体打乱、破坏原有细胞上下文后,其表现显著下降,说明增益来自对上下文信息的提取。 在四套扰动数据上 Stack 全面胜出,且是唯一稳定优于「从头训练 scVI」的方法;在 Tabula Sapiens 的 26 个组织中,Stack 在 22 个组织中表现最佳,批次整合能力在训练中并未被显式要求。(图 2) 《Stack 嵌入的评测:疾病/状态探针与跨样本整合》 · 原文 Figure 2 · Dong et al., 2026, bioRxiv v2 · 条形图与评分图 D/E 比较观测与扰动数据的逐细胞类型探针;F 给出 Tabula Sapiens 各组织的 scIB 总分。蓝色 Stack 条形多数领先。 3、自蒸馏后训练解锁「细胞提示」,实现扰动的上下文学习 为让模型在推理时听懂「指令」,研究定义了由 prompt 与 query 两类细胞组成的细胞条件任务:prompt 指明目标状态或条件,query 指明感兴趣的细胞类型,模型据此预测 query 的反事实表达谱。 后训练采用自蒸馏:把同一样本细胞按类型分为可见的 prompt 与留出的 target,再用另一条件的同类型 query 细胞替代 target,学生模型在嵌入与表达空间对齐教师模型,教师参数按学生参数的指数滑动平均更新。 推理时由 MLP 分类器给出置信度并驱动掩码扩散式的迭代精修。作为零样本方法,Stack 在 31 项上下文学习评测中 28 项第一,且在 OpenProblems 未见药物等数据上仍保持优势。(图 3) 《Stack 的后训练:面向上下文细胞提示任务》 · 原文 Figure 3 · Dong et al., 2026, bioRxiv v2 · 流程图与评分条形图 A 展示自蒸馏后训练框架;B 为后训练数据构成;C–H 覆盖扰动型、观测型与混合型上下文学习任务及其评分。 4、生成首个全人扰动细胞图谱 Perturb Sapiens 研究以 90 种细胞因子、136 种药物和 666 种遗传扰动的 PBMC 数据作为 prompt,以组织平衡后的 Tabula Sapiens 作为 query,用上下文学习生成 Perturb Sapiens。 图谱覆盖 28 个组织、40 个细胞大类与 892 种扰动,每种条件包含 513,870 个计算生成的细胞表达谱。Perturb Sapiens 是 Stack 生成的 AI 预测图谱,不是 892 种条件均经全身湿实验实测,具体结论仍需实验验证。 图 4 展示了图谱构建流程、代表性细胞因子 ADSF 的 UMAP、IFN-γ 响应热图、大肠上皮细胞的 GO 富集,以及 60,470 个扰动效应的独立成分分解,用于查看扰动模态、组织和细胞大类特异的信号。(图 4) 《Perturb Sapiens:全人扰动细胞图谱的构建与全局分析》 · 原文 Figure 4 · Dong et al., 2026, bioRxiv v2 · UMAP、扰动响应热图、GO 富集与 ICA 分解 A 为 892 种扰动的图谱构建与组织组成;B 为 ADSF 条件下的组织/细胞类型 UMAP;C 为 IFN-γ 响应热图;D 为大肠上皮的 GO 富集;E 为全图谱扰动效应的 ICA 分解。 5、基因模块 token 让模型自学报出功能一致的基因分组 Stack 把每个细胞的表达向量投影成固定 100 个可训练的「基因模块 token」,token 数远少于基因数,模型必须自行学出有意义的基因分组才能保住生物学信息。 由于 token 化模块与模型端到端训练、且不依赖任何外部基因语义信息,这些分组完全由数据驱动;研究称其为首个在基因模块层级引入可训练 token 化的单细胞基础模型,同时带来显著的可扩展性收益。 在按 token 化权重排序的每个模块前 10 基因中,526/699(75.3%)只出现在唯一一个 token 里,尽管模型未施加任何显式稀疏约束;基因集富集分析进一步显示这些 token 在功能上高度一致。 《基因模块 token 的 GO Biological Process 富集》 · 原文 Figure 1E 高清裁切 · Dong et al., 2026, bioRxiv v2 · GO 富集热图 横轴为通路,纵轴为 Stack 基因模块 token;颜色表示调整后 p 值的 −log10。对角块状富集说明不同 token 学到了相对专一、功能一致的基因模块。 ▍核心结论速览 - Stack 以细胞集合为输入,用表格注意力让表征带上上下文。 - 149 million human single cells 预训练,零样本嵌入在探针与整合上领先。 - 自蒸馏后训练解锁「细胞提示」,31 项上下文学习评测 28 项第一。 - 生成全人扰动预测图谱 Perturb Sapiens,覆盖 28 组织、40 细胞大类、892 种扰动;v2 新增 DiseasePert-3M 供体特异性响应验证。 - 基因模块 token 自学报出功能一致的基因分组,75.3% 专一。 ▍研究意义 科学价值:把「细胞集合」与表格注意力引入单细胞基础模型,证明跨细胞的上下文聚合能在零样本下超过对目标数据微调甚至从头训练的模型,为理解细胞群体尺度的状态偏移提供了新的建模范式。 研发与转化研究价值:无需为每个新条件微调模型,即可以细胞 prompt 预测未见组合下的细胞状态,有助于为难以实验扰动的细胞类型生成待验证假设;但这些结果是计算预测,不能替代湿实验或临床证据。 ▍局限与下一步方向 作者指出四类局限:模型仅在人类单细胞数据上训练,扩展到多物种需在 token 化环节处理跨物种基因错位;对罕见细胞类型与弱扰动效应的概率校准尚待建立;信号级联会引入时间依赖或次级扰动效应(如 TNF-α),可能增加预测解读的难度;模型主要在后训练的体内细胞类型(尤其免疫细胞)上优化,若要泛化到体外扰动与体内观测数据,需要更精细的数据整理与对齐方案。 ▍FAQ Q:Stack 与其他单细胞基础模型(如 scGPT、UCE)的核心区别是什么? 多数模型把每个细胞独立编码,预训练目标停留在单细胞层面;Stack 以细胞集合为输入,用胞内与胞间两层注意力让每个细胞的表征由集合中其他细胞共同决定,因而能在推理时利用上下文,并在零样本任务上稳定优于从头训练或微调的基线。 Q:什么是「细胞提示」(cell prompting)? 它把两类细胞作为输入:prompt 细胞指定想要的条件(如药物扰动或某供体状态),query 细胞指定感兴趣的细胞类型,模型据此预测 query 在该条件下的反事实表达谱,全程不需要扰动标签、细胞类型编码或测试样本自身的对照。 Q:Perturb Sapiens 是什么,为什么重要? 它是 Stack 通过上下文学习生成的全人扰动预测图谱,v2 覆盖 28 个组织、40 个细胞大类与 892 种药物、细胞因子和遗传扰动,每种条件含 513,870 个计算生成的细胞表达谱。这些是 AI 预测而非所有条件的全身湿实验实测,文中只对其中子集做了独立数据验证,使用时仍需实验复核。 Q:这项工作的主要限制是什么? 作者提到模型仅训练于人类数据、跨物种需改造 token 化;罕见细胞类型与弱扰动效应的校准尚未建立;信号级联带来时间依赖与次级效应;且后训练偏重体内免疫细胞,泛化到体外刺激与体内观测数据仍需更好的数据整理与对齐。 ▍君录视角 · 虚拟细胞 解决的问题:现有单细胞基础模型普遍把细胞独立编码、预训练目标停留在单细胞层面,导致零样本能力弱、必须依赖任务特定的微调,难以在未见条件或新任务上做发现。Stack 用「细胞集合+表格注意力」把每个细胞的表征建立在与同伴细胞的相互参照上,并以自蒸馏后训练引入「细胞提示」,让模型能仅凭细胞本身推断扰动、供体等条件对目标细胞群的影响。 集成判断:Stack 的关键增量在于把「跨细胞的信息聚合」做成了推理时可用的通用机制——胞内与胞间两层注意力将表达压缩为基因模块 token,并由解码器重建基因级表达,后训练的 prompt/query 结构又把它变成可插拔的条件生成接口;这套「预训练表征层+上下文条件层」的骨架,对虚拟细胞方向从观测图谱走向可计算的反事实模拟具有直接的复用价值。 ▍原文信息 Dong M, Adduri A, Gautam D, et al. Stack: In-Context Learning of Single-Cell Biology. bioRxiv. Version 2, posted June 8, 2026. doi:10.64898/2026.01.09.698608 ▍关于君录 君录生物 · 以数据驱动创新药早期开发 单细胞数据库HeCellAstra 和生信分析平台IntelliCytoPilot 做靶点发现与药物管线早期资产 合作 · 投资 · 学术交流 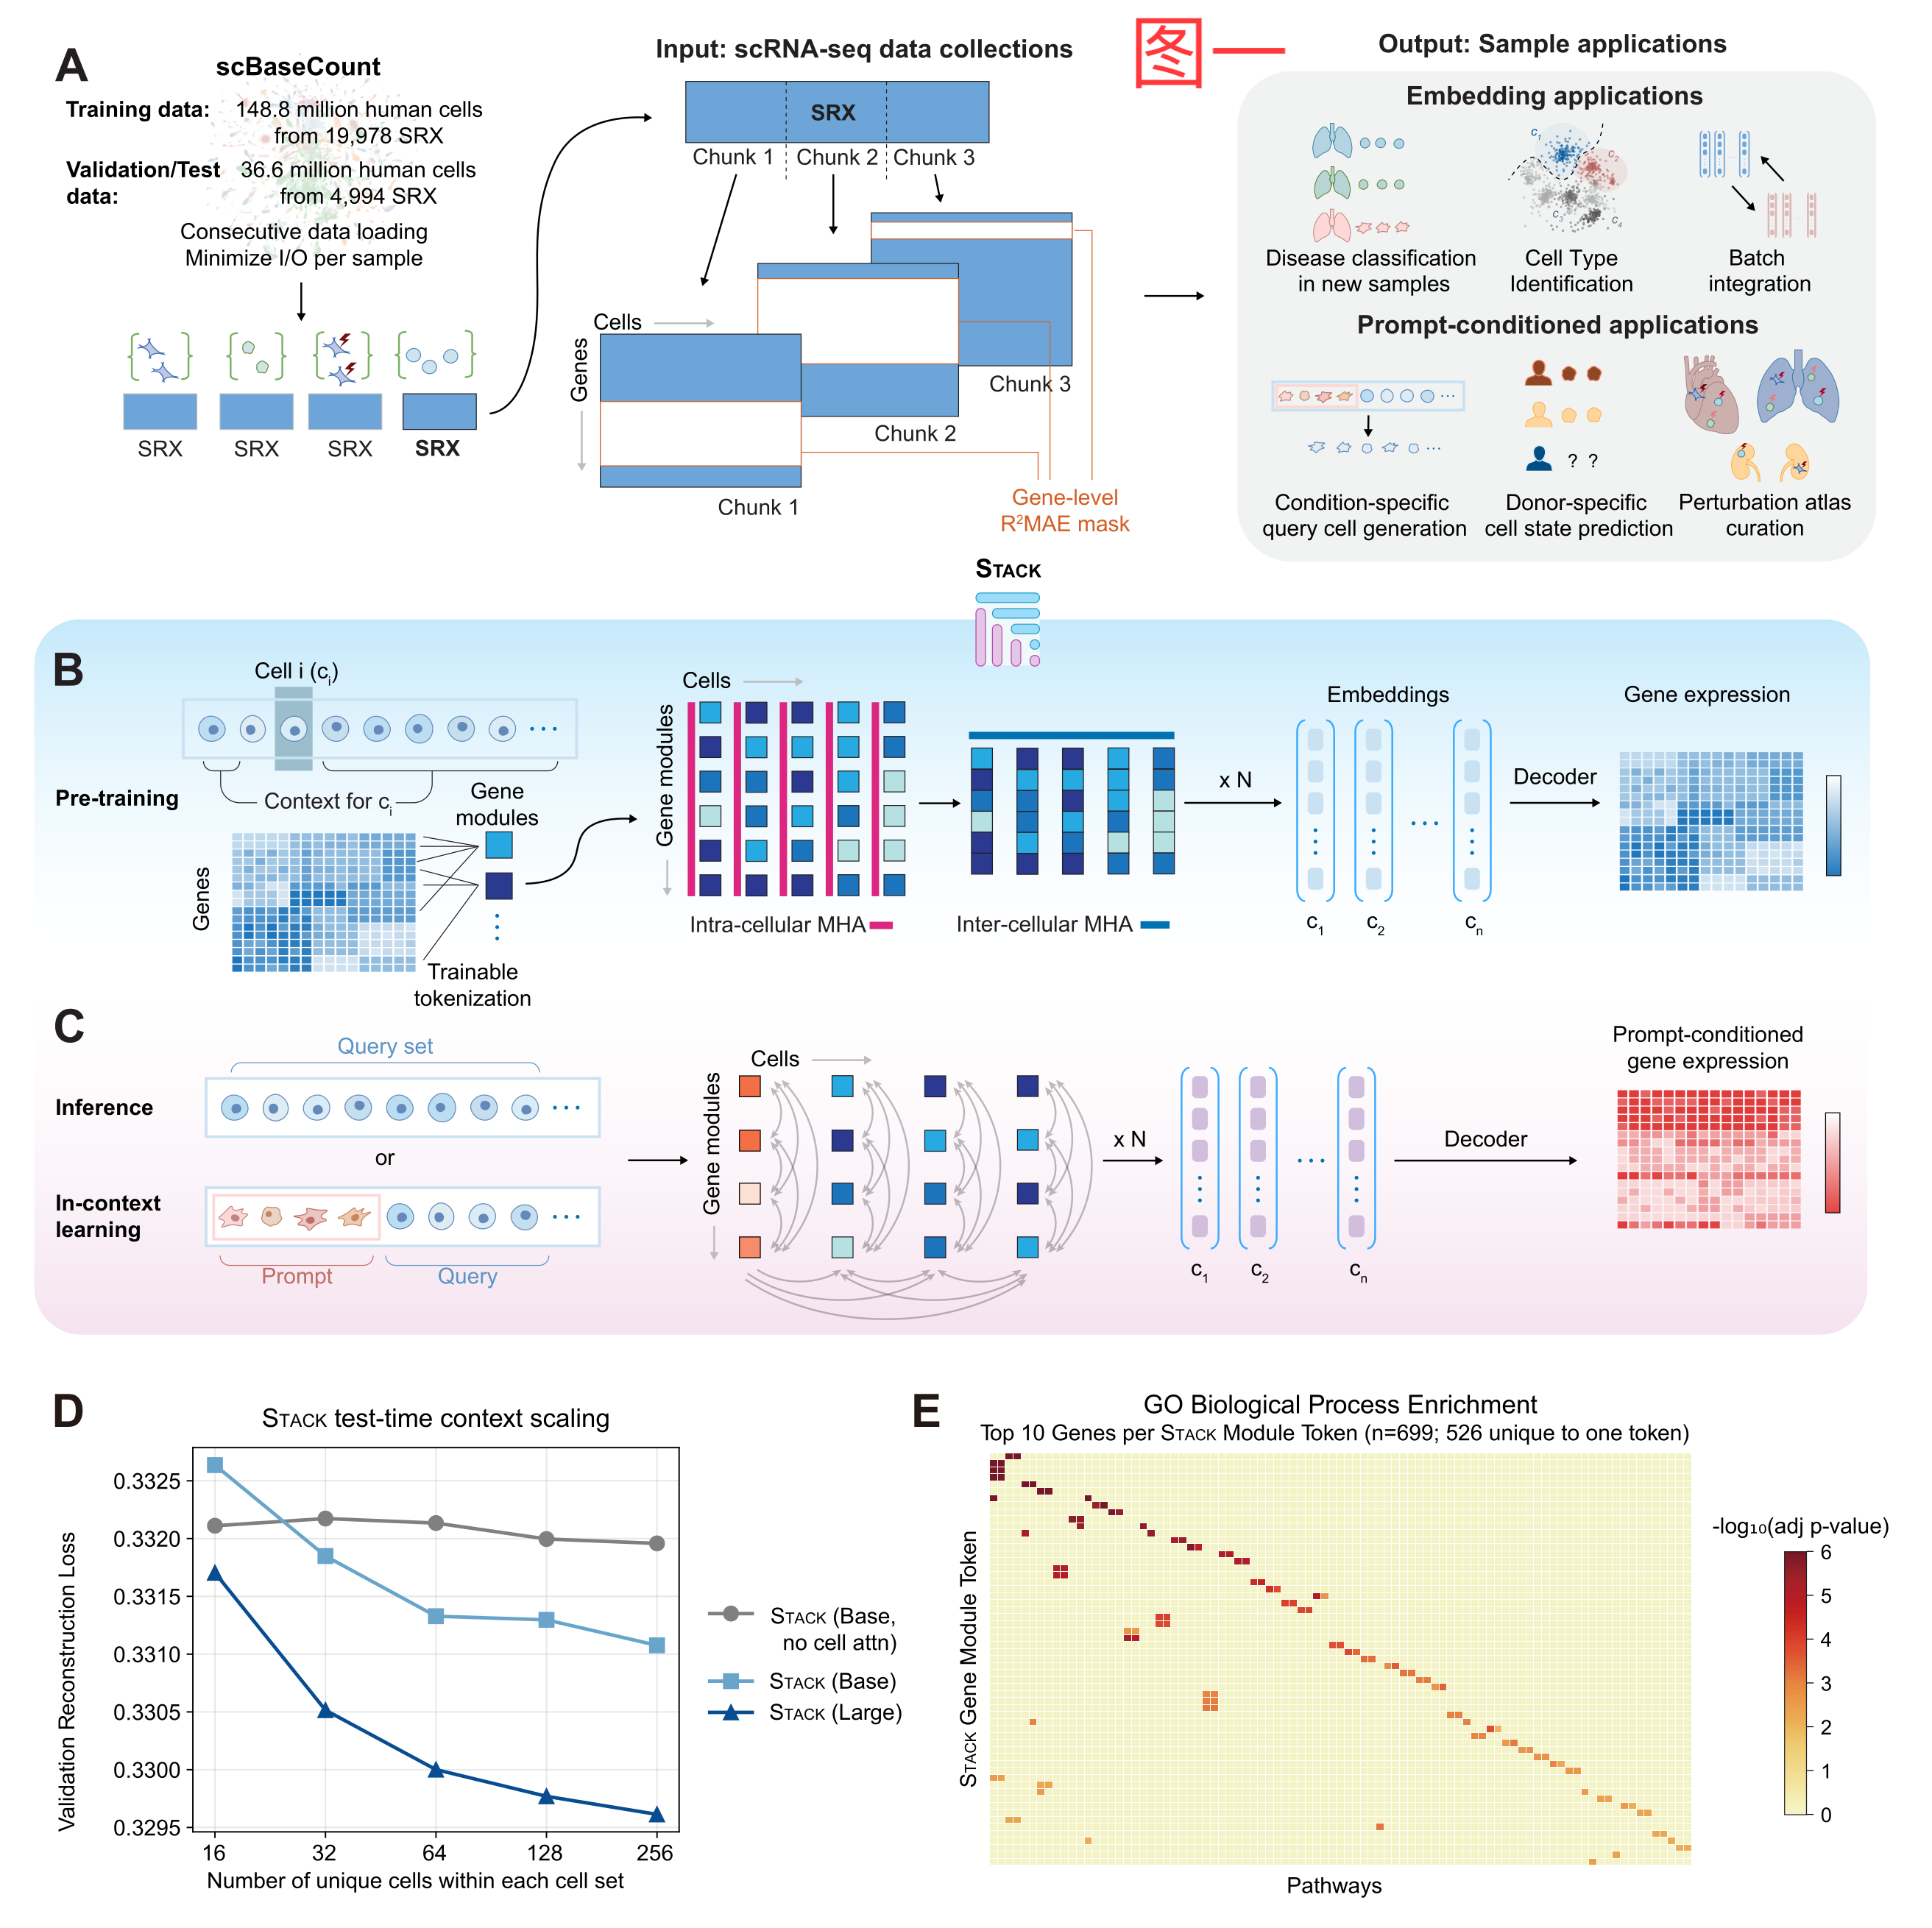 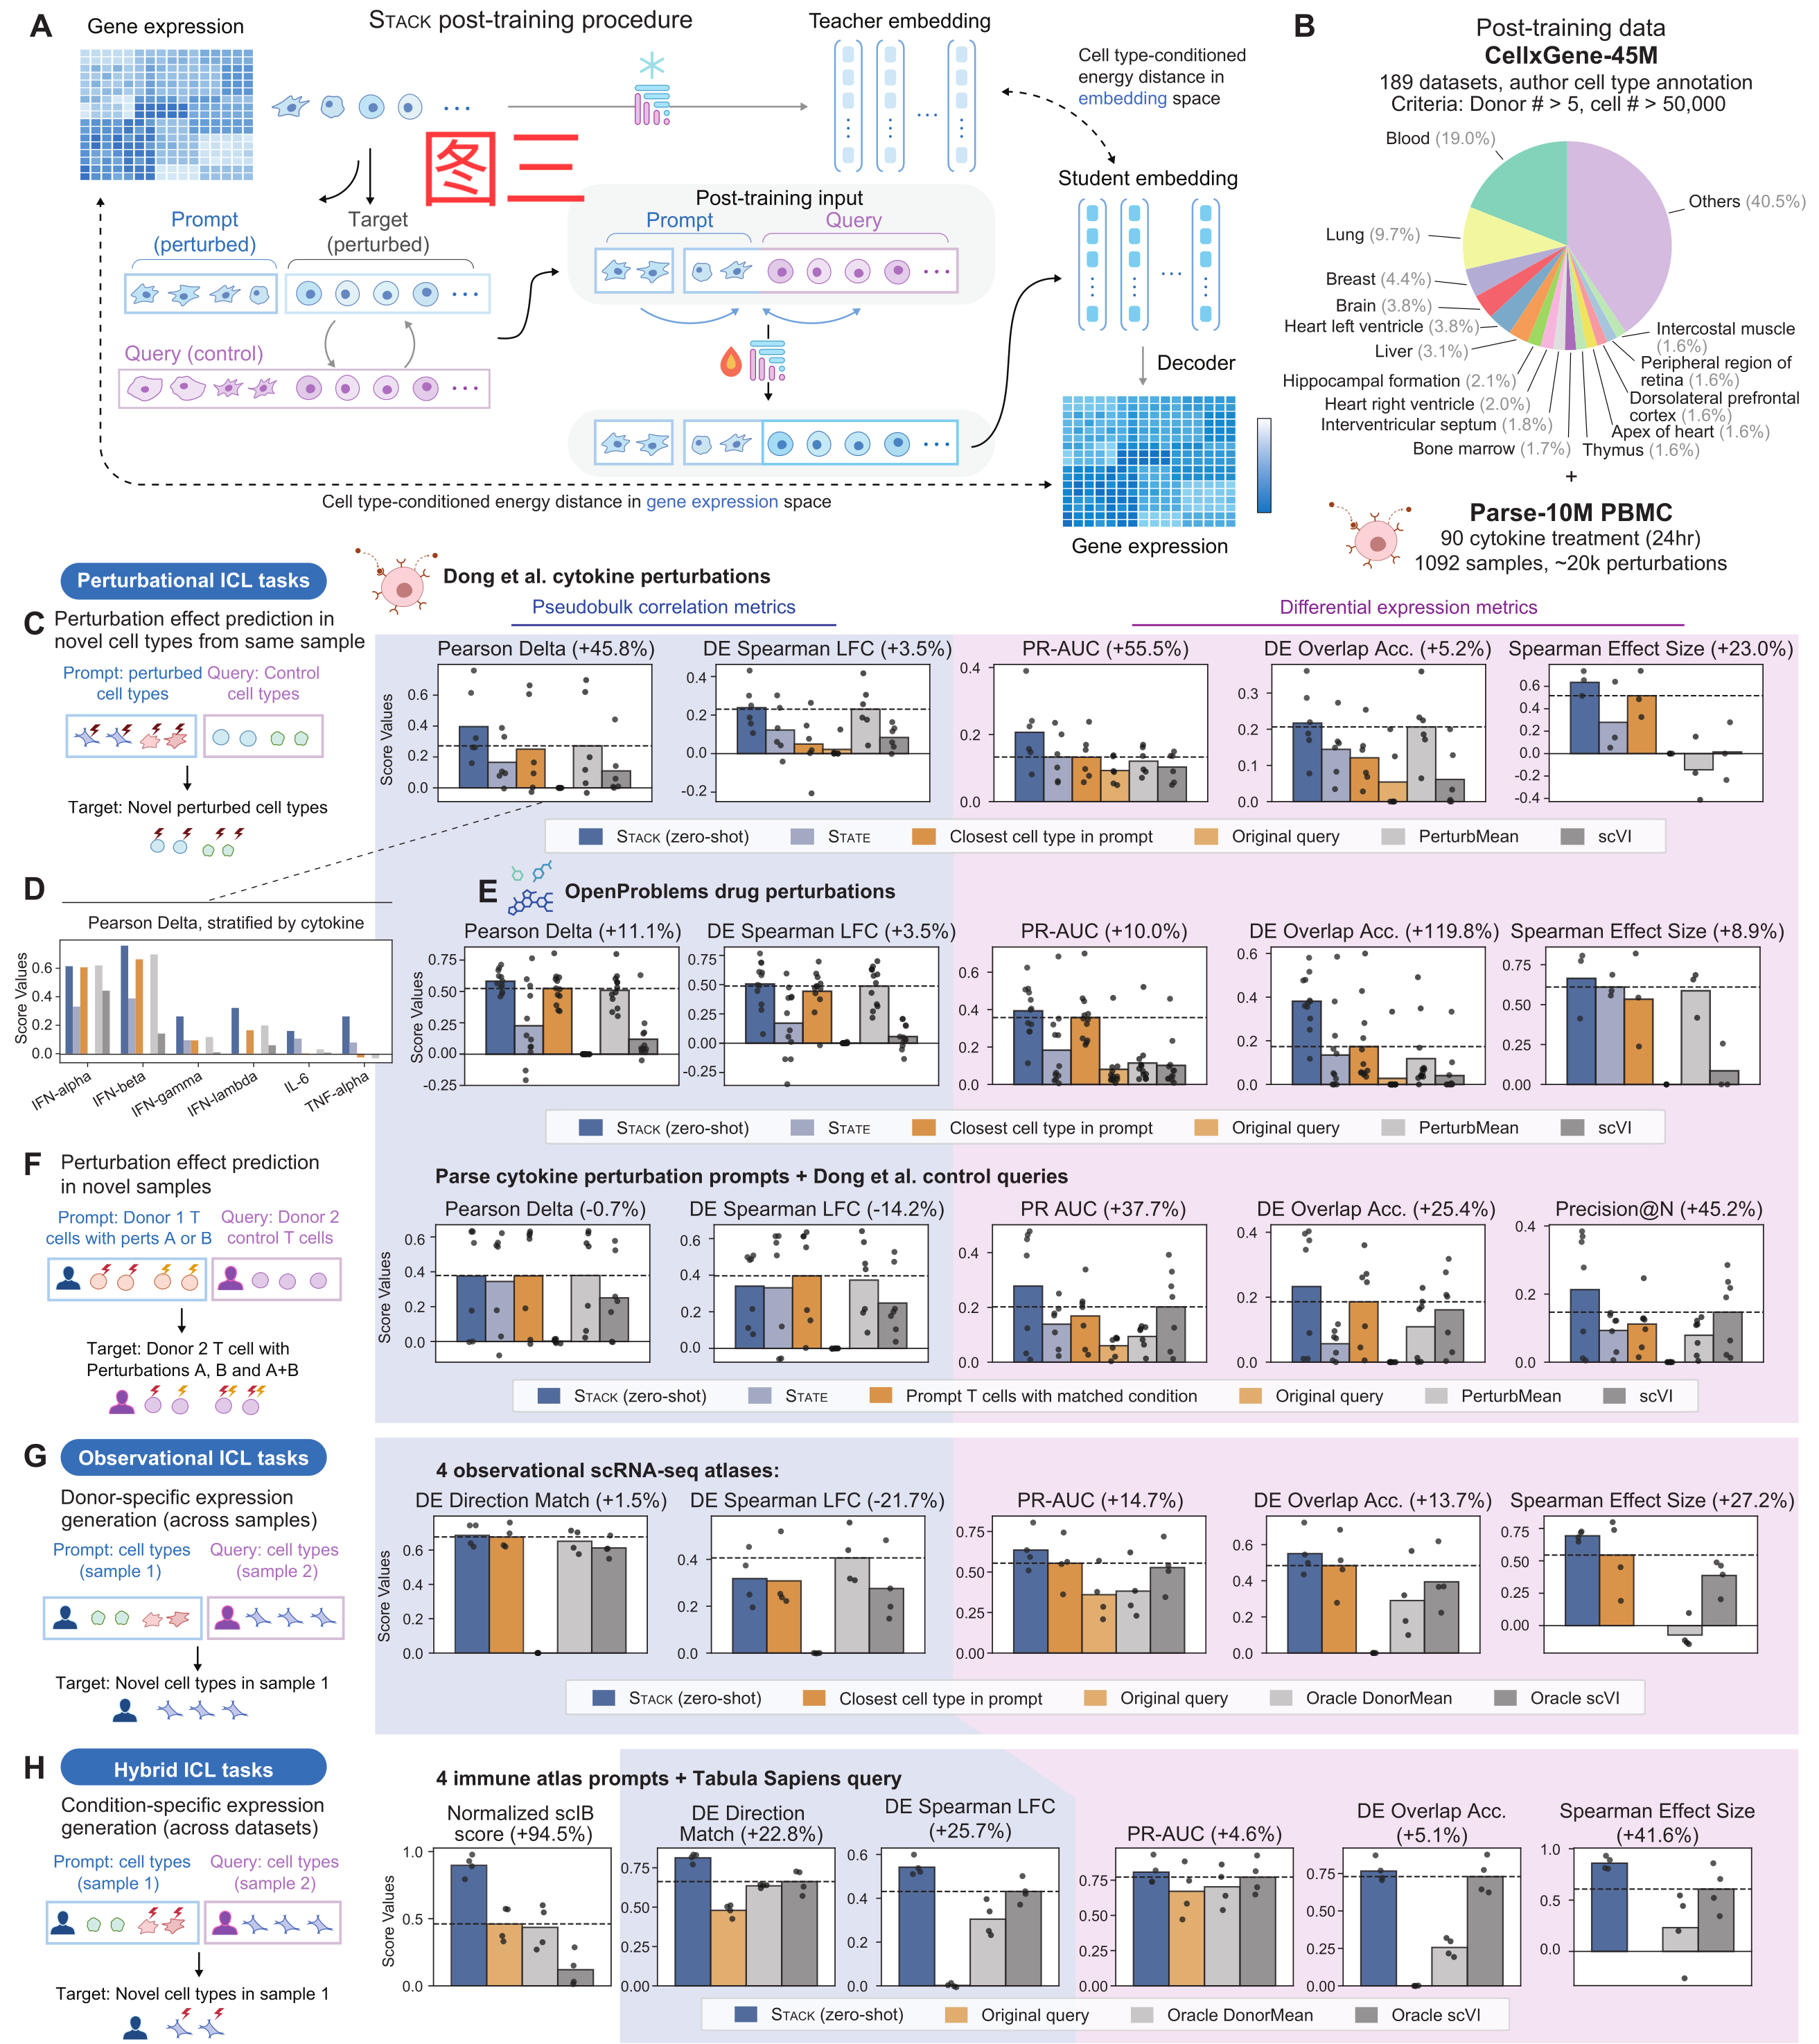 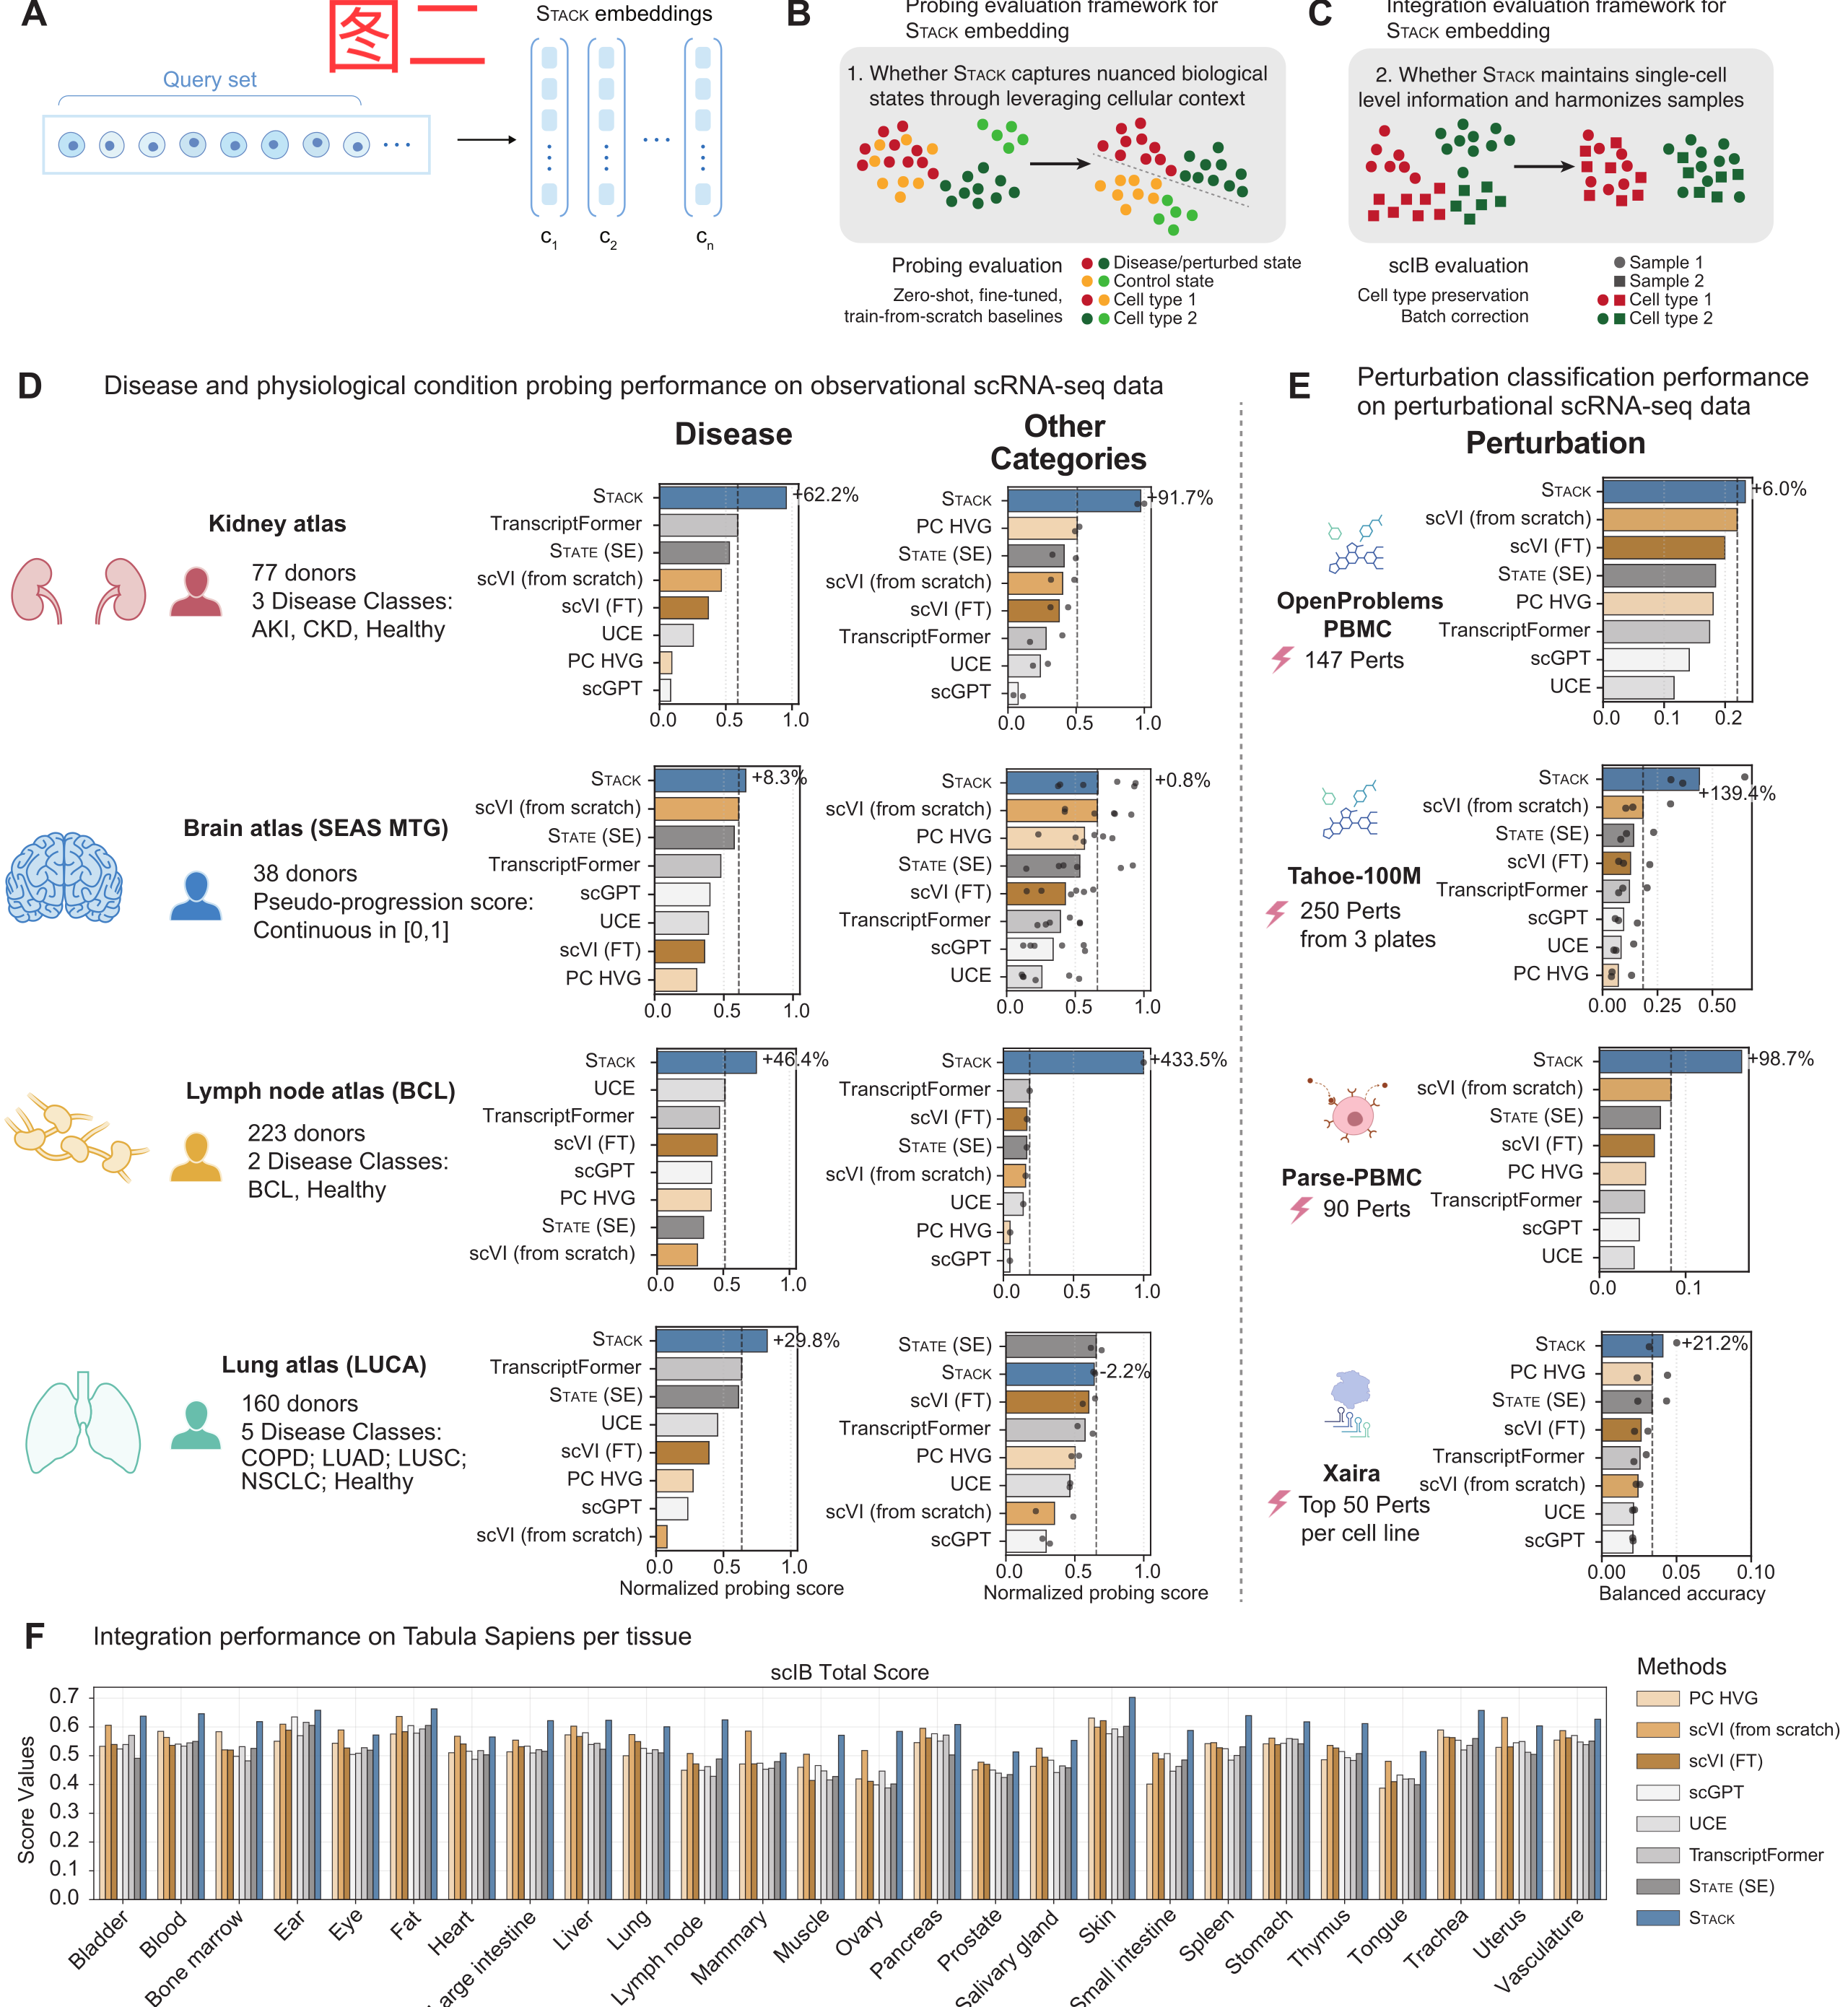 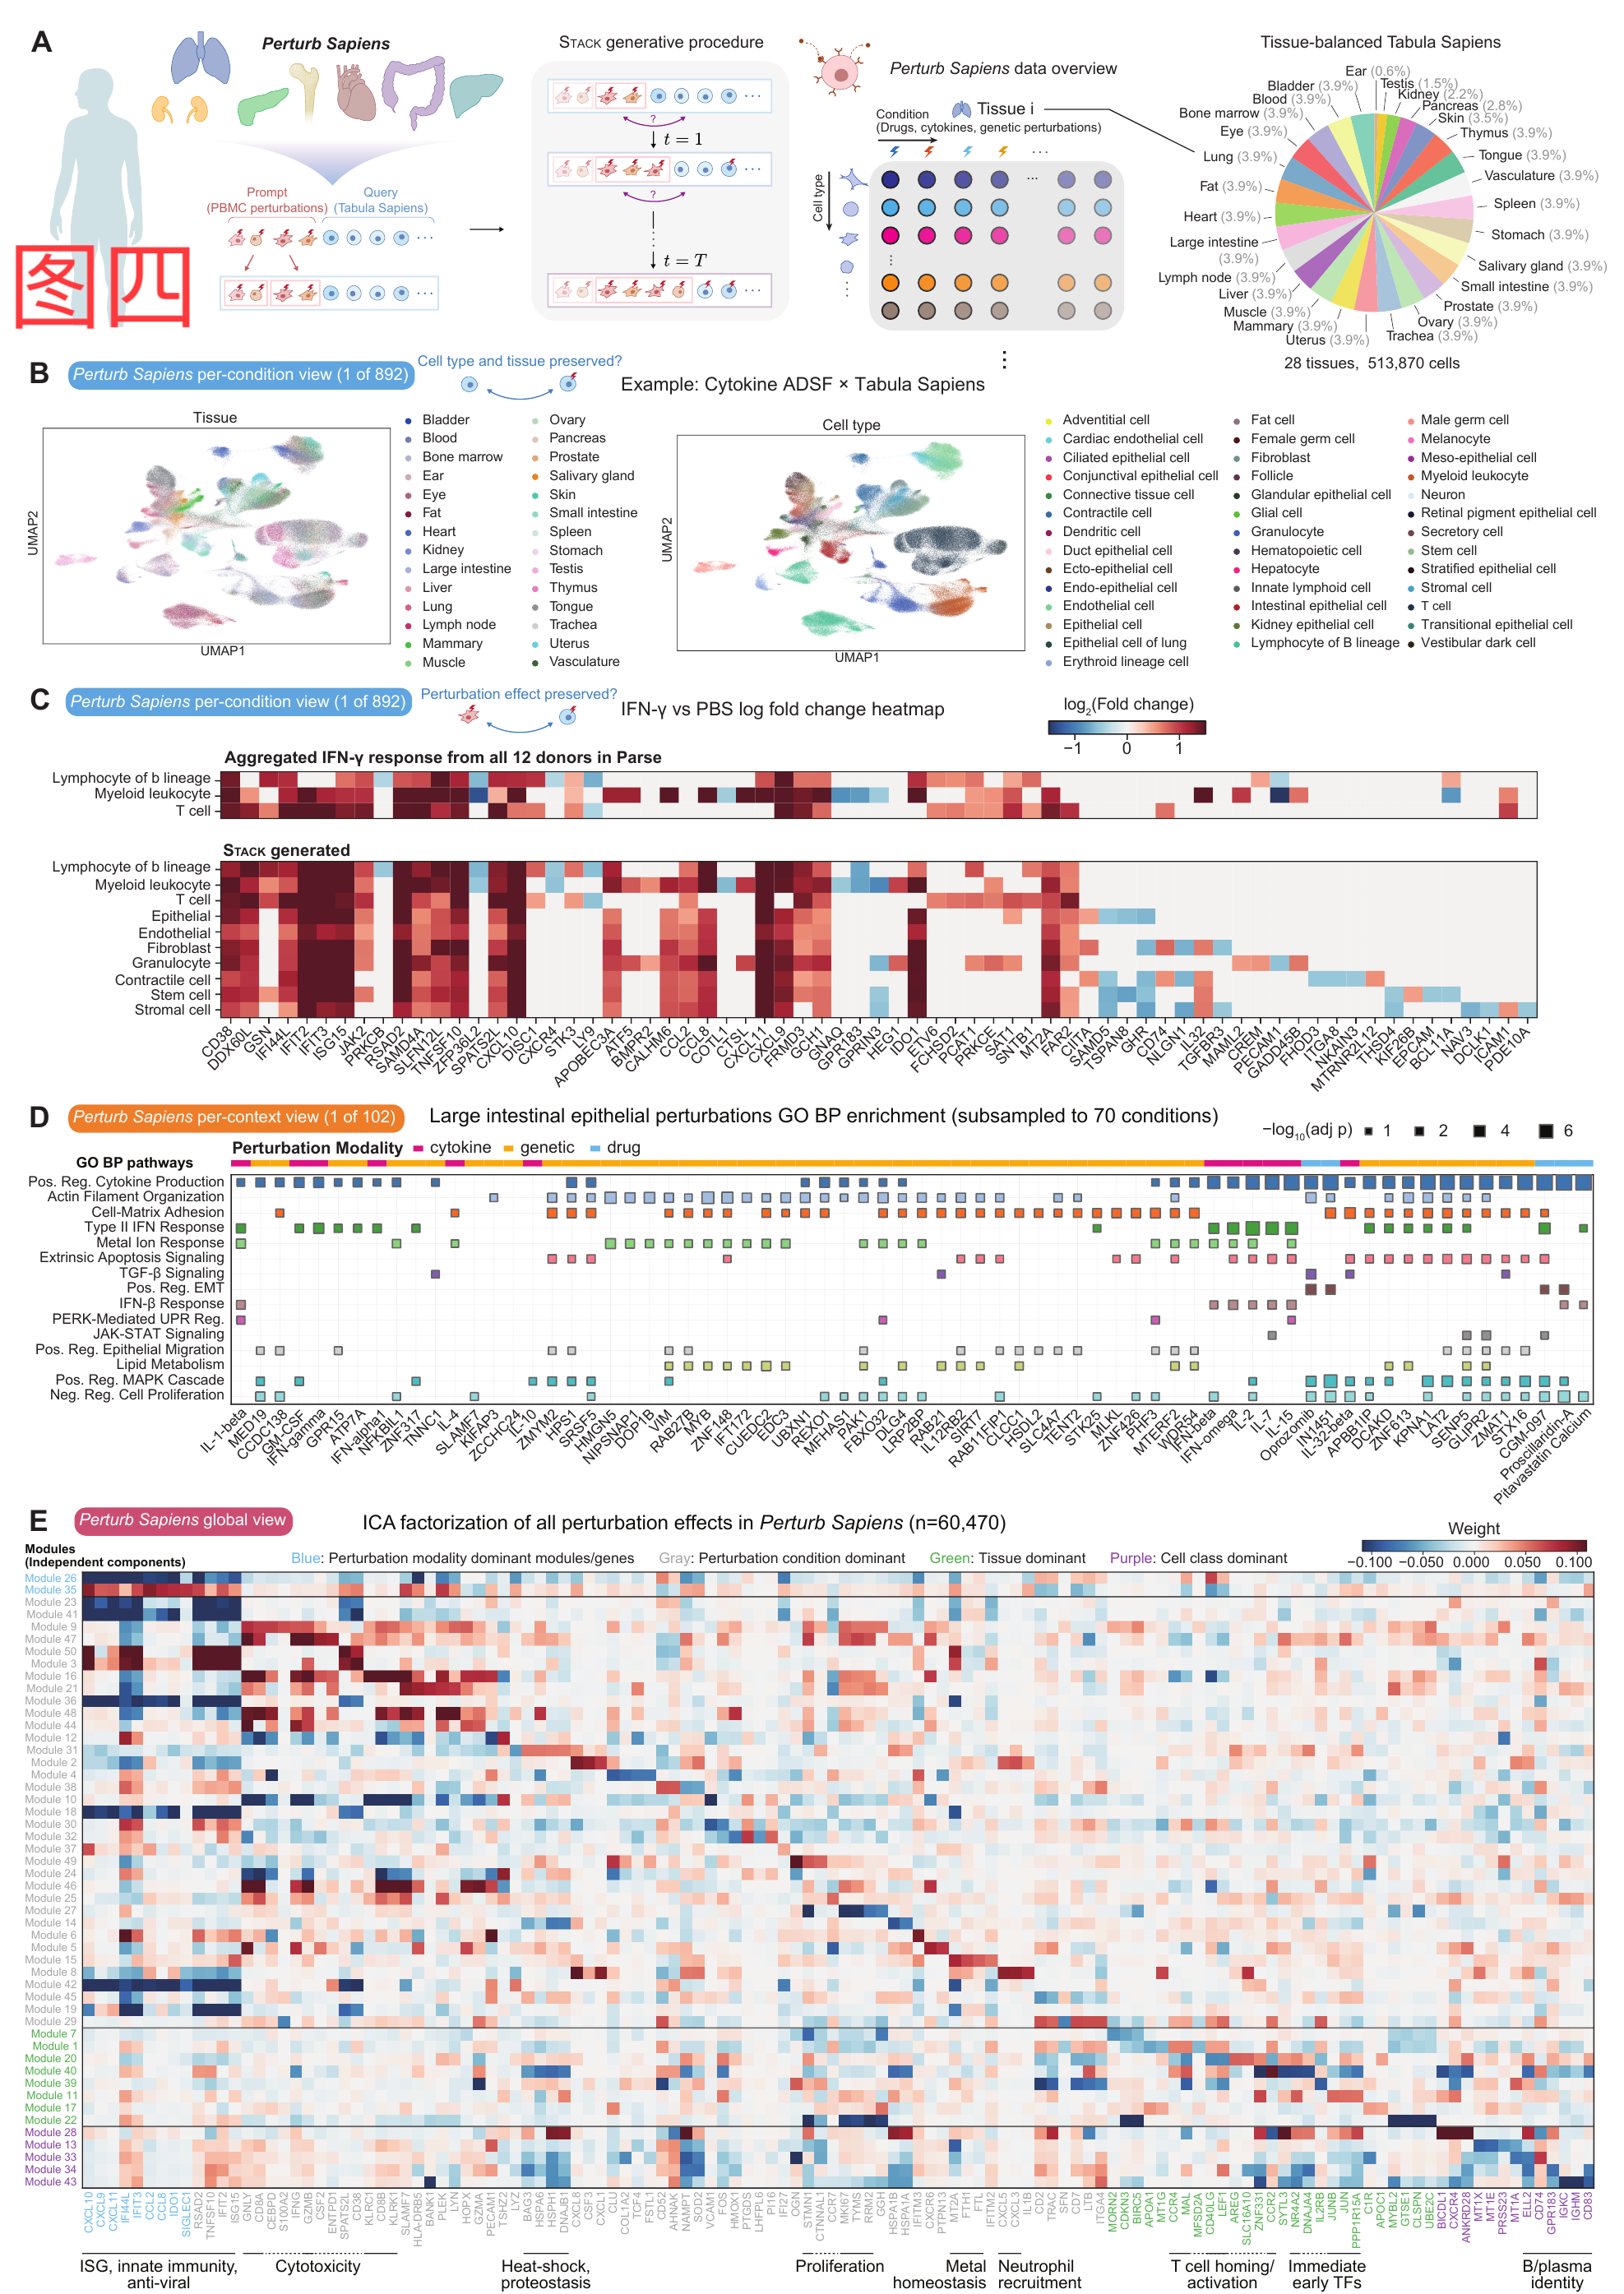 |
 回复此楼
» 猜你喜欢
 科研人必读:新一代 KRAS G12C 抑制剂 Olomorasib 的研究进展
已经有0人回复
-
BT-11(Omilancor)研究化合物全解析:从分子结构到实验应用要点
已经有0人回复
-
化学工程及工业化学论文润色/翻译怎么收费?
已经有175人回复
-
富马酸贝达喹啉:二芳基喹啉类工具化合物的化学特征
已经有0人回复
-
BT投稿with editor状态快两周了,正常吗
已经有25人回复
-
Silevertinib(BDTX-1535)结构拆解:炔基双环片段为何成为合成瓶颈
已经有0人回复
-
RO4929097 解析:双苯并氮杂䓬骨架与 Notch 通路实验设计要点
已经有0人回复
-
分子量 1157 的 PROTAC 怎么配不析出:SGK3-PROTAC1 的溶解、分装与图谱复核
已经有0人回复
-
logP 6.1 的羧酸怎么配母液:GSK 650394 的溶解窗口与稀释顺序
已经有0人回复
-
从"水不溶"到 71 mg/mL:雷特格韦的 pH 依赖溶解与螯合色谱边界
已经有0人回复
-
133 Ų 的极性表面积,如何决定 TNG462 的母液配制与色谱条件
已经有0人回复
» 抢金币啦!回帖就可以得到:
-
华南理工大学宋恩海研究员课题组招收2027届博士研究生(2026.11.15截止) 及招聘博士后
 +1/998
-
东北大学应用经济学博士招生-2027级
+1/973
-
科研搭子来了,科研大模型ScienceOra平台。
+2/278
-
论文祈福
+1/239
-
北京工商大学曹锦轩课题组招收2027年博士生
+1/196
-
合肥工业大学低维磁性与自旋电子器件研究团队 2027 年度博士研究生招生启事
+1/98
-
海南大学 化学化工学院 招收 化学、材料方向的 2027年博士
+1/49
-
昆明医科大学“柔性生物电子与智能传感课题组”招聘科研助理
+1/39
-
天津医科大学傅源教授团队,招2027级申请考核制博士生1名(生命科学或药学)
+1/14
-
天津医科大学傅源教授团队,招2027级申请考核制博士生1名(生命科学或药学)
+1/14
-
中国石油大学(北京)石油工程专业-开发方向课题组 2027博士招生
+1/6
-
bioRxiv|Stack:上下文学习如何重塑单细胞基础模型
+1/5
-
海南大学 · 固体废物综合处置与再生能源清洁利用创新团队 · 2027年博士招生
+1/5
-
QSAR软件(Derek&Sarah)
+1/5
-
有没有办法让PCR跑出实验室?
+1/5
-
您感兴趣的遗传病是哪些?您认为产前诊断在阻断遗传病传递作用有多大?
+1/3
-
东北师范大学国家杰青团队招收2027年“申请考核制”博士研究生1人
+1/3
-
从数据到靶点,一条证据链要过几道关?
+1/1
-
NK细胞分泌因子:天然免疫效应与免疫调节的双重功能
+1/1
-
小木虫app是不是登录不进去了
+1/1
