









| 查看: 51 | 回复: 0 | |||
君录生物新虫 (初入文坛)
|
[交流]
Genome Biology|单细胞组学分析智能体的系统基准评测
|

|
▍导读 2026年,广州国家实验室、广州医科大学与中国科学院上海营养与健康研究所等团队在 Genome Biology 发布面向单细胞组学分析的 LLM 智能体评测基准。体系由三部分组成:兼容多种智能体框架与大模型的统一平台;覆盖认知式程序合成、协作与执行效率、生物信息学知识整合、任务完成质量四个维度、共 18 项指标的评分方案;以及横跨多组学、多物种与多种测序技术的 50 个真实分析任务。评测显示 Grok3-beta 在测试框架中达到最优,多智能体框架凭角色分工显著提升协作与执行效率;归因分析表明高质量代码生成是任务成功的关键,自反思贡献最大,其次为检索增强生成与规划。研究同时指出代码生成、长上下文处理与知识检索是当前智能体的持续短板。 ▍研究背景 单细胞转录组、空间转录组与多组学整合技术的突破,正把生物学研究推进到「细胞级分辨率」时代,公共数据库已收录超过 5000 万个单细胞的多模态数据。然而数据复杂度的指数增长与分析方法的线性演进形成反差:传统分析高度依赖人工预选算法组合与参数调整,结果带有主观性、依赖操作者;从特征选择到预测推断的关键步骤缺乏透明的决策路径,可解释性有限;工具内置的参考数据库常常滞后半年以上,跨来源知识整合仍需大量人工整理。 为突破「数据—算法—知识」优化瓶颈,AI 智能体被寄予厚望。它模拟人类专家「假设生成—实验验证—迭代精修」的认知循环,在三个方面带来范式转变:自适应的工作流规划与代码执行、带透明思维链的跨学科可追溯决策、面向最新数据库与文献的实时知识融合。智能体通常采用「感知—推理—执行」架构:感知层解析自然语言、接入数据与知识库,推理层拆解任务并设计分析流程,执行层生成可执行代码、安全运行并输出可解释结果。 尽管理论潜力巨大,该领域仍缺少全面、标准化的评测体系。大量工作侧重提出新架构,却只在少量任务或案例上评估,少有深入追问性能从何而来、当前约束何在;既有的生物信息学智能体基准则普遍存在任务覆盖窄、技术深度不足、只用成功率或答题准确率等单一指标、结构封闭难以兼容多样框架与语言、以及只报结果不做失败诊断等问题。研究由此提出一套全面、标准化的智能体单细胞组学分析评测基准,推动该领域从经验驱动走向智能体生态范式。 ▍研究方法 研究以「统一平台+多维指标+多样任务+归因分析」构建评测体系,对三种智能体框架与八个大模型做系统横评: 统一评测平台:以标准化输入(任务描述、数据路径、分析要求)与 plan-execute-reflect 循环的智能体系统为骨架,输出计算与可视化两类结果;兼容 ReAct、LangGraph、AutoGen 等框架,集成 GPT-4o、GPT-4.1、DeepSeek-R1、DeepSeek-V3、Qwen-2.5-max、Sonnet-3.7、Gemini-2.5-pro、Grok3-beta 八个大模型,并支持 Python 与 R。 十八项多维指标:从认知式程序合成、协作与执行效率、生物信息学知识整合、任务完成质量四个维度评分并加权为 0–1 总分;涉及大模型打分的指标取三个模型评分的均值,RAG 触发准确率另叠加专家评分以降低偏差。 五十个基准任务:每个任务配公开数据集、核心分析工具与金标准输出脚本,覆盖批次校正、细胞注释、动态分析、扰动、ATAC-seq、多组学、空间解卷积、基因填补、空间域识别、细胞通讯、聚类、高变基因选择等类别。 鲁棒性与消融实验:设计基本、中级、高级三档提示词,并额外更换数据集、重复多次运行;在 ReAct 上消融知识检索与规划,在 AutoGEN 上进一步消融自反思与智能体间流程控制。 失败归因分析:从执行日志提炼 14 类错误,归纳为系统设计、调度协作、环境输入、核心模块能力四类,采用三模型投票与专家抽样复核的双阶段判定,提高错误归因的严谨性、可追溯性与可复现性。 ▍核心发现 1、提出面向单细胞组学的智能体评测基准 研究提出一套面向智能体单细胞组学分析的标准化评测体系,由统一平台、多维指标与基准任务三部分构成(图 1)。 平台以标准化输入(任务描述、数据路径、分析要求)、plan-execute-reflect 循环的智能体系统与计算/可视化两类输出为骨架,兼容 ReAct、LangGraph、AutoGen 等框架与 GPT-4.1、DeepSeek、Qwen、Sonnet、Gemini、Grok 等八个大模型,并支持 Python 与 R。 指标侧共 18 项,归入认知式程序合成、协作与执行效率、生物信息学知识整合、任务完成质量四个维度并加权为 0–1 总分;任务侧 50 个真实任务各配公开数据集、核心工具与金标准脚本,为异构智能体的客观定量比较提供统一、可复现的环境。 《单细胞组学智能体评测体系总览》 · 来源:Liu et al., 2026, Genome Biology 2、跨三种框架与八个大模型横评,Grok3-beta 在受测组合中最稳 在三种框架与八个大模型的组合横评中,Grok3-beta 展现出最强的跨框架适应性,稳定进入前二(图 2)。 就单一组合而言,ReAct 配 Grok3-beta 总分最高、任务完成质量最优;但 ReAct 完全依赖大模型自身能力,配 DeepSeek-V3 时因无法正确触发工具调用而整体失败,且交互与纠错轮数比多智能体框架多出两到三倍。 多智能体框架凭角色分工显著提升协作与执行效率。图 2 还显示,ReAct 的平均交互轮数明显更多,但知识检索准确率平均高出 12%–18%,体现了单智能体检索能力与多智能体协作效率之间的权衡。 《多智能体框架与大模型横评结果》 · 来源:Liu et al., 2026, Genome Biology 3、结果一致性可作跨任务结果质量的有条件代理 研究者以智能体结果与金标准脚本结果的一致性衡量任务表现,并在图 3 中进一步比较这一指标与任务特异的生物学指标。 图 3 展示了空间解卷积、基因填补、轨迹推断和聚类四类任务中,智能体结果与金标准结果的可视化差异,并比较不同框架和模型组合的结果一致性及生物学表现。 四类任务中,生物学表现较高的组合通常具有较高一致性,最低者往往一致性也最差。结果一致性虽不等同于生物学质量,但可用于统一尺度下的跨任务比较;当金标准脚本本身代表高质量解法时,这一代理指标更可靠。 《结果一致性与生物学指标分析》 · 来源:Liu et al., 2026, Genome Biology 4、提示词影响最大,数据集与重复运行稳健 研究用基本、中级、高级三档提示词考察鲁棒性,发现提示词变化对结果影响最大(图 4)。 对 AutoGEN 与 ReAct,中高级提示带来 2%–15% 的指标提升;LangGraph 反而略降约 0.01,作者推测这与框架设计灵活性有关——越是灵活的框架越能抵消大模型对提示的敏感性。 在数据集与重复运行两个维度上,智能体总体表现稳定:换用新数据集后主要结论不变,模型排名未被改变;三次独立运行中,通过率、成功率、结果一致性与总分基本稳定,对 Grok3-beta 和 GPT-4.1 可计算任务观察到的一致性变化均在 10% 以内。 《提示词、数据集与多次运行的鲁棒性评估》 · 来源:Liu et al., 2026, Genome Biology 5、模块消融显示自反思贡献最大,RAG 次之 研究使用 Grok3-beta 开展功能模块消融:ReAct 仅测试移除知识检索和规划,AutoGEN 则进一步测试移除自反思与智能体间流程控制(图 5)。 在 AutoGEN 的消融结果中,移除自反思造成最明显的性能下降,说明实时纠错与策略调整对复杂任务至关重要;知识检索是第二项关键增强,并在 AutoGEN 与 ReAct 中均带来收益。 规划的作用依框架而异:它提升结构化 AutoGEN 的表现,却可能限制 ReAct 的动态推理;在 AutoGEN 中移除智能体间流程控制未改变最终成功率,仅使总分小幅增加约 0.011,提示清晰的系统提示可支持一定程度的自组织。 《功能模块消融对性能的影响》 · 来源:Liu et al., 2026, Genome Biology 6、失败剖析:长上下文处理失败影响最广 对主实验中失败任务的执行日志做错误归类后,研究提炼出 14 类常见错误,并归纳为系统设计、调度协作、环境输入与核心模块能力四类(图 6)。 不一致的规划行为、规划器问题、指令遵循不佳、输入提示含糊与知识获取失败最为常见,且分布随框架不同而变化:LangGraph 更易出现知识获取失败与冗余流程,ReAct 更易出现长上下文处理失败。 其中长上下文处理失败的跨指标影响最广,会通过破坏「计划—代码」一致性引发级联退化,最终损害代码质量与任务成功;研究者据此认为计划—代码一致性可能是这条退化链的中介环节。 《失败任务与错误类型分析》 · 来源:Liu et al., 2026, Genome Biology ▍核心结论速览 - 面向单细胞组学分析构建统一智能体评测基准。 - 18 项指标覆盖认知、协作、知识整合与完成质量。 - 50 个真实任务横跨多组学、多物种与多测序平台。 - Grok3-beta 在受测组合中跨框架最稳,多智能体协作更高效。 - 自反思贡献最大,其次为检索增强与规划。 - 长上下文处理与代码生成仍是主要短板。 ▍研究意义 科学价值:把单细胞组学智能体从「各提架构、各测几例」推进到统一、可复现的量化比较范式,用四维 18 项指标与 50 个真实任务揭示高质量代码生成与自反思是任务成功的关键,为构建可靠的计算生物学智能体提供实证依据与方法蓝图。 潜在应用价值:统一的评测环境可帮助研究与转化团队比较智能体组合,并为注释、解卷积、细胞通讯等流程的自动化选型提供依据;其在真实生产环境、临床队列与临床决策中的可靠性仍需进一步验证。 ▍局限与下一步方向 作者指出若干局限与演进方向:一是适用范围,评测虽覆盖 50 个高频工作流,但单细胞生物学演化迅速,发生率较低却实用的长尾流程与新兴技术(如超高分辨率空间转录组)未被纳入,且仅限三种成熟框架,排除小众或新兴系统,需社区驱动持续集成新任务、新模型与新框架;二是智能体决策的黑箱问题,量化指标能评估任务成功,却无法保证其内部推理的生物学合理性,需要可解释性工具(如注意力可视化、基于知识图谱的推理轨迹分析);三是鲁棒性评估仍限于受控扰动场景,尚未涉及分布外泛化、对抗鲁棒性与动态环境适应;四是部署成本,本研究只报告各组合在基准任务上的总开销,未记录逐任务的 token 数、时延与费用,实际规模化部署需通过模型蒸馏、高效提示与本地模型等手段加以控制。 ▍FAQ Q:这个评测基准与以往生物智能体基准有何不同? 以往基准任务覆盖窄、多用问答或选择题、指标单一且结构封闭;本基准用统一平台兼容多种框架与大模型,配 18 项多维指标与 50 个需真实执行代码的分析任务,可跨框架、跨模型直接比较。 Q:18 项指标分别评什么? 归为四类:认知式程序合成(规划与代码质量,含 AST 相似度与 ROUGE)、协作与执行效率(执行时间、资源占用、交互与自纠轮数)、生物信息学知识整合(RAG 触发准确率与检索准确率)、任务完成质量(完成率、通过率、成功率与结果一致性)。 Q:哪个模型与框架表现最好? 在本研究测试的三种框架与八个模型中,Grok3-beta 跨框架适应性最强、稳定进入前二;ReAct 配 Grok3-beta 总分最高且知识检索更准,但交互轮数更多;多智能体框架靠角色分工在协作与执行效率上占优。 Q:智能体做单细胞分析最常卡在哪? 归因分析显示,自反思贡献最大,其次为 RAG 与规划;失败多源于代码错误,尤其发生在数据处理阶段,以及长上下文处理失败带来的累积偏差。多数任务结果一致性最高仅约 0.4,整体仍有较大提升空间。 ▍君录视角 · 虚拟细胞 解决的问题:单细胞数据体量与复杂度指数增长,分析却仍高度依赖人工预选算法与调参,结果带主观性、决策不透明、知识更新滞后;智能体虽被寄予「自适应规划—可执行代码—可追溯决策—实时知识融合」的期望,却长期缺少统一、可复现的评测,难以回答哪种框架与大模型组合真正可靠。该工作用统一平台、四维 18 项指标与 50 个真实任务,把「智能体能否胜任单细胞分析」变成可量化、可复现的横评问题。 集成判断:其关键增量不在某个新模型,而在于把评测做成「平台+指标+任务+归因」的闭环——兼容多框架多模型、任务需真实执行并配金标准脚本,还用消融与失败分析厘清自反思、RAG 与规划的作用次序,指出代码生成与长上下文处理是主要瓶颈。这一骨架可直接复用为单细胞乃至更广生物信息学流程自动化的选型与验收层。 ▍原文信息 Liu Y, Zhou L, Du X, et al. Benchmarking LLM-based agents for single-cell omics analysis. Genome Biology. 2026;27(1):123. doi:10.1186/s13059-026-03998-z ▍关于我们 君录生物 · 以数据驱动创新药早期开发 自建心血管专病数据基座HeCellAstra和对话式生信分析平台IntelliCytoPilot 做靶点发现与药物管线早期资产 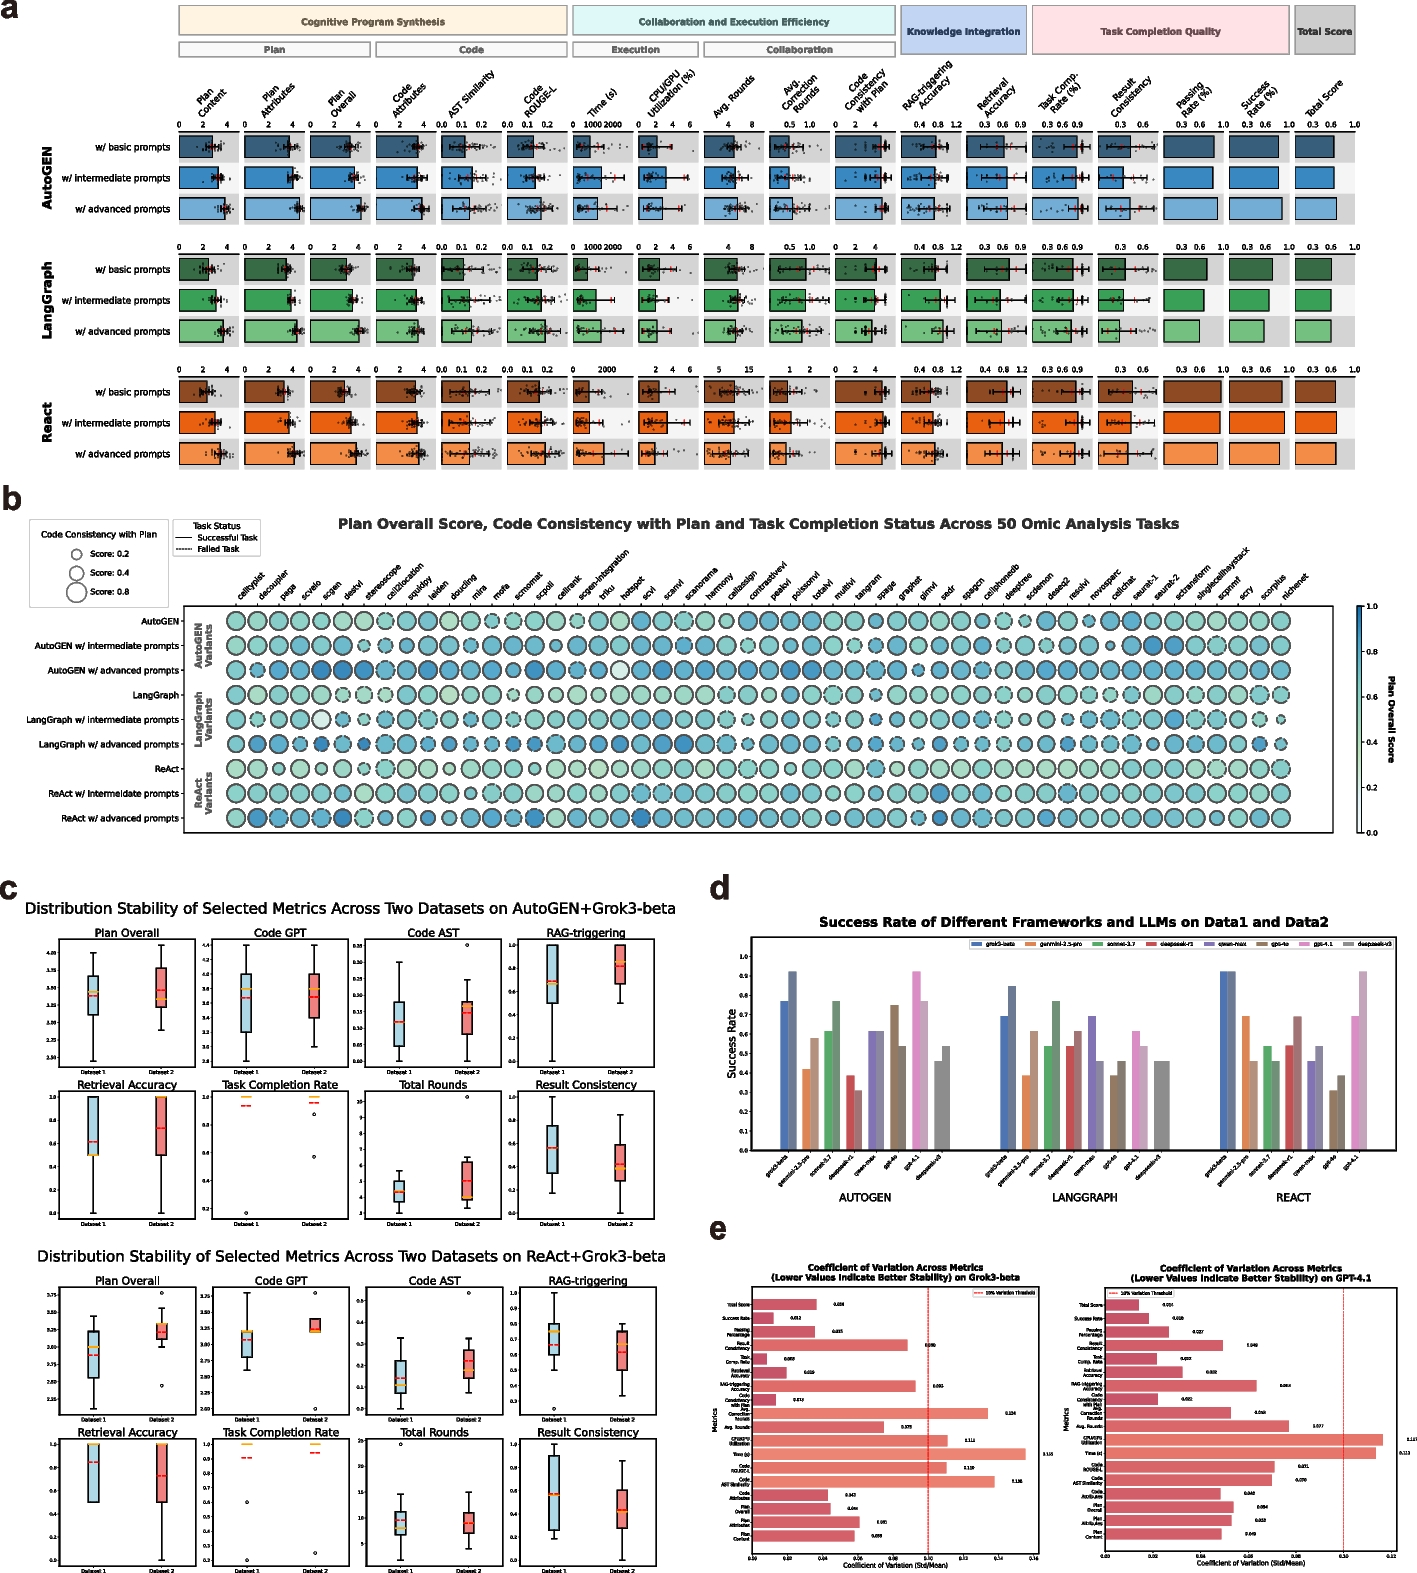 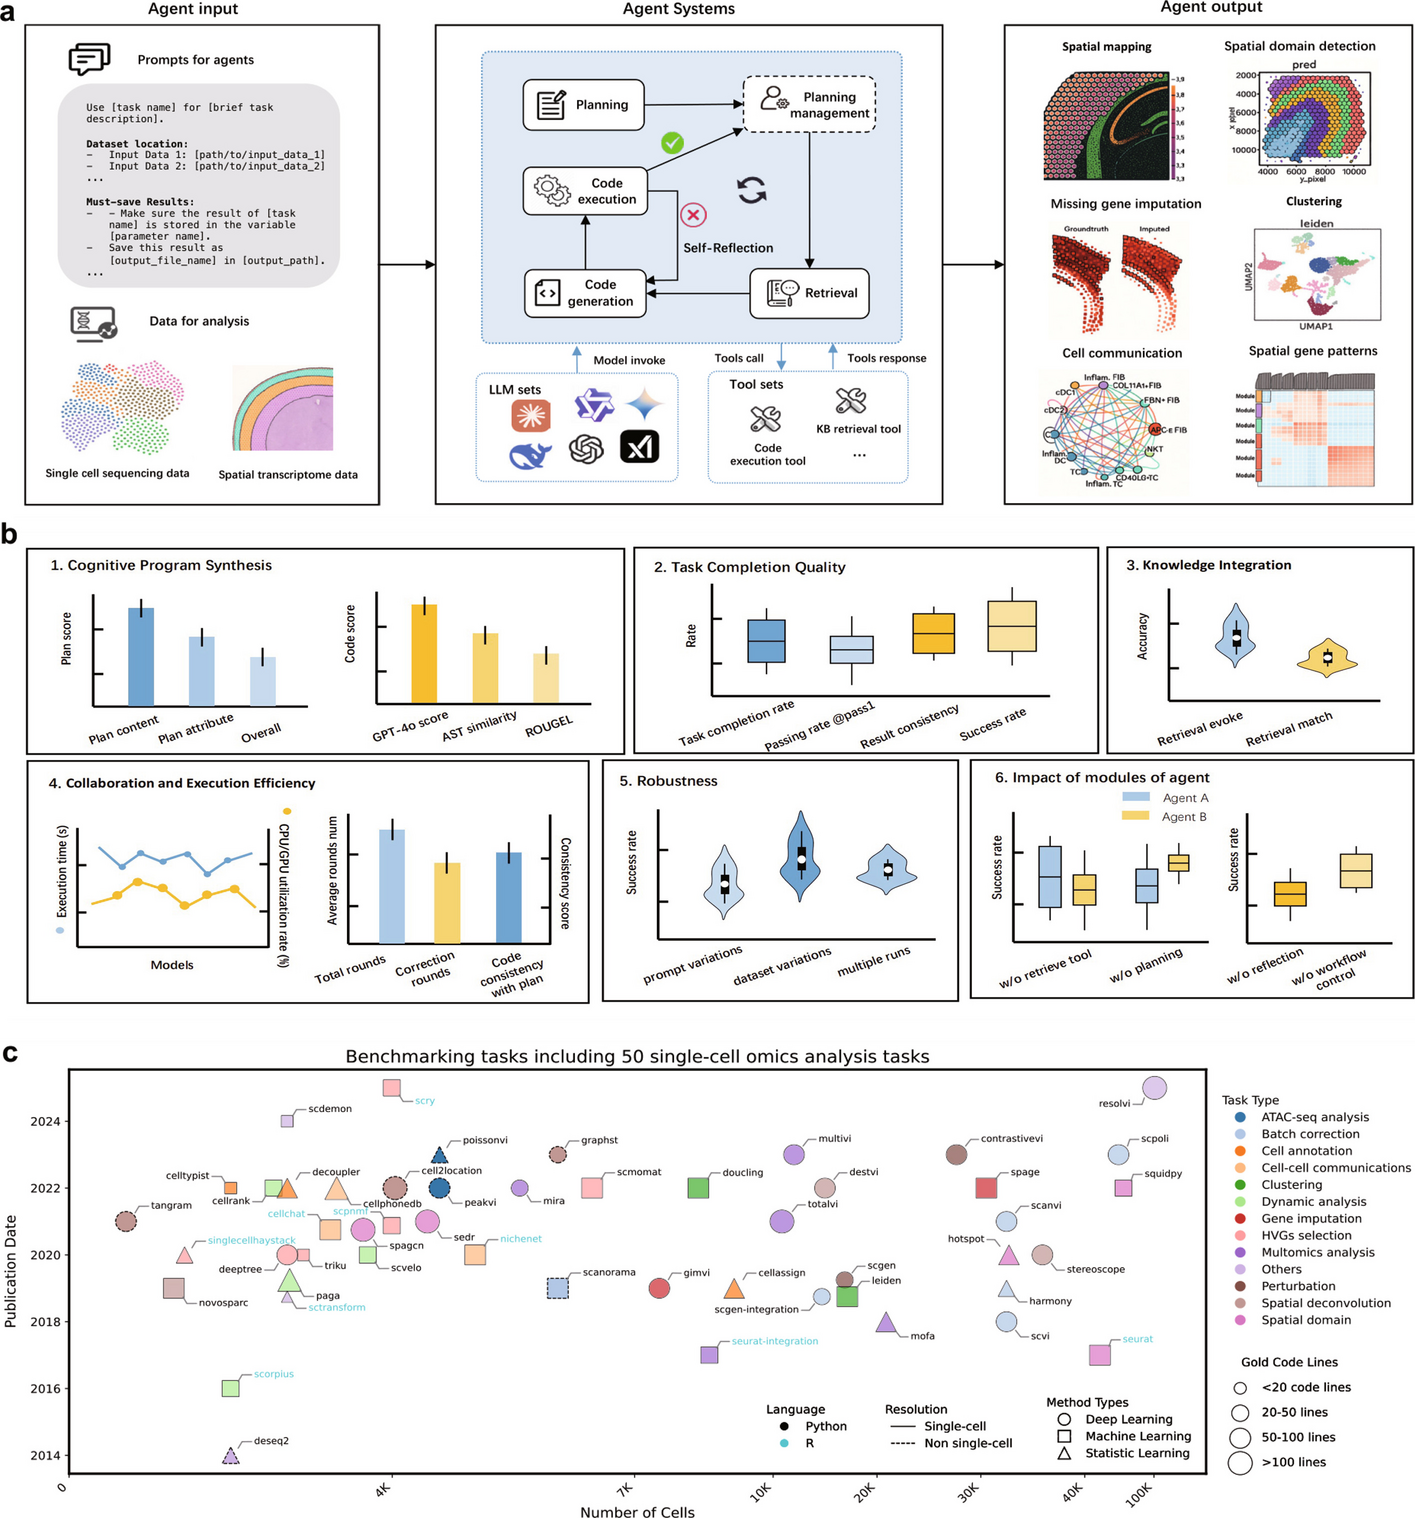 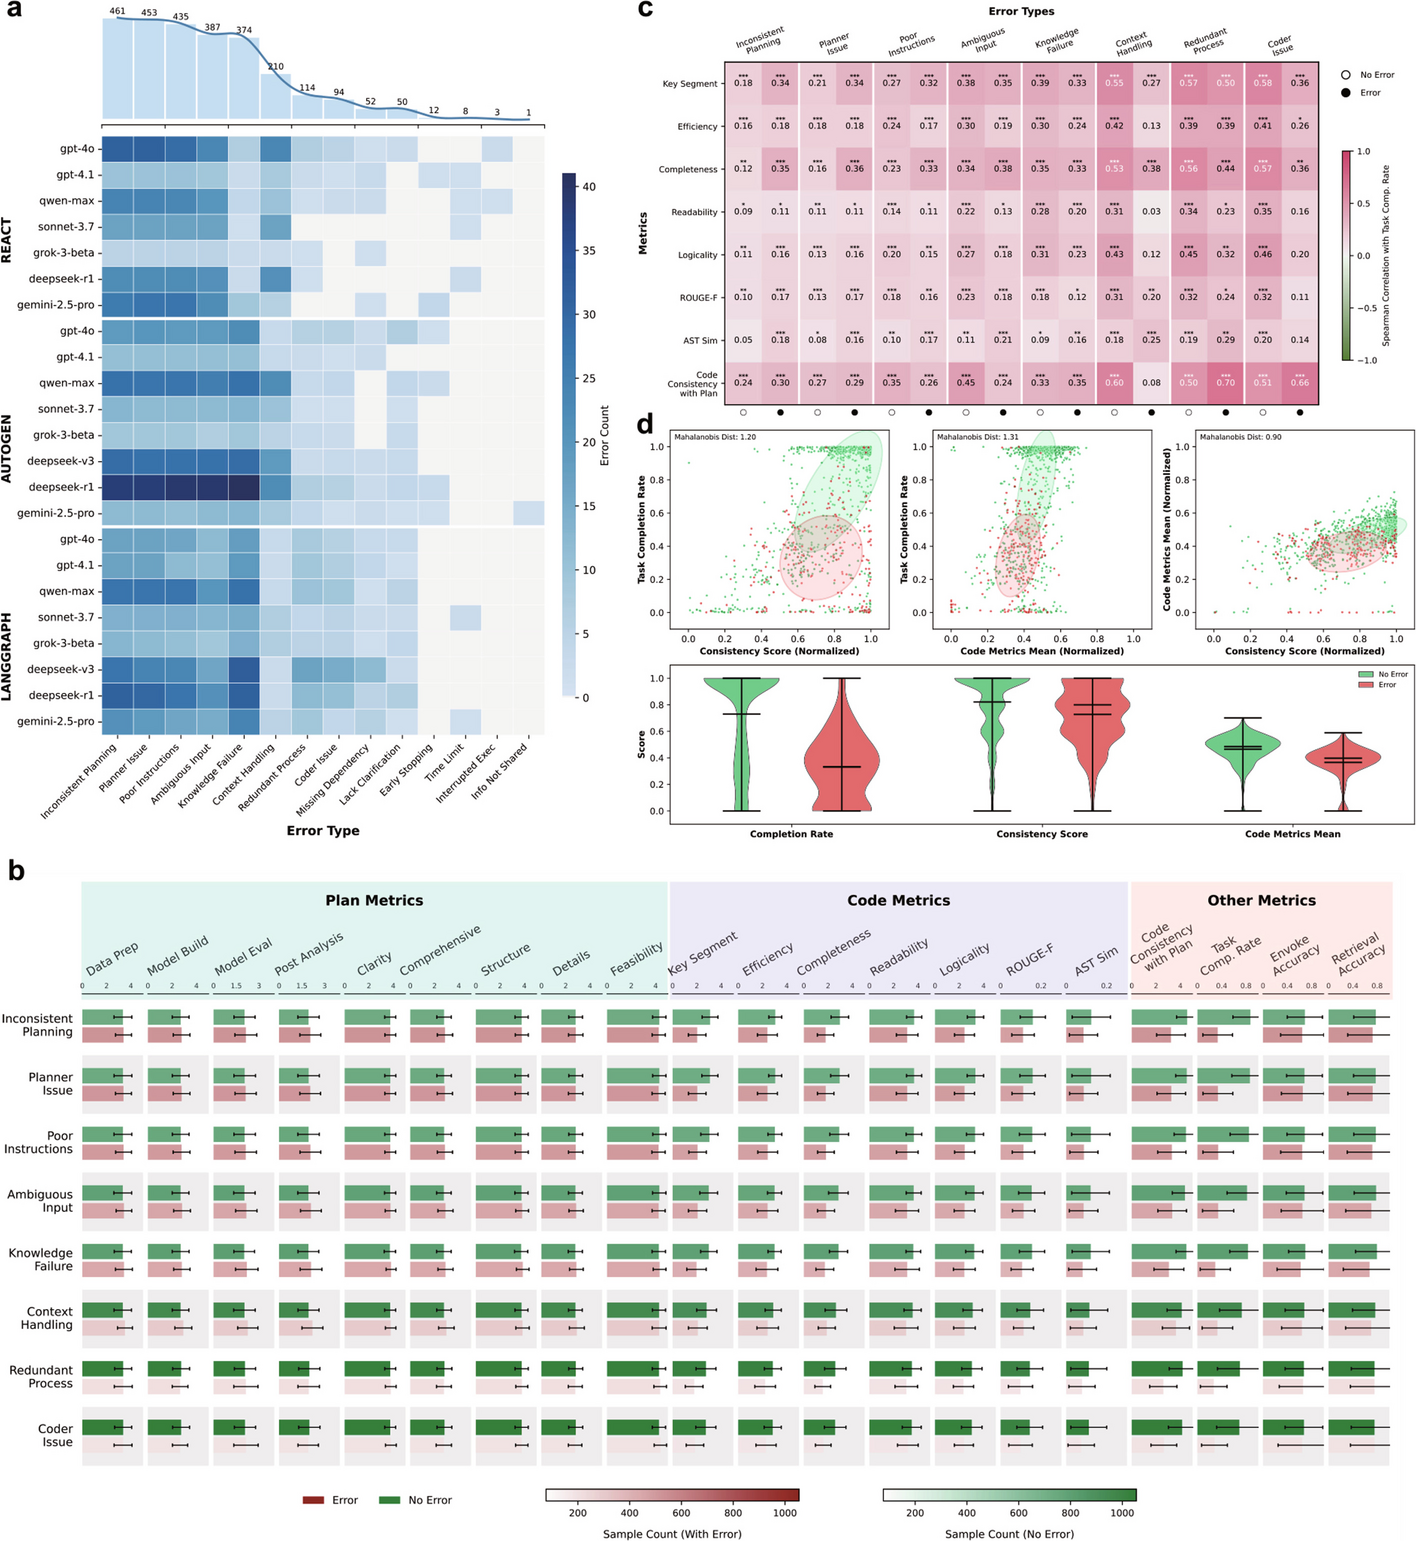 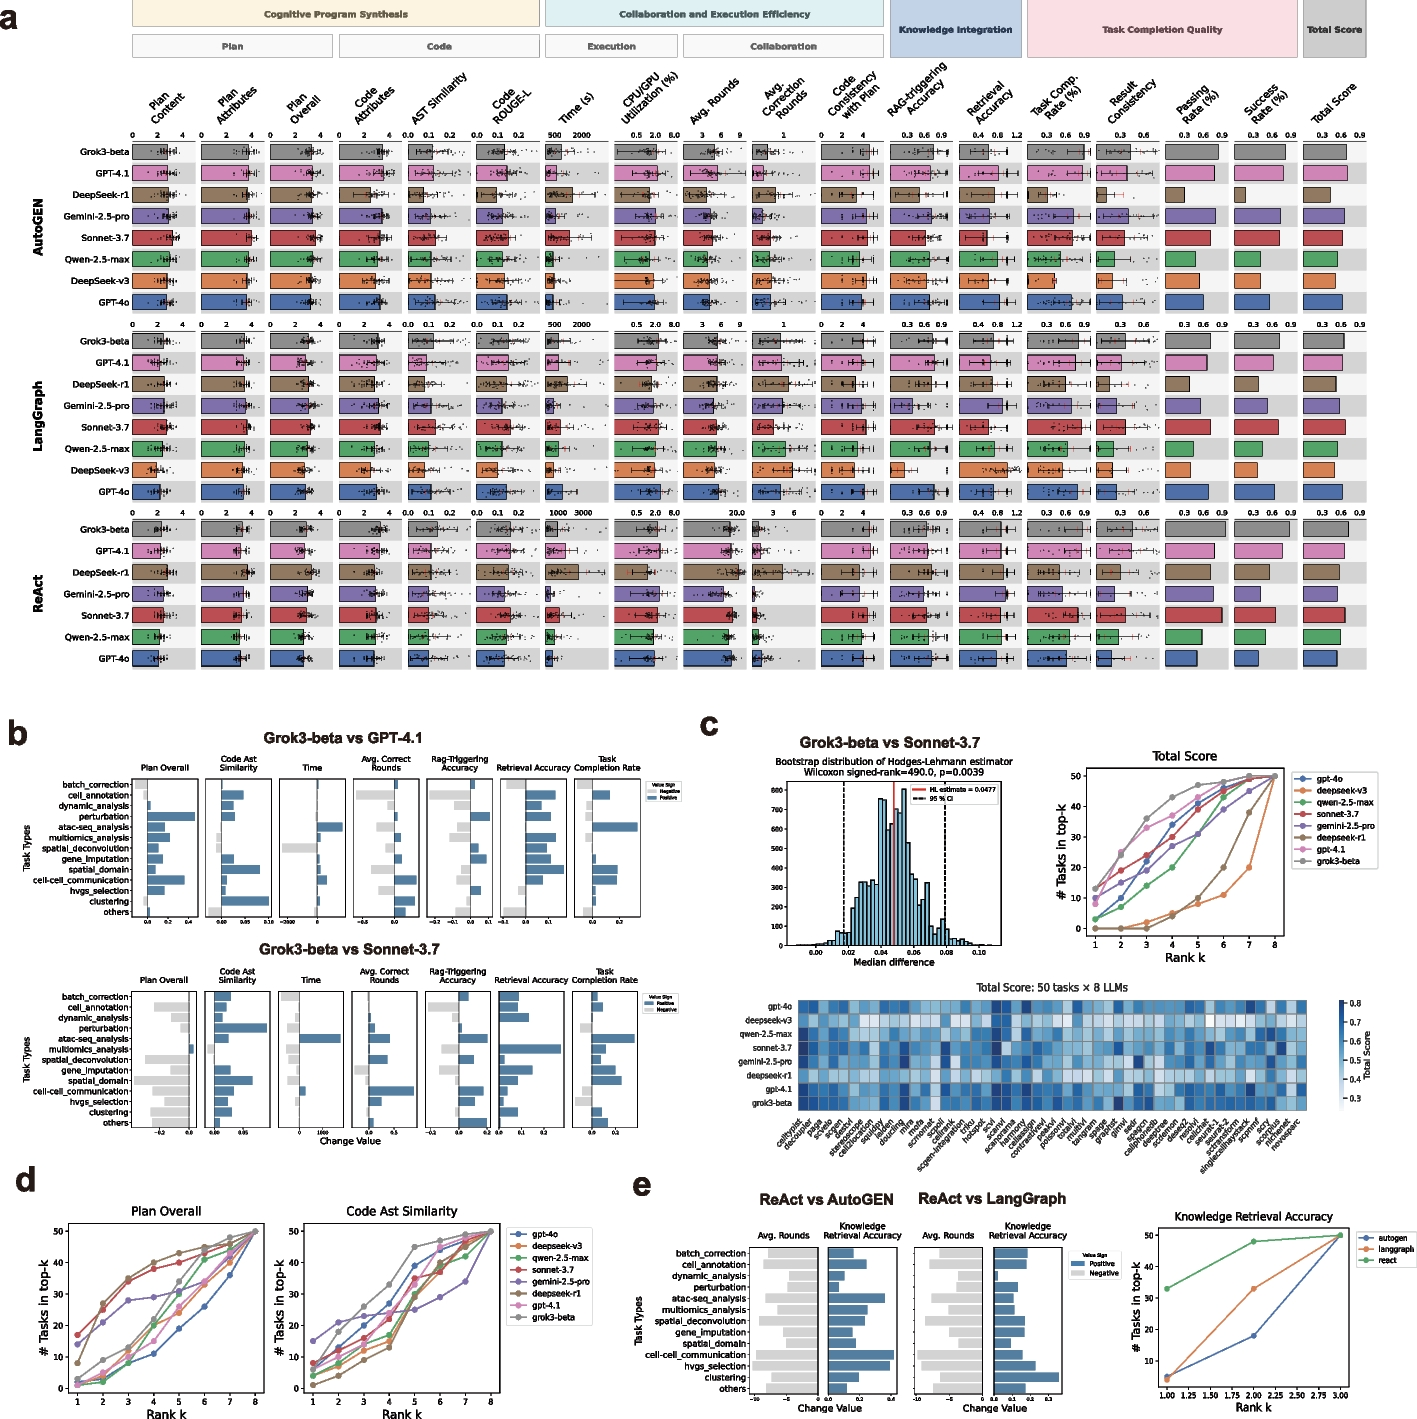 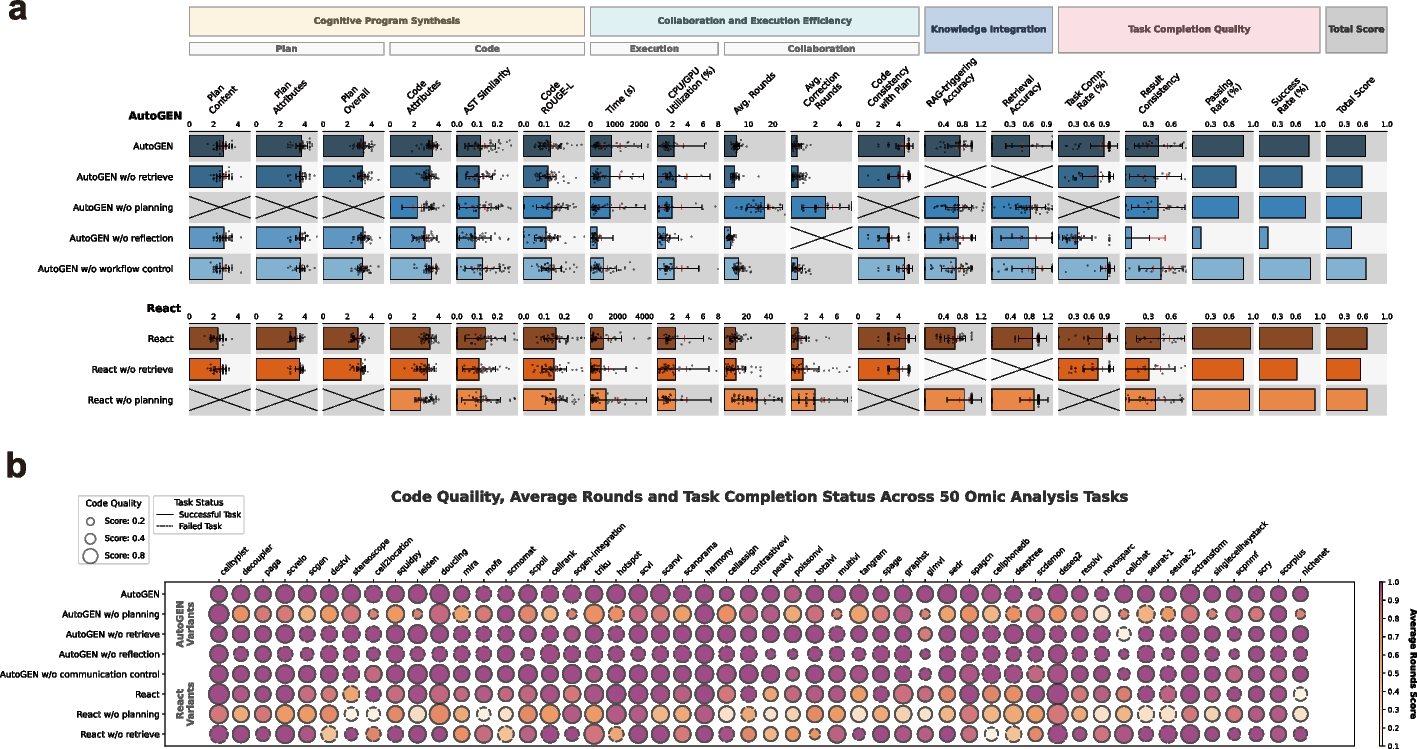 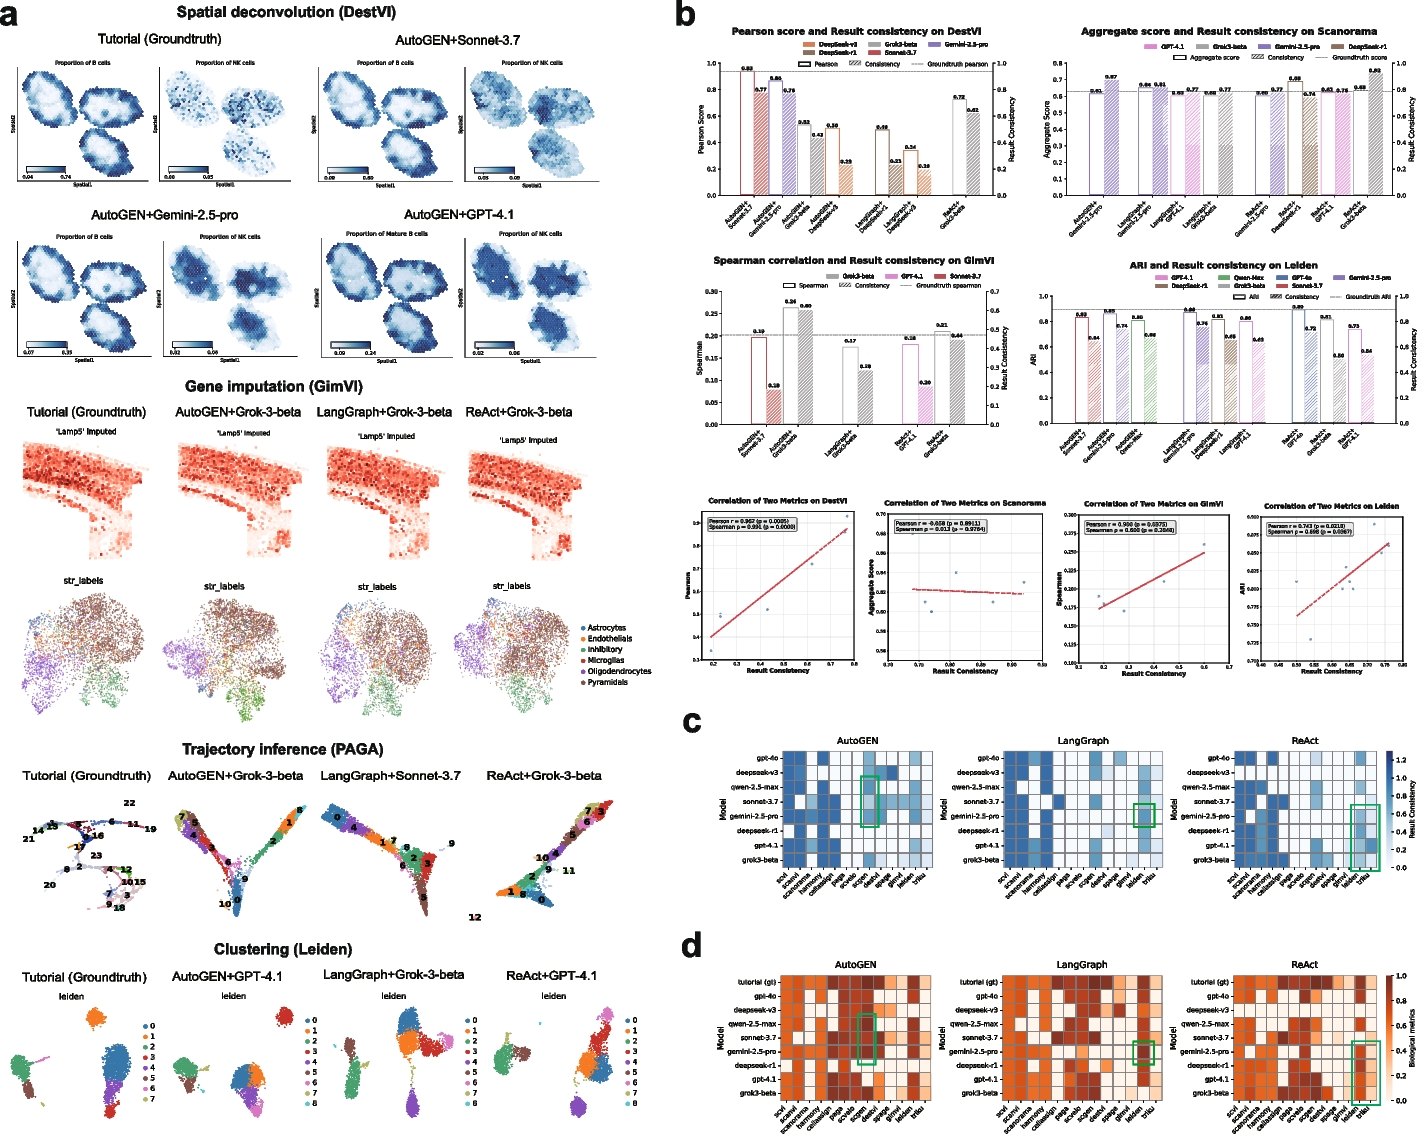 |
 回复此楼
» 猜你喜欢
 Calderasib理化性质与实验操作技术笔记
已经有0人回复
-
RMC-6291怎么用?RAS(ON) 三重复合物工具化合物的实验室实操要点
已经有0人回复
-
化学工程及工业化学论文润色/翻译怎么收费?
已经有86人回复
-
苯并呋咱全解析:NBD 荧光衍生化试剂母核的化学特性与实验室应用
已经有0人回复
-
生物质炭与活化剂氢氧化钾混合注意事项
已经有0人回复
-
科研人必读:新一代 KRAS G12C 抑制剂 Olomorasib 的研究进展
已经有0人回复
-
BT-11(Omilancor)研究化合物全解析:从分子结构到实验应用要点
已经有0人回复
-
富马酸贝达喹啉:二芳基喹啉类工具化合物的化学特征
已经有0人回复
-
BT投稿with editor状态快两周了,正常吗
已经有25人回复
-
Silevertinib(BDTX-1535)结构拆解:炔基双环片段为何成为合成瓶颈
已经有0人回复
-
RO4929097 解析:双苯并氮杂䓬骨架与 Notch 通路实验设计要点
已经有0人回复
