









| 查看: 60 | 回复: 2 | |||
| 【有奖交流】积极回复本帖子,参与交流,就有机会分得作者 peterfxmc 的 3 个金币 ,回帖就立即获得 1 个金币,每人有 1 次机会 | |||
[交流]
百万单元软组织模型一装配就爆内存:生物力学血流仿真遇上大模型本地部署工作站
|
|||

|
百万单元软组织模型一装配就爆内存:生物力学血流仿真遇上大模型本地部署的工作站原来一直都选错了 一、先说一个得罪人的判断:买贵的往往最省钱 做生物力学建模的课题组,配机器最容易犯的错,错在方向上。 这个领域有个很拧巴的特点:模型建在医学影像上,求解靠有限元和计算流体力学,发文章还要看工作流里能不能塞进去一个大模型助手做文献挖掘和报告生成。三种负载,三种硬件脾气。很多人按传统仿真工作站的思路配机器,CPU 堆得很猛,内存留得勉强,显卡随便插一块亮机卡,结果求解器跑起来了,本地的模型助手却装不下;也有人照 AI 工作站的思路配,显卡拉满,内存只有 64GB,百万单元的软组织模型一装配就爆内存。 修一次这种错配,代价远高于一开始买对。爆了内存加内存,发现通道数和频率不匹配;显卡装不下大模型,换卡发现电源功率不够;课题组排队等算例,再等一轮采购流程,一个学期就过去了。所以这篇文章开头先把话说重一点:在生物力学建模这个场景,买贵的往往最省钱——前提是你贵的方向得对。 下面用四个疑问把这件事讲清楚。 二、疑问一:生物力学建模到底在算什么,配置凭什么这么高 先看一个真实的研究动态。2026 年 9 月,上海交通大学生物医学工程学院发布消息:涂圣贤教授团队(心血管创新器械与智能计算 CIIIC 实验室)在人工智能赋能心血管精准诊疗领域取得系列研究进展,研究围绕冠脉造影生物力学、人工智能辅助光学相干断层成像(OCT)定量分析以及冠脉粥样硬化斑块智能分割等领域展开,成果发表于欧洲介入心脏病学会官方期刊 EuroIntervention 和医学人工智能期刊 Artificial Intelligence in Medicine,团队黄佳悦博士、代若冰博士生分别为相关研究的第一作者;黄佳悦博士还凭借基于 AI 的 OCT 斑块负荷定量研究,获得 2026 年欧洲心脏病学会年会(ESC)人工智能心脏病学领域青年研究者奖冠军,相关论文已被 European Heart Journal – Digital Health 接收。 这条新闻值得做生物力学的人多看两眼。它说明一件事:当代心血管生物力学研究的工作流已经变了——影像进来,OCT、CT、造影数据先过 AI 分割,再建几何模型,再做血流动力学和斑块应力分析,最后还要用 AI 做定量评估。整条链路上每一段都在吃算力,而且吃的地方不一样。 把这条工作流拆开看,典型任务大致是这几类: 任务类型 典型工具 计算特征 主要硬件压力 肌骨结构静力分析 Abaqus/ANSYS 隐式求解,接触非线性,迭代收敛慢 CPU 多核 + 大内存 + 内存带宽 心血管血流动力学 Fluent/STAR-CCM+/OpenFOAM 瞬态 CFD,心脏周期逐时间步推进 CPU 多核,网格量上去后内存需求陡增 冲击/碰撞显式分析 LS-DYNA/Abaqus Explicit 显式积分步长极小,天然并行 核数越多越好,高频也重要 影像分割与 AI 定量 nnU-Net/自研网络 GPU 训练+推理,显存占用高 GPU 显存与算力 多尺度建模 0D-1D-3D 耦合 模型装配复杂,数据交换量大 单核性能 + 内存容量 软组织是生物力学建模里最磨人的对象。血管、韧带、椎间盘这些组织是超弹性材料,本构关系非线性,单元一多,刚度矩阵的病态程度就上去,求解器迭代次数跟着翻倍。心血管血流还要再叠一层流固耦合:血管会变形,血液是非牛顿流体,心脏一个搏动周期要分成几百个时间步,每个时间步都要求解一次流场。这类计算的规模要按"多少个心脏周期"来估——一个周期算两三天,做参数研究动辄上百个周期。 所以疑问一的答案是:配置高,是因为这个方向的计算量本来就长这样。觉得配置夸张的人,多半只算了建网格的时间,没算求解的时间。 三、疑问二:CPU 和 GPU,到底谁是主角 这个问题在生物力学场景有个清晰的答案:分阶段看。 一个有限元模型的生命周期是三幕剧。第一幕前处理:CT 或 MRI 图像分割、几何重建、网格划分。这一步吃的是单核性能和内存容量,Mimics、Simpleware 这类软件对单核频率敏感,核心多没用,核快才有用。第二幕求解:隐式求解器吃多核和内存带宽,Abaqus Standard 这类求解器在 16 到 32 核之间能拿到不错的加速比,超过 64 核后并行效率明显衰减;显式求解器胃口更大,LS-DYNA 在百核以上仍有可观的加速。第三幕后处理:应力云图、流场可视化、动画输出,这一步重新偏向单核加显卡。 GPU 的角色近年一直在涨。CFD 求解器带 GPU 加速后,单卡抵几十核 CPU 的情况并不少见;AI 分割模型训练和推理更是完全在 GPU 上跑。但 GPU 替代不了大内存:百万单元的软组织装配模型,单个自由度上百万、接触对几百对,内存需求轻松越过 128GB,这类负载没有任何显卡能帮上忙,只能靠内存容量硬扛。 还有一个容易被忽略的指标:内存带宽。双路服务器两颗 CPU 共享好几通道内存,带宽上去了,稀疏矩阵求解里大量的 gather/scatter 操作才不会卡在数据搬运上。很多课题组只盯着核心数,买回去的机器核多带宽低,求解时间反而比核少带宽高的机器长。 一句话总结:CPU 决定下限,内存决定上限,GPU 决定工作流里 AI 那一段快不快。三者缺一个,机器就偏科。 四、疑问三:先用服务器或者云凑合一下行不行 很多学生第一反应是:课题组不是有学院服务器吗,排队用不就行了。排队恰恰是问题。生物力学的计算有个特点:单个任务跑十几个小时是常态,几十个心脏周期、几十组参数排队下来,一个月很快就没了。做课题的人最怕算到一半发现边界条件设错了,全部推倒重来——重来的队伍要重新排。 云租用的麻烦在数据。医学影像数据有伦理审批和脱敏要求,冠脉 OCT、CT 数据往云端传,审批流程就得先走一轮;传输几百 GB 的影像和结果文件本身就是按天计的时间成本。长期高频使用的话,按小时计费的云端高主频实例加数据传出费用,两年下来够买半台机器。 本地工作站的意义就在于把排队时间变成零,把数据留在屋里。尤其对涉及患者数据的医工交叉课题,数据不出实验室这一条,就足以否掉大部分云端方案。 五、疑问四:自己攒一台和品牌工作站差在哪 自攒机在纸面价格上确实便宜,但生物力学负载有几个特点让自攒机很吃亏。 第一是长时间满载稳定性。隐式非线性求解一次跑十几二十个小时,CPU 全程满载,供电和散热的余量不够,跑十小时崩一次,前面全白费。第二是内存兼容性:四通道、八通道插满高容量条,自攒平台点不亮或降频的案例比比皆是,而这类负载偏偏最吃内存带宽。第三是ECC:软组织模型的计算周期动辄几天,中途一位翻转改一个单元的数据,结果悄悄错了你都不知道,有 ECC 和没 ECC 在这类负载上是质变。第四是售后:求解器半夜报错,第二天要交结果,品牌机一个电话有人来修,自攒机只能自己排查。 省下来的购机差价,会在某次深夜崩溃里连本带利还回去。这就是"买贵的反而省钱"的另一半逻辑。 六、大模型本地部署:给生物力学工作流配一个不出门的助手 前面那条团队新闻里藏着一个信号:分割、定量、分析之间的界限正在模糊,AI 嵌进仿真的每个环节。对普通课题组来说,实际问题是助手怎么真正用起来。 先说为什么必须本地部署。一是数据隐私:课题组的影像和病历数据带伦理审批约束,本地部署数据不出域,审批好过关。二是长期成本:文献挖掘、建模脚本生成、结果报告撰写都是高频调用,云端 API 按 token 计费,一年账单不难算。三是离线可用:临床现场网络不可控,本地模型随时能跑。 模型选型上,两个开源模型够用。阿里通义千问的 Qwen3-30B-A3B,2025 年 4 月发布的 MoE 模型,总参数约 305 亿、每步推理只激活约 33 亿,支持思考/非思考双模式,复杂推理能力明显强于同体积稠密模型,当深度助手。深度求索的 DeepSeek-R1-Distill-Qwen-14B,基于 Qwen2.5-14B 蒸馏的 140 亿参数推理模型,做文献摘要、脚本注释、结果解释足够顺手,当日常帮手。 显存账要会算: 所需显存 ≈ 参数量(B) × 量化字节数 × 1.2 FP16、Q8、Q4 每参数分别占 2、1、0.5 字节,1.2 是 KV cache 与系统开销的预留。套到这两个模型上: 模型 FP16 Q8 Q4 Q4 舒适档 DeepSeek-R1-Distill-Qwen-14B(14B) 约 34 GB 约 17 GB 约 9 GB 12~16 GB 显存 Qwen3-30B-A3B(总参数 30B) 约 73 GB 约 37 GB 约 19~22 GB 24 GB 显存起步 注意它是 MoE:显存按总参数 305 亿算,激活参数再小也省不了显存,MoE 省的是算力。三档量化里,FP16 无损但体积翻倍,Q8 折中,Q4 是消费级显卡默认选择——精度损失在大多数文本任务里感知不强,换来显存砍半。解码速度由显存带宽决定:纯 CPU 推理只有个位数 tokens/s,一张中端 GPU 能拉到几十 tokens/s,写报告的等待体验是两个世界。 最后分清推理和微调。LoRA 给 14B 模型做领域适配,显存增量只要 3~5 GB;全参数微调 14B 则要上百 GB 显存,30B 更数倍于此。这决定配置档位上不上探:只推理,单张 24 GB 卡覆盖这两个模型;想全参数微调,就得奔多卡平台。 七、结合这些负载特征,配置该怎么选 聊了这么多技术细节,最后还是得回答那个实际问题:一台能同时吃下生物力学建模和本地大模型推理的机器,大概长什么样。原则是按工作流分段配平——前处理要高频,求解要核和内存带宽,AI 段要显存,哪个短板都会让另外两段的投入打水漂。下面这几档按课题组规模从小到大排列,各档之间留了一条平滑的升级路线。 方案A:个人与小课题组入门档 适用场景:个人研究生或两三人小课题组;几十万单元的教学级模型、单部位静力分析;日常跑 DeepSeek-R1-Distill-Qwen-14B 做文献挖掘,Qwen3-30B-A3B 量化推理留有余量。 硬件类别 具体配置 说明 CPU Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷 24 核高主频,隐式求解与前处理单核段的均衡选择 GPU RTX5090D v2 24GB+水冷 24GB 显存覆盖 14B 的 Q4/Q8 与 30B 级 Q4 推理 内存 128GB DDR5 几十万单元教学级模型的装配与求解容量 存储 4TB NVME + 8TB SATA NVMe 跑求解临时文件,SATA 存医学影像数据 显存 24 GB Qwen3-30B-A3B Q4 约 19~22GB 加 KV cache 的起步线 显存带宽 1.34 TB/s 推理解码带宽,决定文献挖掘与报告生成的等待时间 推荐机型:A350 153128-MCT 硬件解析:入门档的思路是"仿真为主、AI 够用":24 核高频 CPU 带得动几十万单元的静力分析,128GB 内存守住隐式求解的装配底线,24GB 显存恰好覆盖 DeepSeek-R1-Distill-Qwen-14B 的 Q4/Q8 量化与 Qwen3-30B-A3B 的 Q4 量化。个人或小课题组的第一台机器,仿真和助手两头都不偏科。 方案B:课题组主力仿真档 适用场景:三到八人的课题组主力机;百万单元级肌骨或心血管模型,静力、模态、瞬态 CFD 常规求解;AI 助手部分覆盖 14B 量化推理,30B 级推理建议走组内更高档机器。 硬件类别 具体配置 说明 CPU AMD锐龙TR PRO 7985WX (64核4.8GHz) 64 核 4.8GHz,落在隐式求解高效区间上沿,显式求解核数有余量 GPU RTX A2000 12GB 后处理可视化与轻量推理,30B 级推理留给组内更高档机器 内存 256GB DDR5 百万单元级软组织模型装配的容量保障 存储 4TB NVME + 8TB SATA 高速盘跑瞬态 CFD 时间步,SATA 归档影像与结果 显存 12 GB 14B 模型 Q4 量化可部分覆盖 显存带宽 288.0 GB/s 满足图形显示与轻量计算 推荐机型:GR450P 148256-MCB 硬件解析:方案B 是一台纯粹的求解机器:64 核 4.8GHz 的线程撕裂者 PRO 落在隐式求解高效区间的上沿,显式动力学还有核数余量;256GB 内存是百万单元软组织模型装配的硬门槛。显卡刻意收敛为专业亮机卡——这台机器的分工就是算,AI 推理交给组内更高显存的机器,预算全部堆在求解链路上。三到八人课题组的主力仿真档,钱花在了求解时间的刀刃上。 方案C:大规模多物理场与深度推理档 适用场景:多物理场耦合、千万单元级完整器官建模、显式动力学批量计算;本地同时服务 Qwen3-30B-A3B 深度推理,并为 LoRA 领域微调留出空间;适合承担重点项目的中大型课题组。 硬件类别 具体配置 说明 CPU 2×AMD霄龙9575F (128核4.5GHz) 双路 128 核 4.5GHz,千万单元器官建模与显式批量计算的算力核心 GPU RTX 4090 48G 48GB 显存单卡覆盖 Qwen3-30B-A3B 的 Q4/Q8 量化推理与 LoRA 微调 内存 640GB DDR5 千万单元或流固耦合问题的内存余量 存储 系统盘 8TB NVME(14GB/s) 数据盘 20TB SATA 14GB/s 系统盘扛瞬态求解的密集 IO,20TB 数据盘存影像与结果 显存 48 GB 30B 级模型 Q4/Q8 量化推理与 LoRA 微调的容量前提 显存带宽 1.01 TB/s 深度推理与分割训练的带宽底座 推荐机型:AlphaPro660 345640-MDT 硬件解析:方案C 是"大规模求解+深度推理"的双主力配法:双路霄龙 128 核把千万单元级器官建模和显式批量计算的时间压到可接受范围,640GB 内存让流固耦合不再卡容量;48GB 显存的 RTX 4090 同时接住 Qwen3-30B-A3B 的 Q4 量化深度推理和 LoRA 领域微调,影像分割训练也落在这张卡上。承担重点项目的课题组,求解和 AI 两段都不需要向邻居借机器。 方案D:多人共享与模型服务平台档 适用场景:平台级共享,仿真求解、影像分割训练、大模型推理多线并发;支持 70B 级量化模型推理与多模型同时在线,供十几人规模的研究单元同时在线使用。 硬件类别 具体配置 说明 CPU 2×Xeon金牌6530 64核2.7-4G 双路 64 核,多任务并发时求解器的调度底座 GPU 4×RTX 6000D 84G 四卡 336GB 显存池,70B 量化推理与多模型同时在线的平台 内存 512GB DDR5 十几人并发时仿真、分割、推理共享的内存池 存储 8TB NVMe 多线并发的模型权重、影像与结果存储 显存 336G 70B 级模型 Q4/Q8 推理与多模型并发的聚合显存 显存带宽 4×1.6TB/s 每卡 1.6TB/s,多人同时推理的吞吐保障 推荐机型:GX660M 227512-MD4E 硬件解析:方案D 把工作站做成了平台:四张 RTX 6000D 84GB 组成 336GB 显存池,70B 级量化推理和多模型同时在线第一次成为常规能力;双路 Xeon 加 512GB 内存,供十几人规模的仿真、影像分割训练、大模型推理多线并发。数据不出实验室、排队时间归零、助手永远在线——共享平台的三个诉求在这套配置里同时闭环。 八、常见问题 内存 128GB 到底够不够 看单元数和接触对数量。几十万单元的线性问题 64GB 都宽裕;百万单元加接触非线性,128GB 是起步线;千万单元或流固耦合,直接按 256GB 以上规划。内存是这个负载里最难后期补救的部件,宁可多买,不要将就。 Abaqus 这类隐式求解器吃多少核合适 常规经验在 16 到 32 核之间收益最好,64 核以后加速比增长明显放缓。与其堆上百核跑隐式,不如把预算挪到内存容量和内存带宽上。显式求解器反过来,核数上不封顶,按需堆。 游戏卡能用来做分割模型训练吗 能,但有前提。消费级卡 24GB 级显存做分割训练够用,本地推理更不在话下;但一周七天、一天二十小时的满载训练,消费卡的稳定性和驱动支持不如专业卡。预算紧可以先用游戏卡起步,量上去了再换。 大模型量化到 Q4,结果还能用吗 文本类任务里 Q4 的精度损失大多数场景感知不到,文献摘要、代码生成、报告撰写都稳。涉及精确数值复述的任务可以切 Q8 或 FP16,前提是显存装得下。 求解器总是不收敛怎么办 先查边界条件和接触定义,再查网格质量,最后才怀疑硬件。生物软组织模型的不收敛九成是建模问题。硬件层面能做的是给求解器更多内存余量,避免大变形步里内存耗尽被强杀。 九、结语 回到开头那句得罪人的话:买贵的往往最省钱。生物力学建模这个方向的算力账,买得贵不贵要看错配一次会付出多少时间。求解器排队一个学期、模型助手装不进显卡、深夜崩溃重跑三天——这些才是账单的大头。方向买对,贵就是便宜;方向买错,便宜就是最贵。 关于 UltraLAB:UltraLAB(西安坤隆计算机科技有限公司)是国内知名高端定制图形工作站厂家,面向光学设计、计算光学、光子学、人工智能等领域提供:工具链→算法路径→硬件 精准匹配的专业计算平台,支持预装开源软件栈与多机集群交付。 www.hpctop.com 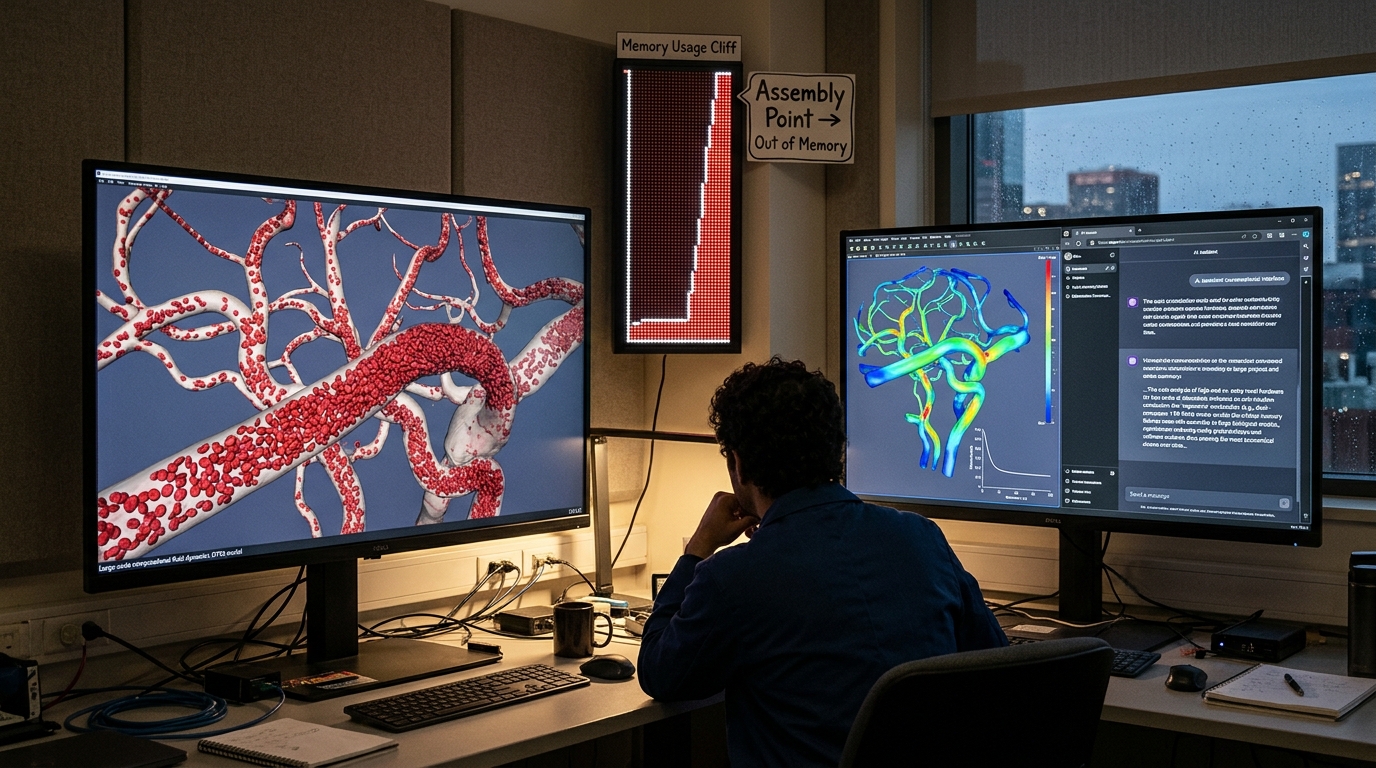 |
 回复此楼
» 猜你喜欢
 售SCI-T0P文章,我:8O.5.5.1.O.54,科目齐全,可+急
已经有16人回复
-
售SCI文章,我:8O.5.5.1O.54,科目全,可十急
已经有21人回复
-
越来越担心硕士毕业后没有竞争力了
已经有14人回复
-
论文的挂名怎么评判贡献?基金申请中,排名第一的挂名文章
已经有3人回复
-
申博自荐 2篇一区TOP+1篇EI+2公开发明专利 2027博士申请
已经有3人回复
-
闲聊
已经有6人回复
-
申博求助
已经有4人回复
» 本主题相关商家推荐: (我也要在这里推广)
简单回复
ckxbear2楼
2026-10-30 16:27
回复
peterfxmc(金币+1): 谢谢参与

2026-10-30 19:04
回复
peterfxmc(金币+1): 谢谢参与