









| 查看: 76 | 回复: 5 | |||
[交流]
贝叶斯计算与MCMC采样怎么选工作站 统计学大数据分析建模的决策树与本地部署方案
|
|||

|
贝叶斯计算与MCMC采样怎么选工作站 统计学大数据分析建模的决策树与本地部署方案 三个问题,定位你的工作站 动笔之前,先把结论放在前面:给统计学课题选工作站,不需要懂每一颗CPU的架构,也不需要背显卡天梯图。回答三个问题,答案组合起来,配置就定了。 问题一:你的数据有多大?--决定内存容量。 问题二:你的推断走哪条路?--决定CPU和显卡怎么分钱。 问题三:要不要在本地跑一个大模型助手?--决定显存底线。 下面把三个节点逐个拆开算。赶时间的读者,可以直接跳到后面的配置速查表,按自己的答案组合对号入座。 一篇JRSS-B论文背后的计算账 2026年10月,华中科技大学数学与统计学院官网发布了一条学术动态:该院青年教师赵花丽的文章《Augmented transfer regression learning for completely missing covariates》在统计学顶刊《Journal of the Royal Statistical Society Series B: Statistical Methodology》(JRSS-B)在线发表。论文针对的是一个越来越常见的问题:UK Biobank、All of Us Research Program 这类大规模人群数据库,往往缺乏特定分析所需的协变量,比如遗传或生活方式指标,而相关的其他研究测量了这些变量。目标人群的关键协变量完全缺失,回归推断还能不能做? 论文给出的答案是增强迁移回归学习:把重要性加权估计方程和一阶、二阶矩的插补项结合起来,得到的估计量具有双重稳健性--密度比模型或两个插补模型只要有一方设定正确,估计结果仍保持一致;两方都正确时,估计达到半参数效率界。方法本身值得细读,这里更值得关注的是它背后的计算账。 第一,数据量级被严重低估。UK Biobank 有50万级参与者、数千个变量。原始数据文件或许只有几个GB,但统计建模要加载的远不止原始文件。设计矩阵加入样条基函数展开和交互项后,列数从几千膨胀到几万,一个副本就是几十GB。 第二,验证环节的内存峰值不可预测。这类方法的论文都要做蒙特卡洛模拟研究,验证有限样本性质:成百上千次重复实验,每次都重新估计、重新算标准误。再加上 Bootstrap 重抽样、交叉验证,每个环节都在原始数据上叠副本。写代码时内存占用看着只有20GB,跑到第三轮重抽样,临时对象一叠加,直接冲过100GB。 第三,这类方法的主战场在CPU。Stan 的 NUTS 采样器、PyMC 的 MCMC、R 的 brms,经典贝叶斯推断工具长期运行在CPU上。显卡在这条路线上长期缺席--这个认知对选配硬件至关重要。 换句话说,一篇“纯统计“的论文,背后的算力需求并不比仿真类课题温柔。内存不够,模拟研究跑不完;主频太低,一条链磨一天。下面三个决策节点,就是把这笔账算清楚。 决策节点一:你的数据有多大 数据量决定的第一件事是内存容量,硬盘容量排在后面。硬盘装得下、内存放不下,等于白搭。 统计计算有个特殊之处:内存占用常常达到原始数据的十倍以上。原因有三个。一是设计矩阵膨胀,连续变量做样条展开、类别变量做独热编码,列数翻几十倍。二是 MCMC 要保存整条马尔可夫链,几万次迭代的参数向量全在内存里,事后做收敛诊断、后验预测检查,又衍生出一批副本。三是验证环节的复制操作,Bootstrap、K折交叉验证、多重插补,每个都在原始数据上叠加副本。 按经验分三档。数据量在10GB以内,128GB内存绰绰有余,课程作业、模拟研究、小型问卷调查都在这个区间。数据量在10~100GB,这是观测统计的主流区间,一个队列数据、几年的高频金融数据、几十万人的健康调查,加上建模中间变量普遍落在这里,建议192GB内存起步。数据量超过100GB,你已经在和 UK Biobank 这类人群队列打交道,512GB内存是务实起点--Bootstrap 和插补的副本叠加没有规律可循,留一半余量是让模拟研究能跑完的基本条件。 还有一个容易忽略的指标:内存通道数。MCMC 多链并行时,每条链独立读写各自的链状态,内存带宽直接决定并行效率。同样128GB内存,双通道和八通道的机器跑八条并行链,效率差出一大截。这解释了为什么有些配置内存容量相同、平台不同,跑起统计计算的差距却很明显--差在通道数和带宽上。 决策节点二:你的推断走哪条路 同样叫贝叶斯计算,不同算法对硬件的胃口完全不同。 第一条路,传统 MCMC 全量采样。Stan 的 NUTS、PyMC 的 Hamiltonian Monte Carlo,当前应用统计的主流。计算特征很鲜明:单条链内部是串行的,每一步都要算梯度、做 leapfrog 积分;链与链之间天然独立,可以并行。翻译成硬件语言--单核主频决定一条链跑多快,核心数决定能同时跑几条链。一台高主频CPU跑四条链,和一台低频服务器CPU跑四条链,出结果的时间差一倍。显卡在这条路线上帮不上忙,预算别往显卡倾斜。 第二条路,大数据近似推断。数据大到全量 MCMC 算不动时,统计学家的答案是子采样 MCMC、随机梯度 Langevin 动力学、随机变分推断。这些方法用随机小批量替代全量数据,单次迭代便宜,但需要极多次迭代才能收敛。它们吃CPU多核吞吐,对单核主频反而没那么敏感。前面那篇 JRSS-B 论文用到的估计方程框架,工程实现上大量依赖这类批处理计算。 第三条路,概率深度学习。贝叶斯神经网络、深度生成模型、基于 JAX 的 NumPyro 大规模变分推断,这是近几年统计学和机器学习合流的产物。这条路GPU是主角:显存决定能装多大的模型和数据分块,GPU算力决定每次迭代的耗时,32GB显存在这条路线上是入门线。 三条路并不互斥。一篇论文可能先用 Stan 做基准模型,再用随机梯度方法扩到全量数据,最后用贝叶斯神经网络做对照。配置留余量的原因就在这里--你的课题不会永远停在第一条路上。 决策节点三:要不要在本地跑一个大模型助手 这个问题五年前不存在,现在绕不开。 统计学课题组用大模型做什么?很具体:让模型读论文的方法部分,生成 Stan 或 PyMC 的模型骨架;把英文变量字典翻译成数据清洗脚本;帮研究生排查发散转移、收敛警告这类调试难题;润色统计报告的方法学描述。这些任务公共API都能做,但统计学课题组多了一条硬约束--数据使用协议。UK Biobank 这类队列数据的使用条款写得很清楚:数据不得离开受控环境,不得上传第三方服务。你的原始数据可以不出门,可你贴进API对话框里的变量名、代码片段、数据结构描述,同样是数据的一部分。 所以问题变成了“选哪个级别“。32B级模型已经能应付统计代码生成和方法学问答,70B级在复杂推理和长文献处理上更稳。显存预算从这一节的需求推导出来。 大模型本地部署:统计课题组的第二台“仪器“ 先说为什么本地部署在这类课题组是刚需而非尝鲜。一是数据协议约束,队列数据的相关信息不能进第三方对话框,本地模型让数据不出门、助手进课题组成为可能;二是长期成本,方法调研加代码调试常年累积,API账单超过一张显卡的钱并不罕见;三是离线可用,出差、野外调查、机房断网时本地模型照常工作。 模型选型建议盯两个真实开源模型。一个是阿里巴巴2025年4月发布的 Qwen3-32B,总参数32.8B的稠密架构模型,原生32K上下文、YaRN 扩展后可达131K,Apache 2.0 许可证,统计代码生成和方法学问答表现扎实。另一个是 Meta 2024年12月发布的 Llama-3.3-70B-Instruct,70B参数、128K上下文、采用 GQA 注意力机制,长文献综述和复杂方法推理明显强于32B级。 显存怎么估?记住一条公式:所需显存约等于参数量(B)乘以量化字节数再乘以1.2,1.2是 KV cache 和系统开销的预留系数。套到这两个模型上: 模型 FP16(2字节) Q8(1字节) Q4(0.5字节) Q4舒适档 Qwen3-32B 约64GB 约33GB 约19~22GB 24GB显存 Llama-3.3-70B-Instruct 约140GB 约70GB 约39~43GB 48GB以上或双卡 量化等级直接决定显存压力。FP16精度最高但体积翻倍,Q8在多数基准上几乎无损,Q4是消费级显卡的默认选择--在通用推理任务上精度损失通常在可接受范围,换来的是显存砍掉四分之三。经验口径:Q4下每10亿参数约0.6GB。 速度上要有数量级概念。CPU纯内存跑70B模型,解码速度只有个位数 tokens/s,写一段话要几分钟,只能当离线备胎;单卡GPU推理能达到几十到上百 tokens/s,才谈得上日常使用的流畅度。这也解释了为什么“能装下“和“能用好“是两回事。 最后区分推理和微调。用 LoRA 对32B模型做统计领域适配,显存增量约3~5GB,一张24GB卡既能推理又能轻量微调;全参数微调70B则要多张数据中心显卡,显存需求数倍于推理,那是训练平台的事,不属于单工位工作站的范畴。想清楚停在推理还是摸到微调,档位就能定死。 软件清单:先把工具链搭起来 统计计算的软件栈比仿真类轻得多,但环境混乱是出了名的。R 和 Python 双语言并行是常态:R 负责 brms、rstan、 posterior 这一套贝叶斯生态,Python 负责 PyMC、NumPyro、ArviZ 和 JAX。建议用 conda 或 pixi 做环境隔离,Stan 单独装 CmdStan 保持版本可控。可视化诊断用 ArviZ 或 bayesplot,大规模数据预处理可以借助 polars 或 DuckDB,比 pandas 省一半内存。操作系统选主流 Linux 发行版或 Windows 加 WSL2 都可以, Stan 和 PyMC 在两边的支持都成熟。 配置速查表:按决策组合对号入座 聊到这里,那个最实际的问题该回答了:具体到我的课题,配一台什么样的机器?三个决策节点组合起来有四种典型画像,我们把每种画像对应的硬件侧整理成了下面的速查表。没有一步到位的天花板方案,只有跟决策树匹配的组合,按图索骥即可,细节想调整的再在此基础上加减。 组合A:课程数据加纯MCMC采样 适用场景:数据量在10GB以内的课程作业、模拟研究和中小型问卷分析;主用 Stan、PyMC、brms 做全量 MCMC 采样,显卡只负责点亮显示器;暂不部署本地大模型。 硬件类别 具体配置 说明 CPU Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷 高主频性能核直接决定单条MCMC链的迭代速度,24核余量支撑四条以上并行链。 GPU Quadro T400 纯MCMC路线显卡只负责点亮显示器,预算集中在CPU和内存上。 内存 128GB DDR5 覆盖10GB以内数据十倍以上膨胀的设计矩阵与链状态,Bootstrap副本叠加也兜得住。 存储 4TB NVME (14GB/s) 高速系统盘放分析脚本与链状态,原始数据单独归档,读写互不挤占。 显存 4 GB 亮机级别显存,本期不部署本地大模型,不构成瓶颈。 显存带宽 80.00 GB/s 亮机卡带宽,对CPU侧的MCMC链路无影响。 推荐机型:A350 156128-MCA 硬件解析:这套配置把每一分预算都押在MCMC的主战场上——高主频性能核加速单链,128GB内存兜住副本叠加,显卡只留亮机级别。数据量在10GB以内、推断路线纯CPU的课题,它就是务实起点。 组合B:观测数据加混合推断加32B助手 适用场景:数据量10~100GB的队列分析和金融统计;MCMC 与随机变分推断混用,需要GPU跑 NumPyro 小批量加速;本地部署 Qwen3-32B 做代码生成与方法学问答,Q4量化后24GB显存从容覆盖。 硬件类别 具体配置 说明 CPU Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷 高主频性能核保证Stan单链速度,24核吞吐承接随机变分推断的批处理迭代。 GPU RTX5090D v2 24GB+水冷 一张卡同时承担NumPyro小批量加速和Qwen3-32B本地推理,水冷压住持续负载。 内存 128GB DDR5 对应10~100GB观测数据的建模中间变量与链状态,留出合理余量。 存储 4TB NVME + 8TB SATA NVME放系统与链状态,SATA大盘单独存放队列原始数据,只读挂载。 显存 24 GB 正好落在Qwen3-32B Q4量化的舒适档,代码生成和方法学问答从容覆盖。 显存带宽 1.34 TB/s 保证大模型解码速度和GPU小批量迭代的吞吐效率。 推荐机型:A350 153128-MCT 硬件解析:这套配置在MCMC主战场不变的前提下塞进一张24GB显卡,一条线打通两条推断路线——NumPyro小批量加速走GPU,Qwen3-32B本地助手落在Q4舒适档。数据量10~100GB、推断路线混合的观测统计课题,不用在两条路之间做取舍。 组合C:人群队列数据加大数据近似加70B助手 适用场景:数据量百GB级的人群队列和多中心调查;以子采样MCMC、随机梯度Langevin为主的批处理推断,192GB内存承接Bootstrap副本叠加;本地部署 Llama-3.3-70B-Instruct 处理长文献与方法推理,48GB显存是这道线的门票。 硬件类别 具体配置 说明 CPU AMD锐龙9950X3D (16核, 4.8~5.7GHz) +水冷 高主频兼顾单链速度,16核吞吐承接子采样MCMC和随机梯度Langevin的海量小迭代。 GPU RTX 4090 48G+水冷 48GB显存是70B模型Q4量化的门票,概率深度学习路线也能起步。 内存 192GB DDR5 承接百GB级人群队列的Bootstrap与多重插补副本叠加,避免swap拖垮模拟研究。 存储 4TB NVME + 8TB SATA 高速盘读写链状态与中间变量,大容量盘归档队列原始数据,分开管理。 显存 48 GB 覆盖Llama-3.3-70B Q4量化的39~43GB需求,KV cache和长上下文留足余量。 显存带宽 1.01 TB/s 保证长文献综述和方法推理场景下的大模型解码速度。 推荐机型:AR350 148192-MCT 硬件解析:这套配置把内存推到192GB、显存推到48GB,分别对上百GB队列数据的副本叠加和70B模型的Q4门票,两条硬约束一次满足。AMD高主频平台在批处理推断和单链速度之间取了均衡,是人群队列类课题的稳妥解。 组合D:课题组共享平台加蒙特卡洛满负荷 适用场景:整个课题组共用,同时跑蒙特卡洛模拟研究、大规模估计方程推断和多个大模型实例;512GB内存级别应付百GB数据的多重插补与并发任务;72GB显存同时覆盖70B模型Q4推理和概率深度学习的最小可用规模,并发留给师弟师妹的32B实例。 硬件类别 具体配置 说明 CPU 2×AMD霄龙9655 (192核4.1GHz) 双路192核是蒙特卡洛模拟研究和估计方程推断多任务并发的算力底座。 GPU RTX Pro 5000 72G 72GB显存同时覆盖70B模型Q4推理和概率深度学习的最小可用规模。 内存 640GB DDR5 百GB数据的多重插补与多人并发副本叠加,内存余量是共享平台不排队的底线。 存储 系统盘 8TB NVME 数据盘 20TB SATA 系统与分析流程走NVME,海量原始数据归档SATA,共享环境下读写分层。 显存 72 GB 70B Q4主实例之外,还能并发跑课题组其他成员的32B实例。 显存带宽 1.34 TB/s 大模型多实例并发时的解码吞吐保障。 性能指标 CPU C10.7T 整机浮点峰值,蒙特卡洛满负荷长时间运行的底气。 推荐机型:AlphaPro660 241640-MDD 硬件解析:这套配置是课题组共享平台的满配底座——双路192核加640GB内存承接蒙特卡洛与估计方程的并发满负荷,72GB显存同时覆盖70B推理和概率深度学习。它解决的不是单个任务跑多快,而是所有人一起提交任务时谁都不排队、谁都不降频。 常见搭配错误 错误一:数据量选错档。拿着百GB级的队列数据,却只配64GB内存,Bootstrap跑到第二轮就开始swap,固态硬盘被反复读写,模拟研究三天三夜跑不完。数据量这个问题上没有“勉强够用“,副本叠加的规律就是超出预期。 错误二:给MCMC配游戏显卡。Stan 单链吃单核主频,四条链吃四个核,一张两万块的显卡在这个工作流里的贡献约等于零。预算有限时,把显卡的钱挪到高主频CPU和内存通道上,收益立竿见影。 错误三:显存卡着线买。70B模型Q4量化要39~43GB,买40GB显存的卡看似能装下,KV cache 一挤就溢出,长上下文直接报错。要么48GB起步,要么承认自己在赌。 错误四:用游戏本充当课题组共享机。多人排队提交任务,散热压不住持续满载,CPU降频跑MCMC,出结果的时间乘以1.5。共享平台的底线是塔式散热加足量内存插槽,笔记本从来不在选项里。 常见问题 MCMC到底能不能用GPU加速 部分能。NUTS 本体在 Stan 里是CPU实现,但 PyMC 和 NumPyro 支持把梯度计算放到GPU上,概率深度学习更是天然GPU负载。对传统层次模型,GPU加速的收益有限;对大规模变分推断和批处理方法,GPU是必需品。看你的推断路线,别盲目追卡。 内存和显存先升哪个 看瓶颈在哪个节点。经典MCMC工作流先升内存,因为链状态和副本都在内存里;概率深度学习工作流先升显存,模型装不下什么都谈不上。两类任务都做的课题组,先保内存容量,再谈显存。 笔记本能跑Stan吗 能,教学和小规模模拟没问题。但内存上限和散热决定了它跑不动百GB级的观测数据,也撑不起长时间蒙特卡洛模拟。笔记本适合做开发调试,不适合做生产计算。 数据和模型存哪里 系统盘和数据盘分开是底线。原始数据放数据盘,只读挂载;分析脚本和链状态放系统盘,定期归档。队列数据有协议要求,备份策略先读协议再定,别等审计时才发现违规。 结语 回到开头那三个问题:数据有多大,推断走哪条路,要不要本地大模型。选工作站参数最高的那台未必最合适,匹配决策树终点的那台才是。统计学的计算负载看着温和--没有炫酷的渲染画面,没有每秒千万网格的流体,但它对内存余量和CPU主频的挑剔程度,一点不输工程仿真。把三个问题的答案想清楚,剩下的只是按表办事。 关于 UltraLAB:UltraLAB(西安坤隆计算机科技有限公司)是国内知名高端定制图形工作站厂家,面向光学设计、计算光学、光子学、人工智能等领域提供:工具链→算法路径→硬件 精准匹配的专业计算平台,支持预装开源软件栈与多机集群交付。 https://www.hpctop.com/ 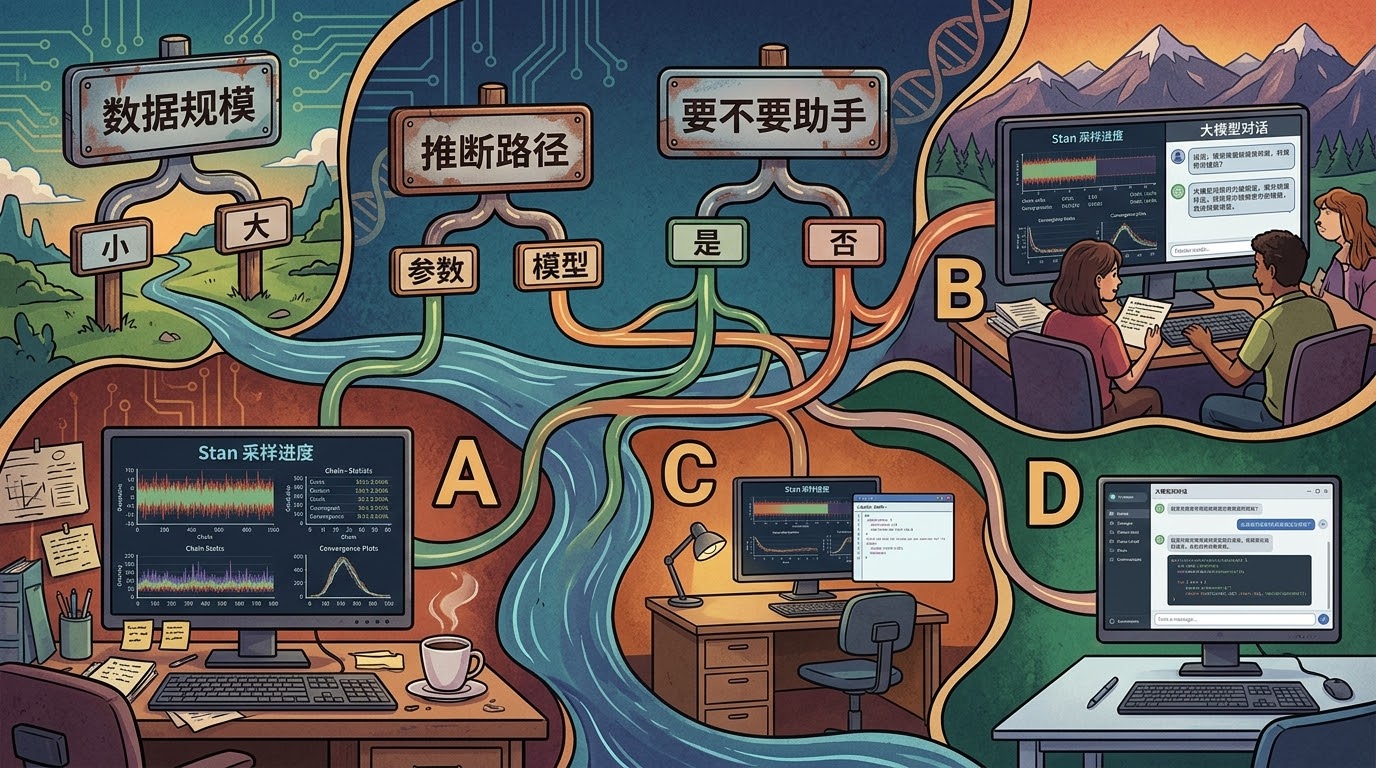 |
 回复此楼
» 猜你喜欢
 求助中医院临床中医中标的青年标书学习,谢谢
已经有6人回复
-
浙大物院表面物理课题组长期招收普博及直博学生
已经有259人回复
-
物理学I论文润色/翻译怎么收费?
已经有232人回复
-
【征稿】Springer Nature热电专题 Discover Materials / Discover Chemistry
已经有47人回复
-
25届硕士申请,材料计算方向
已经有2人回复
-
课题组招1-2名硕士
已经有1人回复
-
机时越来越贵之后,我把一部分 DFT 流程搬到了 AI 计算平台上
已经有0人回复
-
斯坦福大学与Elsevier世界前2%学者新排名查询
已经有1人回复
-
27申博推荐:南京航空航天大学国际前沿院光学方向招收博士生!
已经有19人回复
-
华南师范大学+双一流学科物理学+广东省杰青团队2027年博士招生+机器学习驱动材料设计
已经有1人回复
-
apl投稿状态
已经有2人回复
简单回复
2026-10-28 18:33
回复
peterfxmc(金币+1): 谢谢参与

庚辰辛丑3楼
2026-10-28 18:47
回复
peterfxmc(金币+1): 谢谢参与
tfang4楼
2026-10-28 20:47
回复
peterfxmc(金币+1): 谢谢参与
lymjjh5楼
2026-10-28 22:29
回复
peterfxmc(金币+1): 谢谢参与

psylhh6楼
2026-10-28 23:00
回复
peterfxmc(金币+1): 谢谢参与