









| 查看: 42 | 回复: 0 | |||
[交流]
Nature Methods|扰动预测基线复核:复杂模型为何没有胜出
|

|
▍导读 2025 年,海德堡大学 BioQuant 与欧洲分子生物学实验室(EMBL)团队在 Nature Methods 报告:在单基因与双基因扰动的转录组变化预测上,五个单细胞基础模型与两个深度学习模型在相应任务中均未超越故意设得极简的均值、线性或加性基线。研究以 L2 距离、Pearson delta 与遗传互作识别为评测,发现基础模型的双扰动预测误差普遍高于加性期望,互作识别也不及“无变化”基线;单细胞图谱预训练相对随机嵌入增益有限,而扰动数据预训练提升明显。作者据此强调批判性基准比较对方法发展的必要性。 ▍研究背景 大语言模型在知识表示上的成功推动了基础模型概念向生物学迁移,已有若干基于千万级单细胞转录组数据训练的通用模型,其中 scGPT 与 scFoundation 明确宣称能够预测基因扰动引起的表达变化。 扰动效应预测被视为虚拟细胞方向的关键能力:它要求在未见过的单基因扰动、乃至两个基因同时被扰动的组合上,给出可用的表达变化估计,用于解释遗传互作与筛选候选干预。 然而此前的模型评估常缺少足够严格的对照,例如把本不擅长未见扰动的模型纳入比较、或让对照线性模型退化为“预测无变化”,容易高估深度模型的真实增益,因此需要一个公平而统一的基准来回答“基础模型是否真的更强”。 ▍研究方法 研究以统一的数据划分、评测指标与极简基线,对五个单细胞基础模型与两个深度学习模型做正面对比,并加入防低估控制: 模型清单:五个基础模型(scGPT、scFoundation、scBERT*、Geneformer*、UCE*)与两个深度学习模型(GEARS、CPA);带星号者为非该任务专用、需外接线性解码器才能输出表达谱的模型。 数据集:双扰动用 Norman 等(K562,100 个单基因扰动+124 个基因对);单扰动用 Replogle 等(K562、RPE1)与 Adamson 等(K562)三个数据集。 极简基线:双扰动用“无变化”与“加性”两个模型;单扰动用“均值”基线,以及一个表示为 G·W·P^T+b 的线性模型(式 1)。 评测口径:主指标为表达量最高的 1,000 个基因上的 L2 距离,辅以 Pearson delta 相关、遗传互作识别的真阳性率—假发现比例曲线,以及互作类别构成。 防低估控制:随机划分重复五次(双扰动)或两次(单扰动)、尽量使用各模型默认参数、向相关模型作者征求反馈,并单独统计各模型的算力开销。 ▍核心发现 1、揭示双扰动预测中各模型普遍不如加性基线 在双基因扰动基准中,所有模型的预测误差都高于加性基线——后者只是把两个单基因的对数倍数变化相加,不使用任何双扰动数据。 研究者用 Norman 数据(100 个单基因扰动+124 个基因对,K562,CRISPR 激活系统)训练并预测留出的 62 个双扰动,重复五次随机划分以保证结论稳健。 除 L2 距离外,Pearson delta、按表达量或差异表达排序的不同基因子集都给出同一结论,说明这一差距并非指标或基因集选择所致。(图 1) 图 1 · 《双扰动预测:预测误差、互作识别与互作分类构成》 · 来源:Ahlmann-Eltze et al., 2025, Nature Methods · 蜂群图与 TPR 曲线 五个测试—训练划分下,各模型 62 个双扰动的 L2 误差整体高于加性基线,最好的模型仍差于加性;互作识别曲线上无人超过“无变化”基线。读图先看 (a) 蜂群图中各模型红色均值横线的高低并对照加性虚线,再看 (b) 观测—预测散点是否贴合对角线,以及 (c) 真阳性率随假发现比例上升的快慢。 2、证明单扰动预测中深度学习模型未稳定超越线性模型 针对未见过的单基因扰动,研究设计了两个基线:训练集的“均值”预测,以及一个把读出基因与扰动各自表示为嵌入向量、再拟合权重矩阵的线性模型。 在 Replogle K562、RPE1 与 Adamson 三个数据集上,深度学习模型都未能稳定低于这两个基线的误差,误差比大致落在 1 附近甚至更高。 该线性模型还能灵活接入外部嵌入:把 scGPT、scFoundation 的基因嵌入或 GEARS 的扰动嵌入装进去后,其表现与这些模型自带的解码器相当或更好,说明增益多来自嵌入而非解码结构。(图 2) 图 2· 《单扰动预测:线性模型设计与各模型相对基线的误差比》 · 来源:Ahlmann-Eltze et al., 2025, Nature Methods · 蜂群图、模型示意图与森林图 Replogle K562、RPE1 与 Adamson 三个数据集上,深度学习模型相对“均值”基线的误差比多位于 1 附近或高于 1,未显示出跨数据集稳定优于均值基线的优势;训练数据拟合的线性模型在部分数据集低于 1,但并非全部数据集均如此。读图先看 (a) 蜂群图中各模型误差的整体水平与均值横线,再看 (c) 森林图中每个模型的点估计与 95% 置信区间相对参考线 1 的位置。 3、发现遗传互作识别能力有限 研究把遗传互作操作化为偏离加性期望超出零模型的扰动,用经验零分布方法在全数据集上以 5% 假发现率识别出 5,035 个互作。 让各模型在 31 万个预测(1,000 个读出基因 × 62 个留出双扰动 × 五次划分)上给出偏离加性期望的幅度,再扫描阈值得到真阳性率—假发现比例曲线,结果没有任何模型优于“无变化”基线。 进一步按缓冲、协同、相反对互作分类后发现,观测中 2.3% 为缓冲、0.6% 为协同、无一例相反方向,而模型几乎只预测缓冲型,协同型既少预测、预测对的比例更低。 4、厘清单细胞图谱预训练与扰动预训练的收益差异 为单独衡量表征质量,研究者从 scFoundation、scGPT 中抽出基因嵌入矩阵、从 GEARS 中抽出扰动嵌入矩阵,替换进同一条线性模型的对应位置。 结果发现,来自单细胞图谱预训练的基因嵌入相对随机嵌入只有很小增益,且不能稳定超过直接用训练数据学出的嵌入。 唯一稳定领先所有模型的做法,是用 Replogle 扰动数据预训练扰动嵌入再迁移到其他数据集(如以 K562 预训练预测 RPE1),且目标基因在两数据集间越相似预测越准,提示收益来自同源扰动信息。 5、指出算力投入与预测增益并不匹配 研究在 Norman 数据上测算了各模型微调与预测的耗时和峰值显存,结论是基础模型的算力开销显著高于极简基线。 与此同时,多个模型暴露出“不随扰动变化”的问题:scGPT、UCE、scBERT 对大多数基因的预测在不同扰动间几乎不变,GEARS 与 scFoundation 的预测波动也明显小于真实值。 例如血红蛋白基因 HBG2 与 HBZ 虽单个扰动效应很强,但双扰动组合上多个模型却预测接近零变化,提示这些模型在本基准中未充分捕捉扰动特异响应。 ▍核心结论速览 - 五个基础模型与两个深度学习模型在相应的单、双扰动评测中,均未稳定超越均值、线性或加性等极简基线。 - 双扰动预测误差普遍高于加性期望,互作识别不及“无变化”基线。 - 单扰动预测中深度学习模型未稳定优于均值与线性基线。 - 单细胞图谱预训练增益有限,扰动数据预训练提升明显。 - 算力开销高但无性能优势,模型对扰动响应不足。 ▍研究意义 科学价值:以故意简化的基线做正面对照,指出评估口径(基线设置、数据泄露、指标选择)会影响结论,重申批判性基准比较是方法发展中不可省略的一环。 应用价值:对以扰动效应预测辅助靶点筛选与联合干预设计提出警示,避免因高估模型泛化能力而将尚未得到充分验证的预测用于真实决策。 ▍局限与下一步方向 作者指出三项局限:其一,仅使用四个数据集,且均取自癌症细胞系,这类高突变负荷数据曾被部分模型在训练时排除,代表性有限。其二,研究者未改进原始质控流程,例如未剔除未能影响其自身靶基因表达、可能并未真正生效的扰动。其三,作者强调极简基线本身不具备刻画真实生物学复杂性的能力,却仍未被超越,说明提供通用细胞状态表征、预测尚未开展实验的结果这一目标依然遥远;未来应更聚焦性能指标与基准建设。 ▍FAQ Q:为什么“未超越极简基线”是一个重要结论? 因为对照的基线极简——无变化、加性、均值都不使用任何组合或未见扰动的训练信息;若深度学习连这些都赢不了,说明其通用表征与泛化优势在本文测试的数据集、任务和指标下尚未得到支持,而非仅仅调参不足。 Q:研究如何保证对比的公平性? 统一数据划分与指标,重复多次随机划分以降低随机性,尽量沿用各模型默认参数,并向相关模型作者征求反馈;其中 CPA 作者还提交了修改。研究也刻意让 UCE、scBERT 在有利条件下测试,以减少低估模型性能的可能。 Q:预训练到底有没有用? 分情况:基于单细胞图谱的预训练相对随机嵌入只有很小增益,且不稳定超过训练数据自学的嵌入;但使用同源扰动数据做预训练再迁移,能稳定提升预测表现,说明收益来自任务同源信息而非模型规模。 Q:这对虚拟细胞方向意味着什么? 它表明“通用细胞状态表征+预测未做实验的结果”仍是未解问题。当前应把资源投向公平的基准、合理的性能指标与真正同源的预训练数据,而非一味放大模型与算力。 ▍君录视角 · 虚拟细胞 解决的问题:虚拟细胞方向把“扰动效应预测”当作核心能力,却长期缺少公平对照,容易把对照基线设得过于薄弱而高估深度模型。本文用统一数据划分、统一指标与故意极简的线性、加性、均值基线做正面对照,回答了一个关键问题——当前基础模型在预测单/双基因扰动的转录组变化上,是否真的比简单方法更强,答案是尚未。 集成判断:预训练的收益取决于预训练数据与目标任务是否同源:基于单细胞图谱的嵌入相对随机嵌入增益有限,而基于扰动数据预训练再迁移则稳定提升,说明决定表征价值的不是模型规模或语料体量,而是嵌入在目标任务上的增量。因此评价一个表征是否可用,应把它插回任务级基线中做增量检验,而非只看模型宣称的能力。 ▍原文信息 Ahlmann-Eltze C, Huber W, Anders S. Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines. Nature Methods. 2025;22(8):1657–1661. doi:10.1038/s41592-025-02772-6 ▍关于我们 君录生物 · 以数据驱动创新药早期开发 自建心血管专病数据基座HeCellAstra+对话式生信分析平台 IntelliCytoPilot 做靶点发现与药物管线早期资产 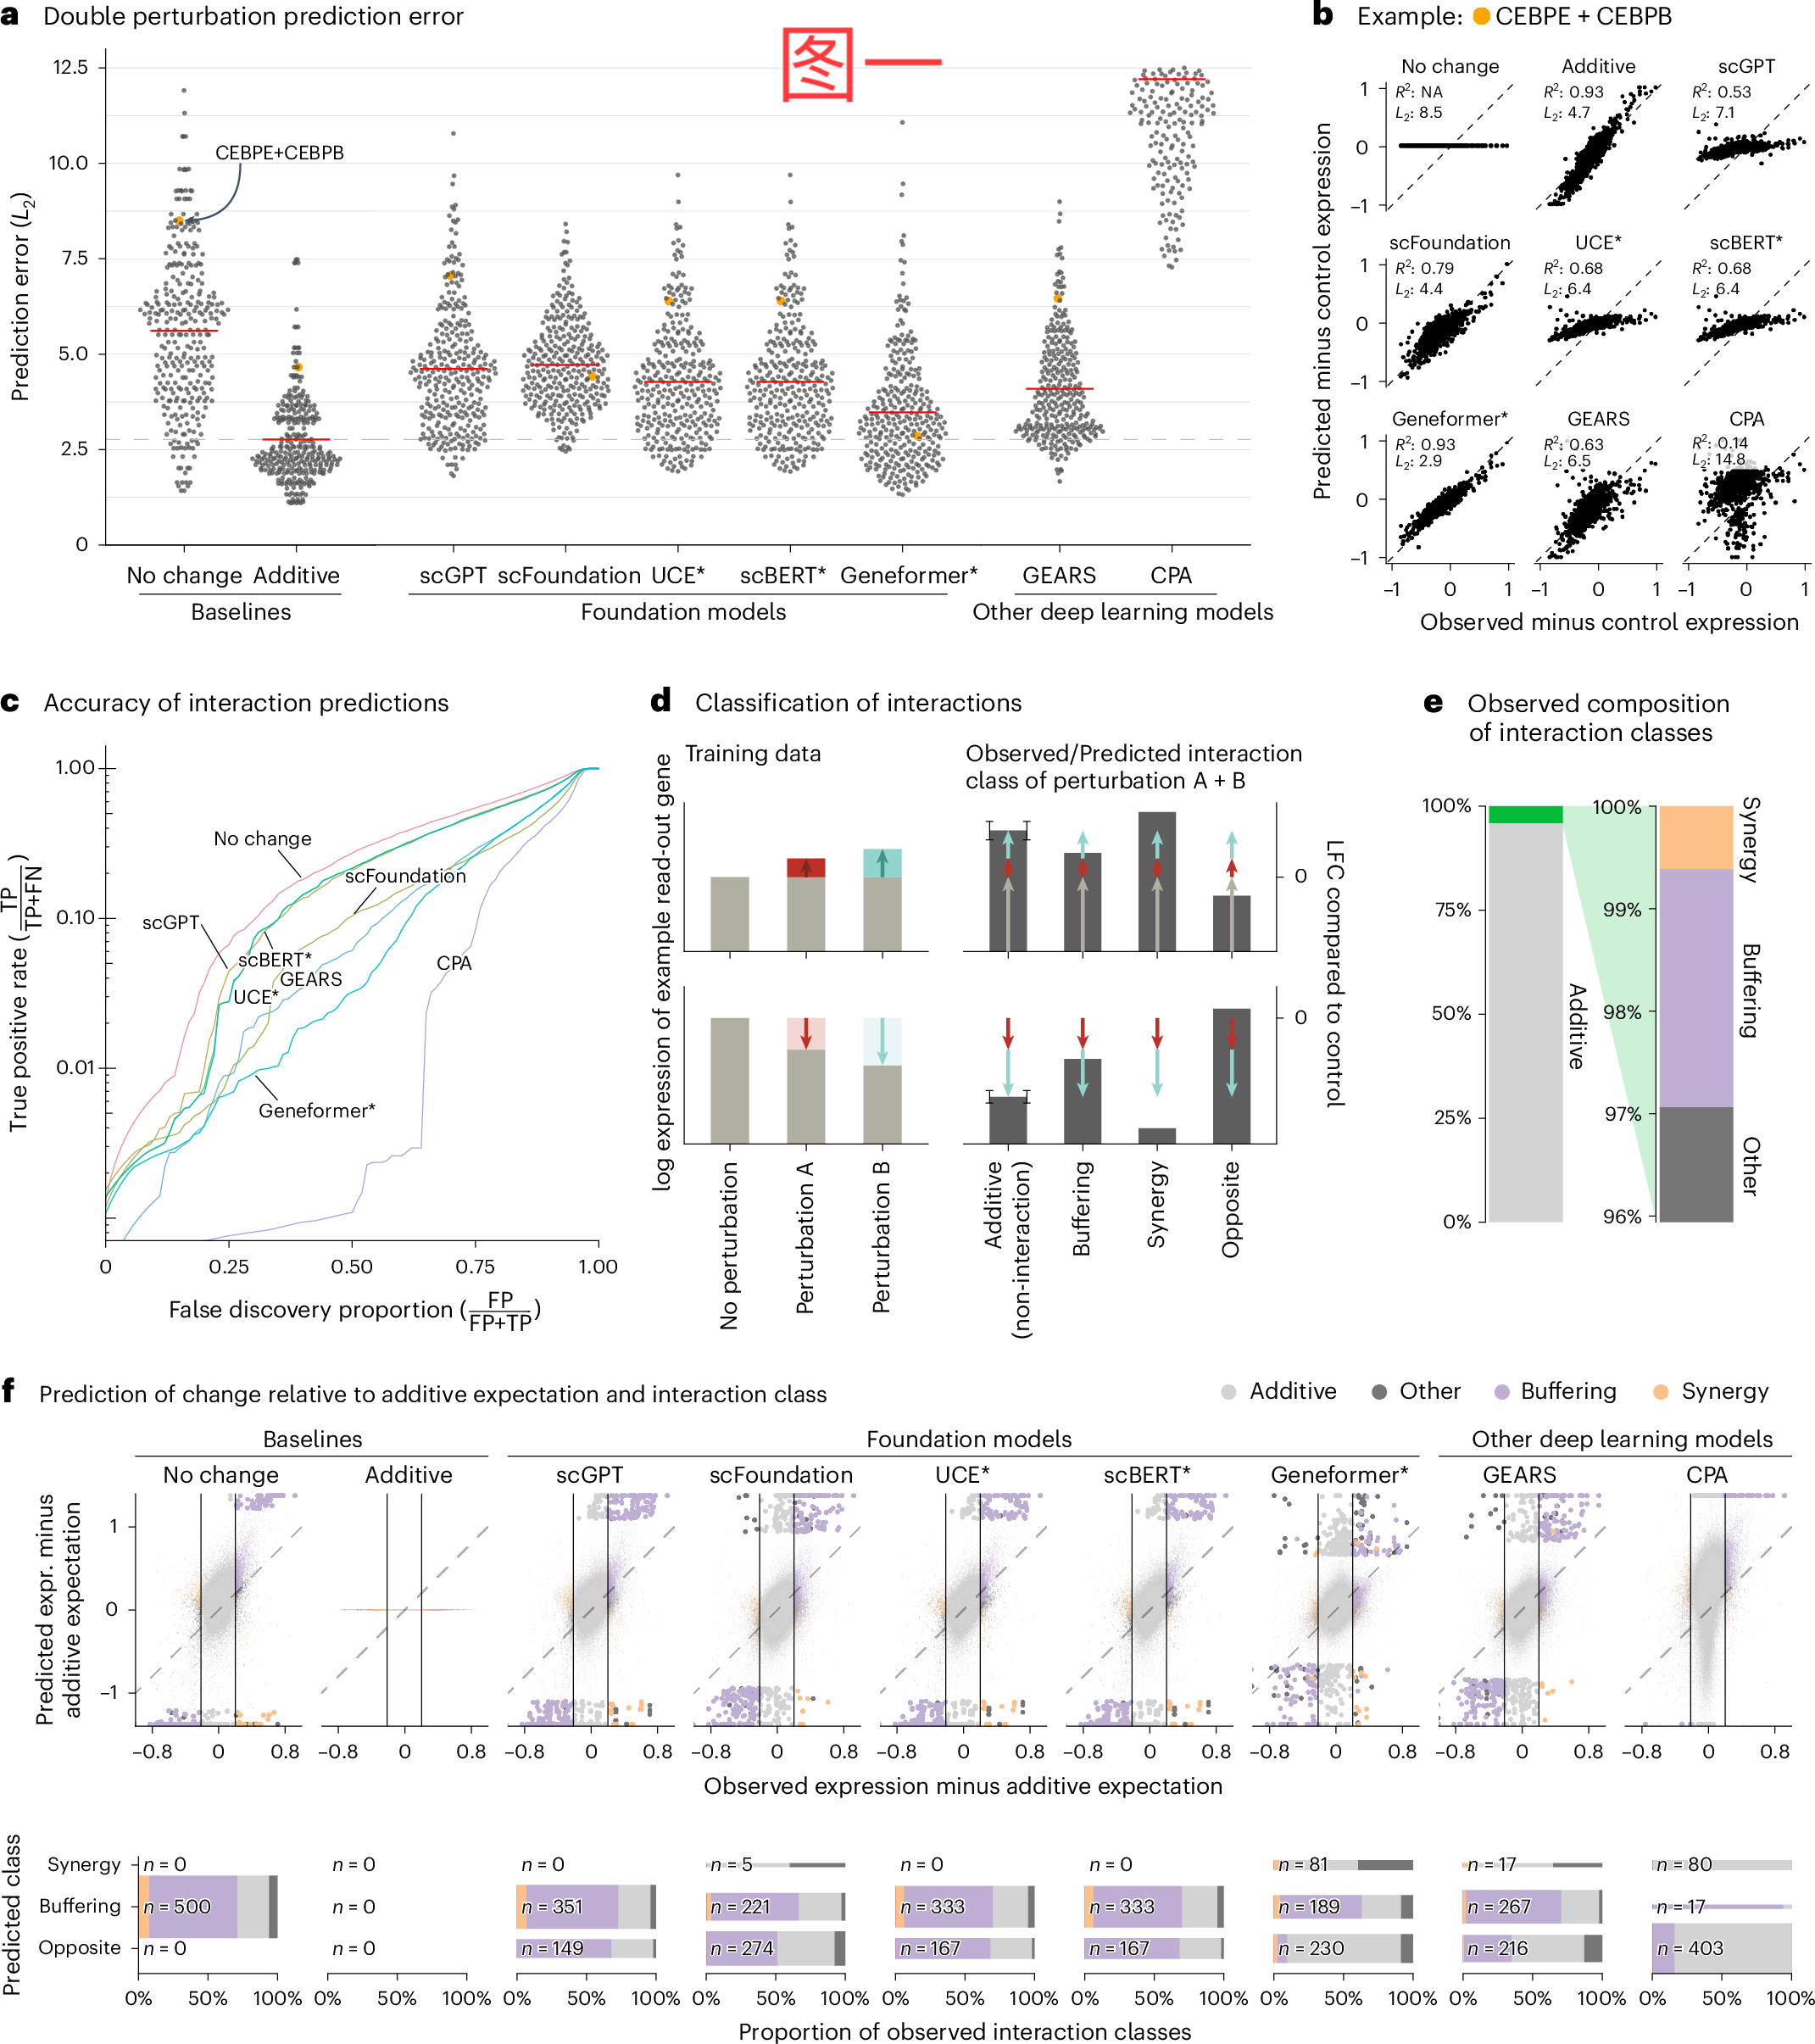 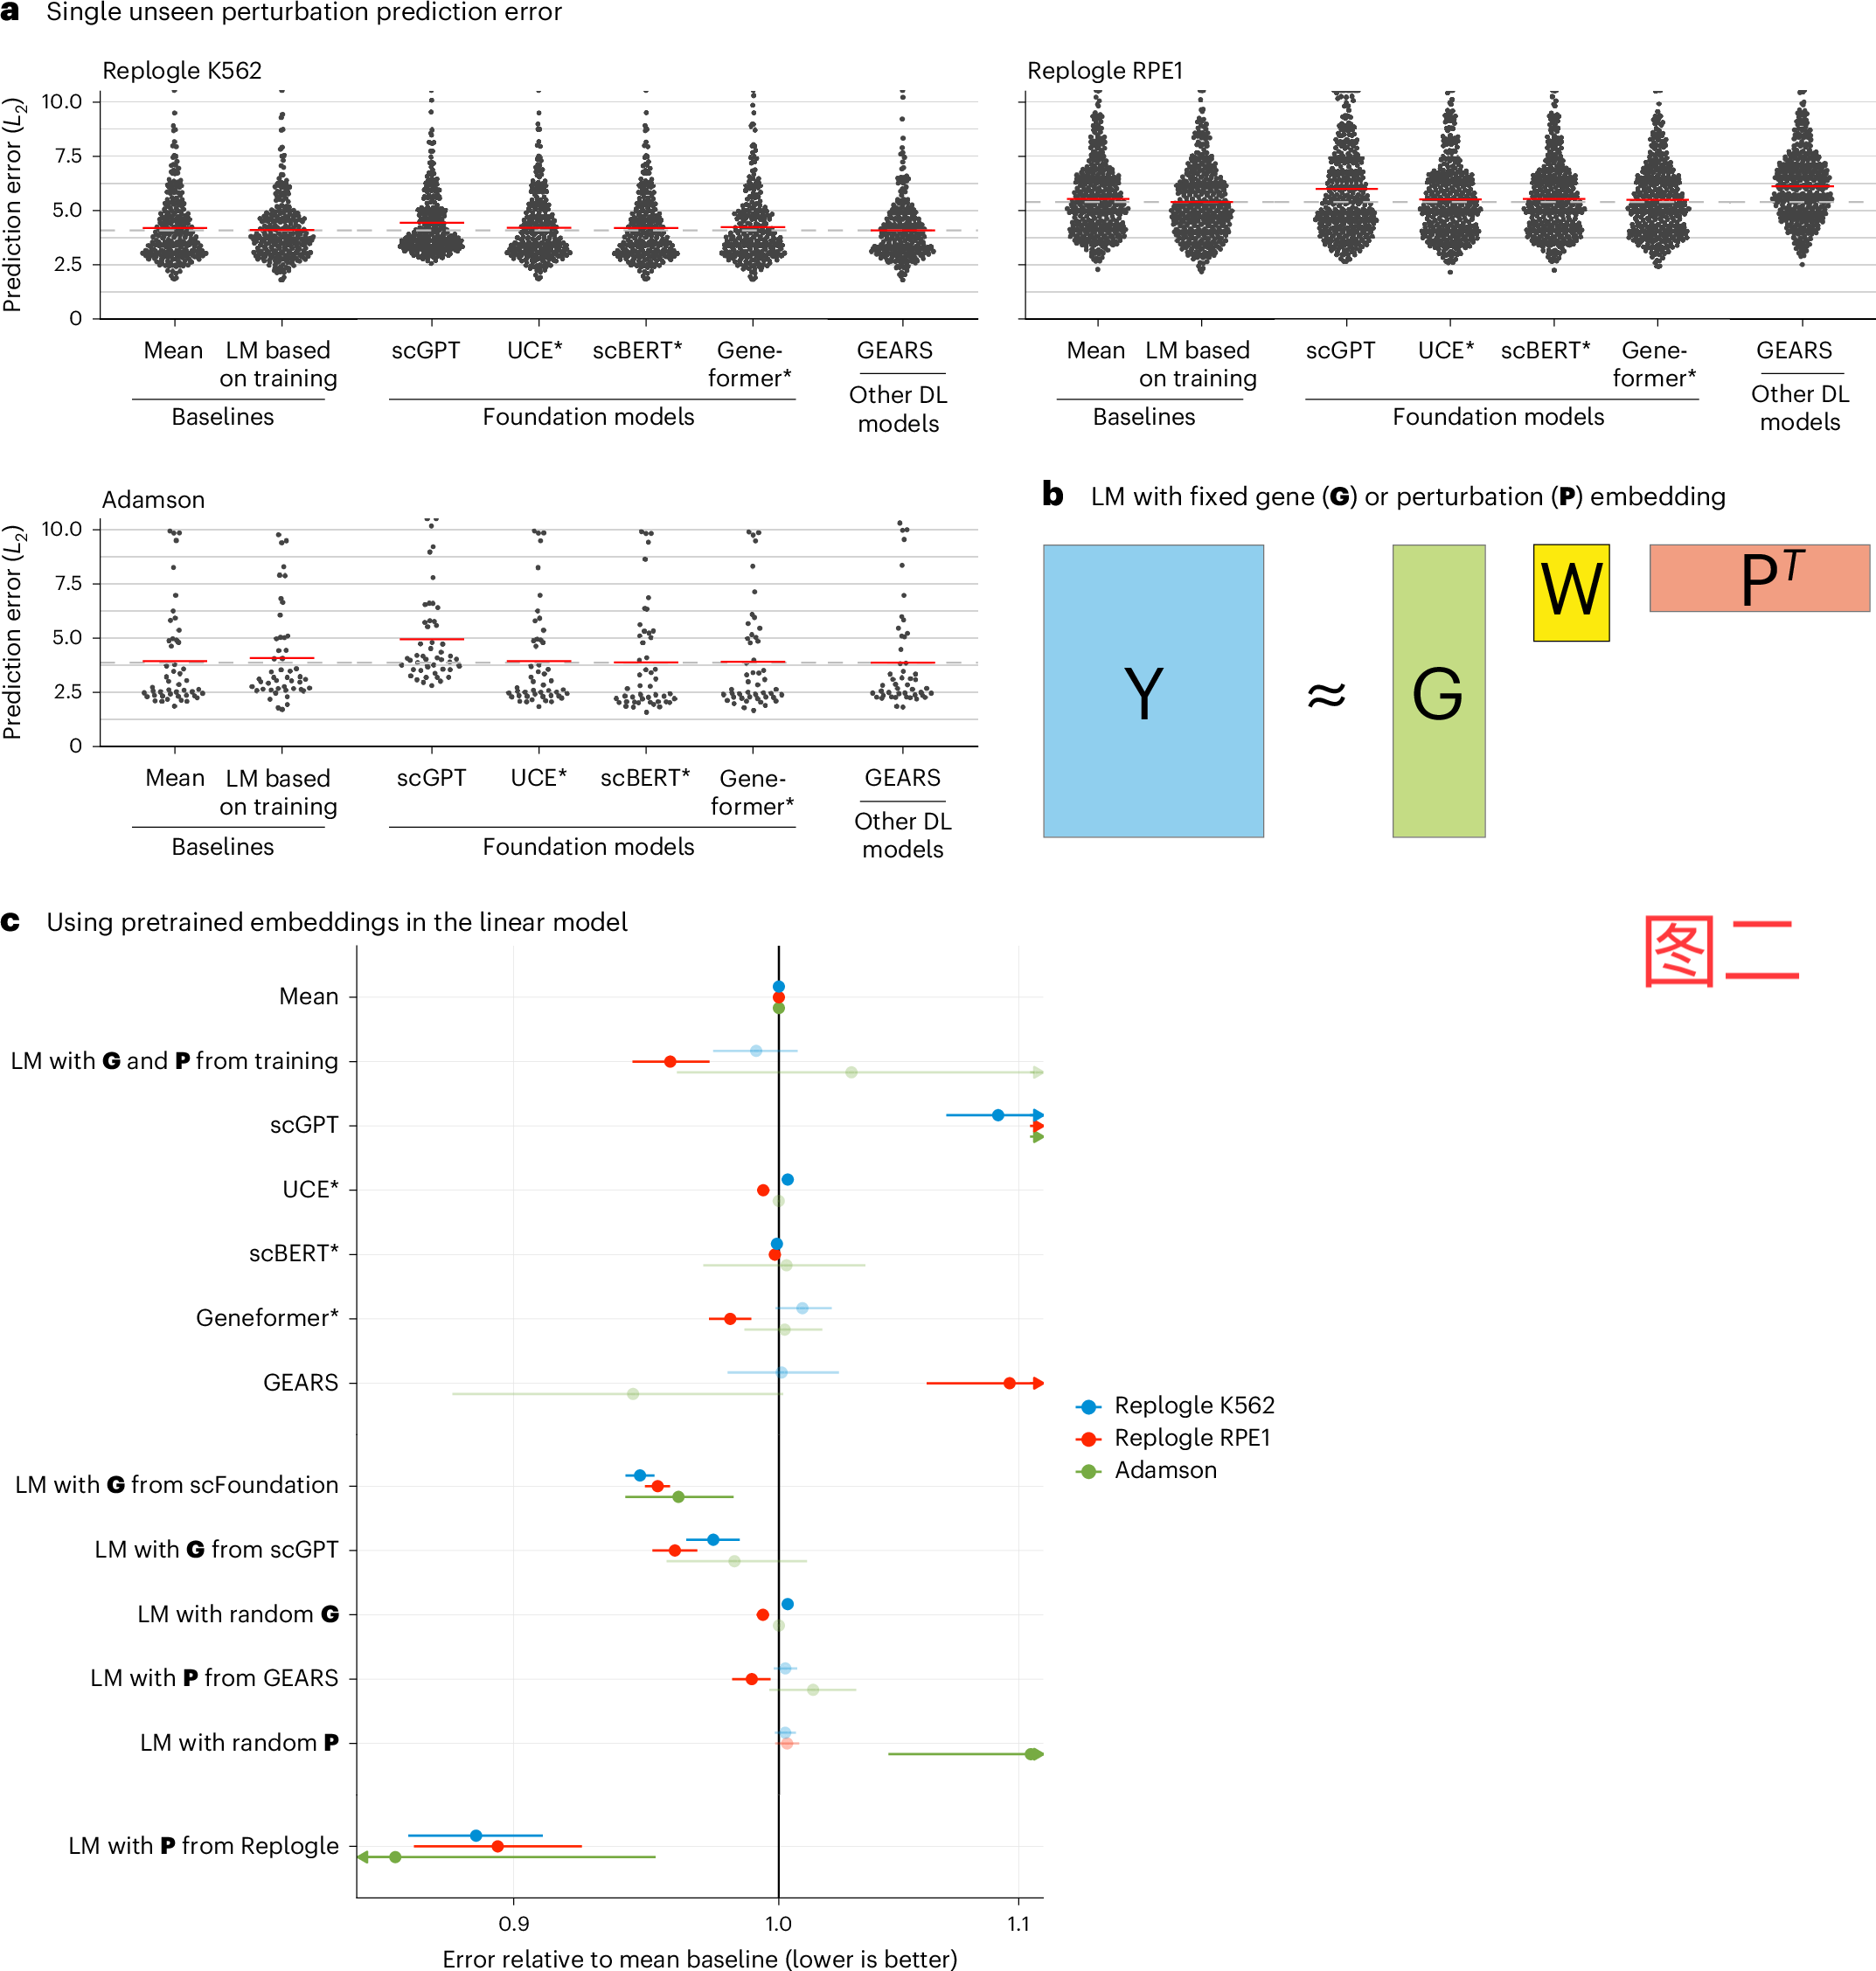 |
 回复此楼
» 猜你喜欢
 TYK2/JAK1 双靶点工具化合物 Brepocitinib:激酶选择性、研究进展与实验应用全解析
已经有0人回复
-
矢车菊素-3-O-葡萄糖苷质控实录:从一张HPLC图谱读懂纯度与稳定性
已经有0人回复
-
化学工程及工业化学论文润色/翻译怎么收费?
已经有85人回复
-
恩诺沙星(Enrofloxacin)科研解析:分子特征、LC-MS/MS 检测与实验室使用要点
已经有0人回复
-
Calderasib理化性质与实验操作技术笔记
已经有0人回复
-
RMC-6291怎么用?RAS(ON) 三重复合物工具化合物的实验室实操要点
已经有0人回复
-
苯并呋咱全解析:NBD 荧光衍生化试剂母核的化学特性与实验室应用
已经有0人回复
-
生物质炭与活化剂氢氧化钾混合注意事项
已经有0人回复
-
科研人必读:新一代 KRAS G12C 抑制剂 Olomorasib 的研究进展
已经有0人回复
-
BT-11(Omilancor)研究化合物全解析:从分子结构到实验应用要点
已经有0人回复
-
富马酸贝达喹啉:二芳基喹啉类工具化合物的化学特征
已经有0人回复
» 本主题相关商家推荐: (我也要在这里推广)

