









| 查看: 50 | 回复: 0 | |||
[交流]
BiOmics:面向知识锚定与自主多组学解读的基础智能体
|

|
▍导读 2026年,华大生命科学研究院团队在 bioRxiv 发布 BiOmics 预印本,提出一个把多组学数据与自适应知识对齐的基础智能体,打通「检索—推理—预测」解读链路。它由日更知识图谱 BiOmics-KG(约 1088 万节点、3.56 亿条关系)、可插拔工具链 BiOmics-BRICK 与多智能体系统 BiOmics-Agent 三层构成。评测中,BiOmics 真伪问答准确率达 91.32%,知识图谱可检索的多选题子集准确率达 76.44%;17 种组织注释准确率为 0.856 ± 0.165,药物重定位平均 top-20 命中率为 0.772,并在 T2D GWAS 变异解释与 TCGA 基因型到表型预测中展示了跨尺度推断能力,为 AI for Science 走向知识驱动的自主解读提供工程基座。 ▍研究背景 高通量多组学技术日趋成熟,数据产出已不再稀缺,真正的瓶颈转移到机制层面的解读。传统流程把分析与解读拆成两段——先跑出统计结果,再另行理解其生物学含义——计算输出与生物学洞见之间因此形成一道鸿沟。 现有 AI 手段大致分为两支:以 GeneFormer、scGPT 为代表的细胞基础模型擅长模式识别与特征提取,但通常缺乏显式、可回溯的逻辑依据,且多聚焦于基因层级嵌入,难以贯通从分子扰动到系统表型的多尺度复杂性;AutoBA、BioMaster、CellAgent、Biomni 等智能体擅长自动化分析流程,但其输出仍可能停留在工具结果或浅层知识映射,对深层生物学机制的解释有限。 知识图谱与组学的融合又面临「刚性与通用性」的矛盾:CKG、BioKG、BioCypher、SPOKE 等偏静态,多为「固定图谱+固定查询」,难以与实时分析流程形成闭环。领域缺少一个既能拟合数据、又能依据结构化生物学规律主动推理的基础模型。 ▍研究方法 研究以「知识图谱+可插拔工具链+多智能体」三层结构构建 BiOmics,并在知识问答、细胞注释、药物重定位、表型预测、因果 SNP 识别、轨迹推断、富集与 PPI/GRN 等十余类任务上系统评测: - BiOmics-KG 知识图谱:以 23 个国际主流生物本体为骨架,映射 89 个公共数据库与约 600 万篇 2004 年以来影响因子 ≥4 的 PubMed 文献,构建含 1088 万节点、3.56 亿条关系的大规模图谱,并通过实体标准化、关系归一化与自动管线实现零人工干预的每日更新。 - BiOmics-BRICK 工具链:六个可插拔模块——数据预处理、查询、排序、推理、图表示学习(嵌入)与可视化,由智能体按需组装成端到端流程,把组学分析结果与知识图谱中的先验知识实时耦合。 - BiOmics-Agent 多智能体系统:10 个子智能体协同完成需求解析、方案生成、计划执行、结果汇总、人机交互与记忆留存;在集成 Jupyter 内核网关的 Docker 沙箱中按 ReAct 范式生成、调试并执行代码,配合长短期记忆保证会话一致性。 - 双轨架构与推理范式:协调一致的显式推理空间负责形式化逻辑推断并支持回溯式推理链校验,统一隐空间负责高维关联映射,两者协同执行「检索—推理—预测」范式。 - 基准与案例评测:以 GPT-4o、任务专用生物信息学算法与 Biomni 为对照,在 Biomix 问答数据集,以及 17 种组织细胞注释、COVID-19 药物重定位、TCGA 表型预测、T2D GWAS 因果 SNP、小鼠白细胞轨迹、胎盘疟疾蛋白质组等真实数据上评估准确率、丰富度与可回溯性。 ▍核心发现 1、构建多组学解读的自主智能体基座 研究提出 BiOmics,一个把多组学数据与可自适应知识对齐的基础智能体,目标是把「分析与解读」从两段割裂变成一条闭环。 其核心是双轨架构:协调一致的显式推理空间(harmonized explicit reasoning space)负责有据可依的形式化逻辑推断,统一隐空间(unified latent embedding space)负责高维关联映射;两者与长链知识检索协同,形成「检索—推理—预测」范式。 该范式在工程上落到三层:知识(BiOmics-KG)提供每日更新的关系记忆以约束推理、缓解随机幻觉;工具(BiOmics-BRICK)提供模块化可插拔工具链、打通互操作瓶颈;智能体(BiOmics-Agent)承担高阶自主路径规划与假说生成。(图 1) 图 1 · 《BiOmics 系统总览》 · 来源:Cao et al., 2026, bioRxiv· 系统架构示意图 先看左侧 (a)(b):传统「先分析、后解读」的割裂流程,与 BiOmics 把两者合并的一体化范式形成对照;再看 (c) 的三层结构——左上是知识图谱 BiOmics-KG(本体 23 个、公共数据库 89 个、文献约 600 万篇),右上是六模块工具链 BRICK,下方是多智能体系统,三者共同支撑「检索—推理—预测」。 2、在多项检索与推理基准中表现领先 在知识检索评测上,BiOmics 用 Biomix 数据集评估真伪题(TFQ)与多选题(MCQ):真伪题准确率为 91.32%,较 GPT-4o 的 84.89% 高 6.43 个百分点;整体多选题准确率为 66.01%,较 GPT-4o 的 60.78% 和 Biomni 的 52.94% 分别高 5.23 和 13.07 个百分点。在知识图谱可检索的多选题子集上,准确率进一步达到 76.44%。 在回答粒度上,研究构造了 100 道「What is XXX?」测试题(细胞、疾病、基因、变异各 25 道),BiOmics 给出的生物学实体数较原始大模型约多 92%、较 Biomni 约多 208%,且所有实体都能回溯到可核验的文献或数据库。 在跨变异、基因、蛋白、细胞和药物的多组学解读任务上,BiOmics 在本文列出的多数任务及相应指标上取得最佳或有竞争力的表现,表明知识约束下的检索与推理有望同时改善准确率与信息丰富度。(图 2) 图 2 · 《BiOmics 基准评测》 · 来源:Cao et al., 2026, bioRxiv · 基准评测组合图 先看 (a):真伪题中 BiOmics 达 91.32%,高于 GPT-4o 的 84.89% 与 Biomni 的 76.21%;再看 (b) 答题所提实体数量的分组差异,BiOmics 明显多于基线;最后看 (c) 十个生物信息学任务的比较。各子图采用任务特定指标,数值越高、点位越靠上或横向条形越长,通常代表对应指标表现越好。 3、支持基因型与表型之间的双向推断 在 2 型糖尿病(T2D)GWAS 数据上,BiOmics 自动检索并整合与 T2D 直接或间接相关的变异:找到 37 个此前报道直接相关的变异,并把另外 151 个变异映射到对 T2D 关键的基因,覆盖 JAZF1、CDKAL1、ADCY5、KCNQ1、TCF7L2 等经典易感位点。 它进一步识别出 ZNF536 中的一个插入变异——尽管现有报道未把它直接与 T2D 关联,但它与 TCF7L2 同处「RNA 聚合酶 II 转录负调控」过程,推理提示该插入可能通过扰动 TCF7L2 介导的转录调控间接影响 T2D 进展。 在 639 例 TCGA 体细胞突变样本上,BiOmics 准确判定 151 例癌症类型,另有 232 例被正确关联到同一组织来源的相关恶性肿瘤,而 Biomni 仅正确预测 62 例,BiOmics 的准确率约为其 2.4 倍。(图 3) 图 3 · 《BiOmics 支持从基因型到表型的精确双向推断》 · 来源:Cao et al., 2026, bioRxiv · GWAS 变异解释与 TCGA 表型预测组合图 先看 (b)(c):因果 SNP 在全部 SNP 中的占比饼图,以及散点分布(横轴为 GWAS 效应值 BETA、纵轴为 −log10(p),黄/橙/红区分全部查询、间接相关与直接相关 SNP);再看 (d)(e)(f) 以变异为中心的关系网络与 ZNF536—TCF7L2 路径;最后看 (h) 柱状图,BiOmics 正确预测表型的病例数显著高于 Biomni。 4、无参考细胞注释与亚群精细拆分 在 17 种组织的人类与小鼠数据总体评测中,BiOmics 的平均注释准确率为 0.856 ± 0.165,较 GPTcelltype、CellMarker2 和 Biomni 等参考无关方法高 19–35%。在小鼠胰腺单细胞转录组案例中,BiOmics 进一步依据自主推理引擎区分细胞簇并给出标准化注释,同时为注释提供可回溯的证据链。 当推理认为某个聚类可能是胰腺 D 细胞与 PP 细胞的混合时,BiOmics 启动关联预测流程,把组学数据、细胞类型节点与相关 marker 基因构造成统一隐空间,将该聚类细分为两个分别与相应细胞类型高相关的亚群,注释准确率进一步提高约 1.5 个百分点。 传统无监督工具(如 Leiden)较难区分这两类细胞,因为共同的内分泌谱系来源使其转录组特征相似;BiOmics 通过知识引导的细分轴把这批细胞映射到相应生物学类型,展示了无参考条件下的细胞亚型细分能力。(图 4) 图 4 · 《BiOmics 加深组学分析深度》 · 来源:Cao et al., 2026, bioRxiv · UMAP 与富集组合图 先看 (b)(c) 的 UMAP,把真实标注与 CellMarker2、GPTcelltype、Biomni、BiOmics 的胰腺细胞注释分布逐格对照;再看 (d) 的该案例准确率,BiOmics 约为 0.94,末列精修结果约为 0.95;最后看 (i) 火山图与 (j) 放射状富集图,红圈标出已知 marker,彩色扇面区分细胞、组织、通路和疾病等富集类别。17 种组织的总体结果见图 2c,而非本图 (d)。 5、优化发育轨迹并识别潜在转录调控因子 在小鼠白细胞数据上,BiOmics 从三个方面增强轨迹分析:推断发育方向以确定拟时序所需的根节点、重建含瞬时中间状态的完整发育路径、并以知识库区分已验证路径与未记录或分叉的路径。 BiOmics 发现 PAGA 输出中存在一条与既有知识不一致的路径——脂肪组织巨噬细胞(ATM)与常规树突状细胞(cDC)之间的连接;它改用图表示学习把组学数据、先验知识与细胞类型元数据嵌入统一空间后重建 PAGA 轨迹,得到更符合既有生物学知识的单核细胞向 ATM 分化路径。 为进一步评估该关系,研究用 pySCENIC 开展调控网络分析,发现单核细胞与 ATM 的调控子活性较为相似,并提示转录因子 Fos 可能是单核细胞向 ATM 分化轴上的潜在主调控因子;可视化显示 Fos 的表达及相关调控信号在单核细胞与 ATM 中较强,在 cDC 中较低。(图 5) 图 5 · 《BiOmics 导航组学分析路径》 · 来源:Cao et al., 2026, bioRxiv · 拟时序、轨迹网络与转录调控组合图 先看 (b) 的拟时序分布与 (c) 的原始 PAGA 轨迹;再看 (d)–(g) 经 BiOmics 知识与组学联合嵌入后重建的轨迹,其中单核细胞与脂肪组织巨噬细胞形成更符合既有知识的连接;最后看 (h)–(j) 的调控子活性、Fos 表达和相关实体匹配结果。这些结果支持 Fos 作为潜在调控因子,但不等同于扰动实验或谱系追踪验证。 6、数据与知识融合驱动药物重定位 传统基于知识图谱的药物重定位把任务写成静态网络上的链接预测,图谱一旦构建便难以吸收实时组学信号。BiOmics 在 COVID-19 外周血单细胞数据(6 例健康对照、8 例患者,其中 4 例有创通气)上做细胞类型特异的药物重定位,把细胞谱、差异表达基因与知识图谱实体嵌入统一表示空间。 嵌入不仅能区分生物实体与细胞状态,还呈现出细胞状态差异:多数细胞类型呈 Healthy→NonVent→Vent 的线性进展,而 NK 细胞呈 Healthy→Vent→NonVent 的非线性轨迹,作者归因于通气患者的 NK 细胞耗竭使其组学特征更接近健康对照。 按嵌入空间中的欧氏距离与余弦相似度排序,已报道的 COVID-19 治疗相关药物(如 Adenosine、Dexamethasone)与疾病实体显著更近,已报道药物的相似度主要集中在 0.95–1.00 区间;BiOmics 还筛得 Retinoic Acid(余弦相似度 0.993763)与 Paclitaxel(0.990273)等尚无直接 COVID-19 治疗证据的高相似度候选。图中推理分别涉及炎症与免疫调节,以及病毒复制或宿主相互作用;这些候选及其机制仍需进一步实验验证。(图 6) 图 6 · 《BiOmics 催化生物医学发现》 · 来源:Cao et al., 2026, bioRxiv · 单细胞状态嵌入与药物重定位组合图 先看 (b)–(f) 的 COVID-19 细胞状态及 NK 细胞知识—组学联合嵌入;再看 (g) 各细胞类型在健康、非通气和通气状态之间的成对距离,NK 细胞呈现不同于多数细胞的状态关系;最后看 (h) 的证据药物与计算候选,以及 (i)–(k) 的欧氏距离和余弦相似度分布。Retinoic Acid 与 Paclitaxel 为计算筛选候选,尚非实验或临床验证结论。 ▍核心结论速览 - BiOmics 用「知识—工具—智能体」三层结构打通多组学解读闭环。 - 日更知识图谱含 1088 万节点、3.56 亿条关系,为推理提供事实依据。 - 真伪问答准确率 91.32%,答题实体丰富度远超现有智能体。 - 在本文评测的多项细胞注释、药物重定位与表型预测指标上表现领先或具有竞争力。 - 支持基因型与表型之间的关联推断,并优化轨迹、优先识别 Fos 等潜在调控因子。 ▍研究意义 科学价值:把「分析与解读」合并为闭环,用日更知识图谱约束大模型、用统一隐空间融合多组学与知识实体,使检索、推理、预测三类能力在同一基座上贯通,为 AI for Science 从「数据拟合」走向知识驱动的自主解读提供可复用的工程骨架。 潜在转化价值:在真实数据上展示基因型与疾病表型之间的关联推断、无参考细胞注释与亚群精细拆分,并按具体数据集给出药物重定位候选,为个体化研究、候选药物优先级排序及疑难样本的机制追问提供可回溯的分析路径;相关结果仍需独立实验与临床验证。 ▍局限与下一步方向 作者指出:框架目前尚缺乏对代谢组学、表观组学等专门领域的系统评测;作为以细胞组学为中心的平台,更广的通用性仍需与领域专家协作,扩展知识图谱覆盖并积累跨组学案例;数据处理仍依赖大模型生成的代码(如 Scanpy、Stereopy),在高度复杂的场景下可能力不从心,需要更专用的分析智能体来优化。后续升级将聚焦于能主动识别知识空白、提供前置支持的「主动研究助手」。 ▍FAQ Q:BiOmics 与此前的生物医学智能体有何不同? AutoBA、BioMaster、CellAgent 等主要侧重生物信息流程自动化,部分系统的输出仍可能停留在工具结果或浅层知识映射。BiOmics 进一步用日更知识图谱约束推理,使分析结果进入可回溯的生物学解释链路。 Q: BiOmics-KG 凭什么减少大模型胡编? 它映射 23 个生物本体、89 个公共数据库与约 600 万篇文献,含 1088 万节点、3.56 亿条关系,并为每条关系保留出处与共现原文,检索结果可逐条回溯到数据库或文献,为推理提供事实依据。 Q:什么是「无参考细胞注释」,BiOmics 表现如何? 指不依赖预先标注的参考数据集,直接给聚类结果打细胞类型标签。在 17 种组织的人类与小鼠数据上,BiOmics 平均准确率为 0.856 ± 0.165,较 GPTcelltype、CellMarker2 和 Biomni 等参考无关方法高 19–35%。 Q:BiOmics 如何兼顾数据驱动与知识驱动? 其双轨架构一边是显式推理空间,依据「输入—融合—结论」给出可回溯的推理链;一边是统一隐空间,用图表示学习把组学与知识实体嵌入同一空间,从而在数据中挖掘未记录的新关联,同时用先验知识校正结果。 ▍君录视角 · 虚拟细胞 解决的问题:多组学数据已不再稀缺,瓶颈转移到机制解读——传统流程把分析与解读拆成两段,计算输出与生物学洞见之间存在鸿沟;细胞基础模型擅长模式识别,但通常缺乏显式、可回溯的逻辑依据且多聚焦于基因层级;现有智能体擅长自动化流程,输出仍可能停留在工具结果或浅层知识映射。BiOmics 把日更知识图谱、可插拔工具链与多智能体编排合为一体,让分析结果直接进入可回溯的生物学解读。 集成判断:BiOmics 属于把「表征」与「推理」合成一体的平台型基座——统一隐空间负责跨模态关联与预测,显式推理空间负责形式化逻辑与回溯校验,二者以「检索—推理—预测」范式贯通分子变异到疾病表型的层级。其增量不在单点算法,而在于把知识、工具与智能体三层标准化,并以 RESTful API、MCP Server 与 Web 接口对外开放,使细胞注释、药物重定位、轨迹与调控网络等任务可在同一骨架上复用与扩展。 ▍原文信息 Cao L, Li Y, Qin H, et al. BiOmics: A Foundational Agent for Grounded and Autonomous Multi-omics Interpretation. bioRxiv. 2026. doi:10.64898/2026.01.17.699830 ▍关于我们 君录生物 · 以数据驱动创新药早期开发 自建心血管专病数据基座HeCellAstra+对话式生信分析平台 IntelliCytoPilot 做靶点发现与药物管线早期资产 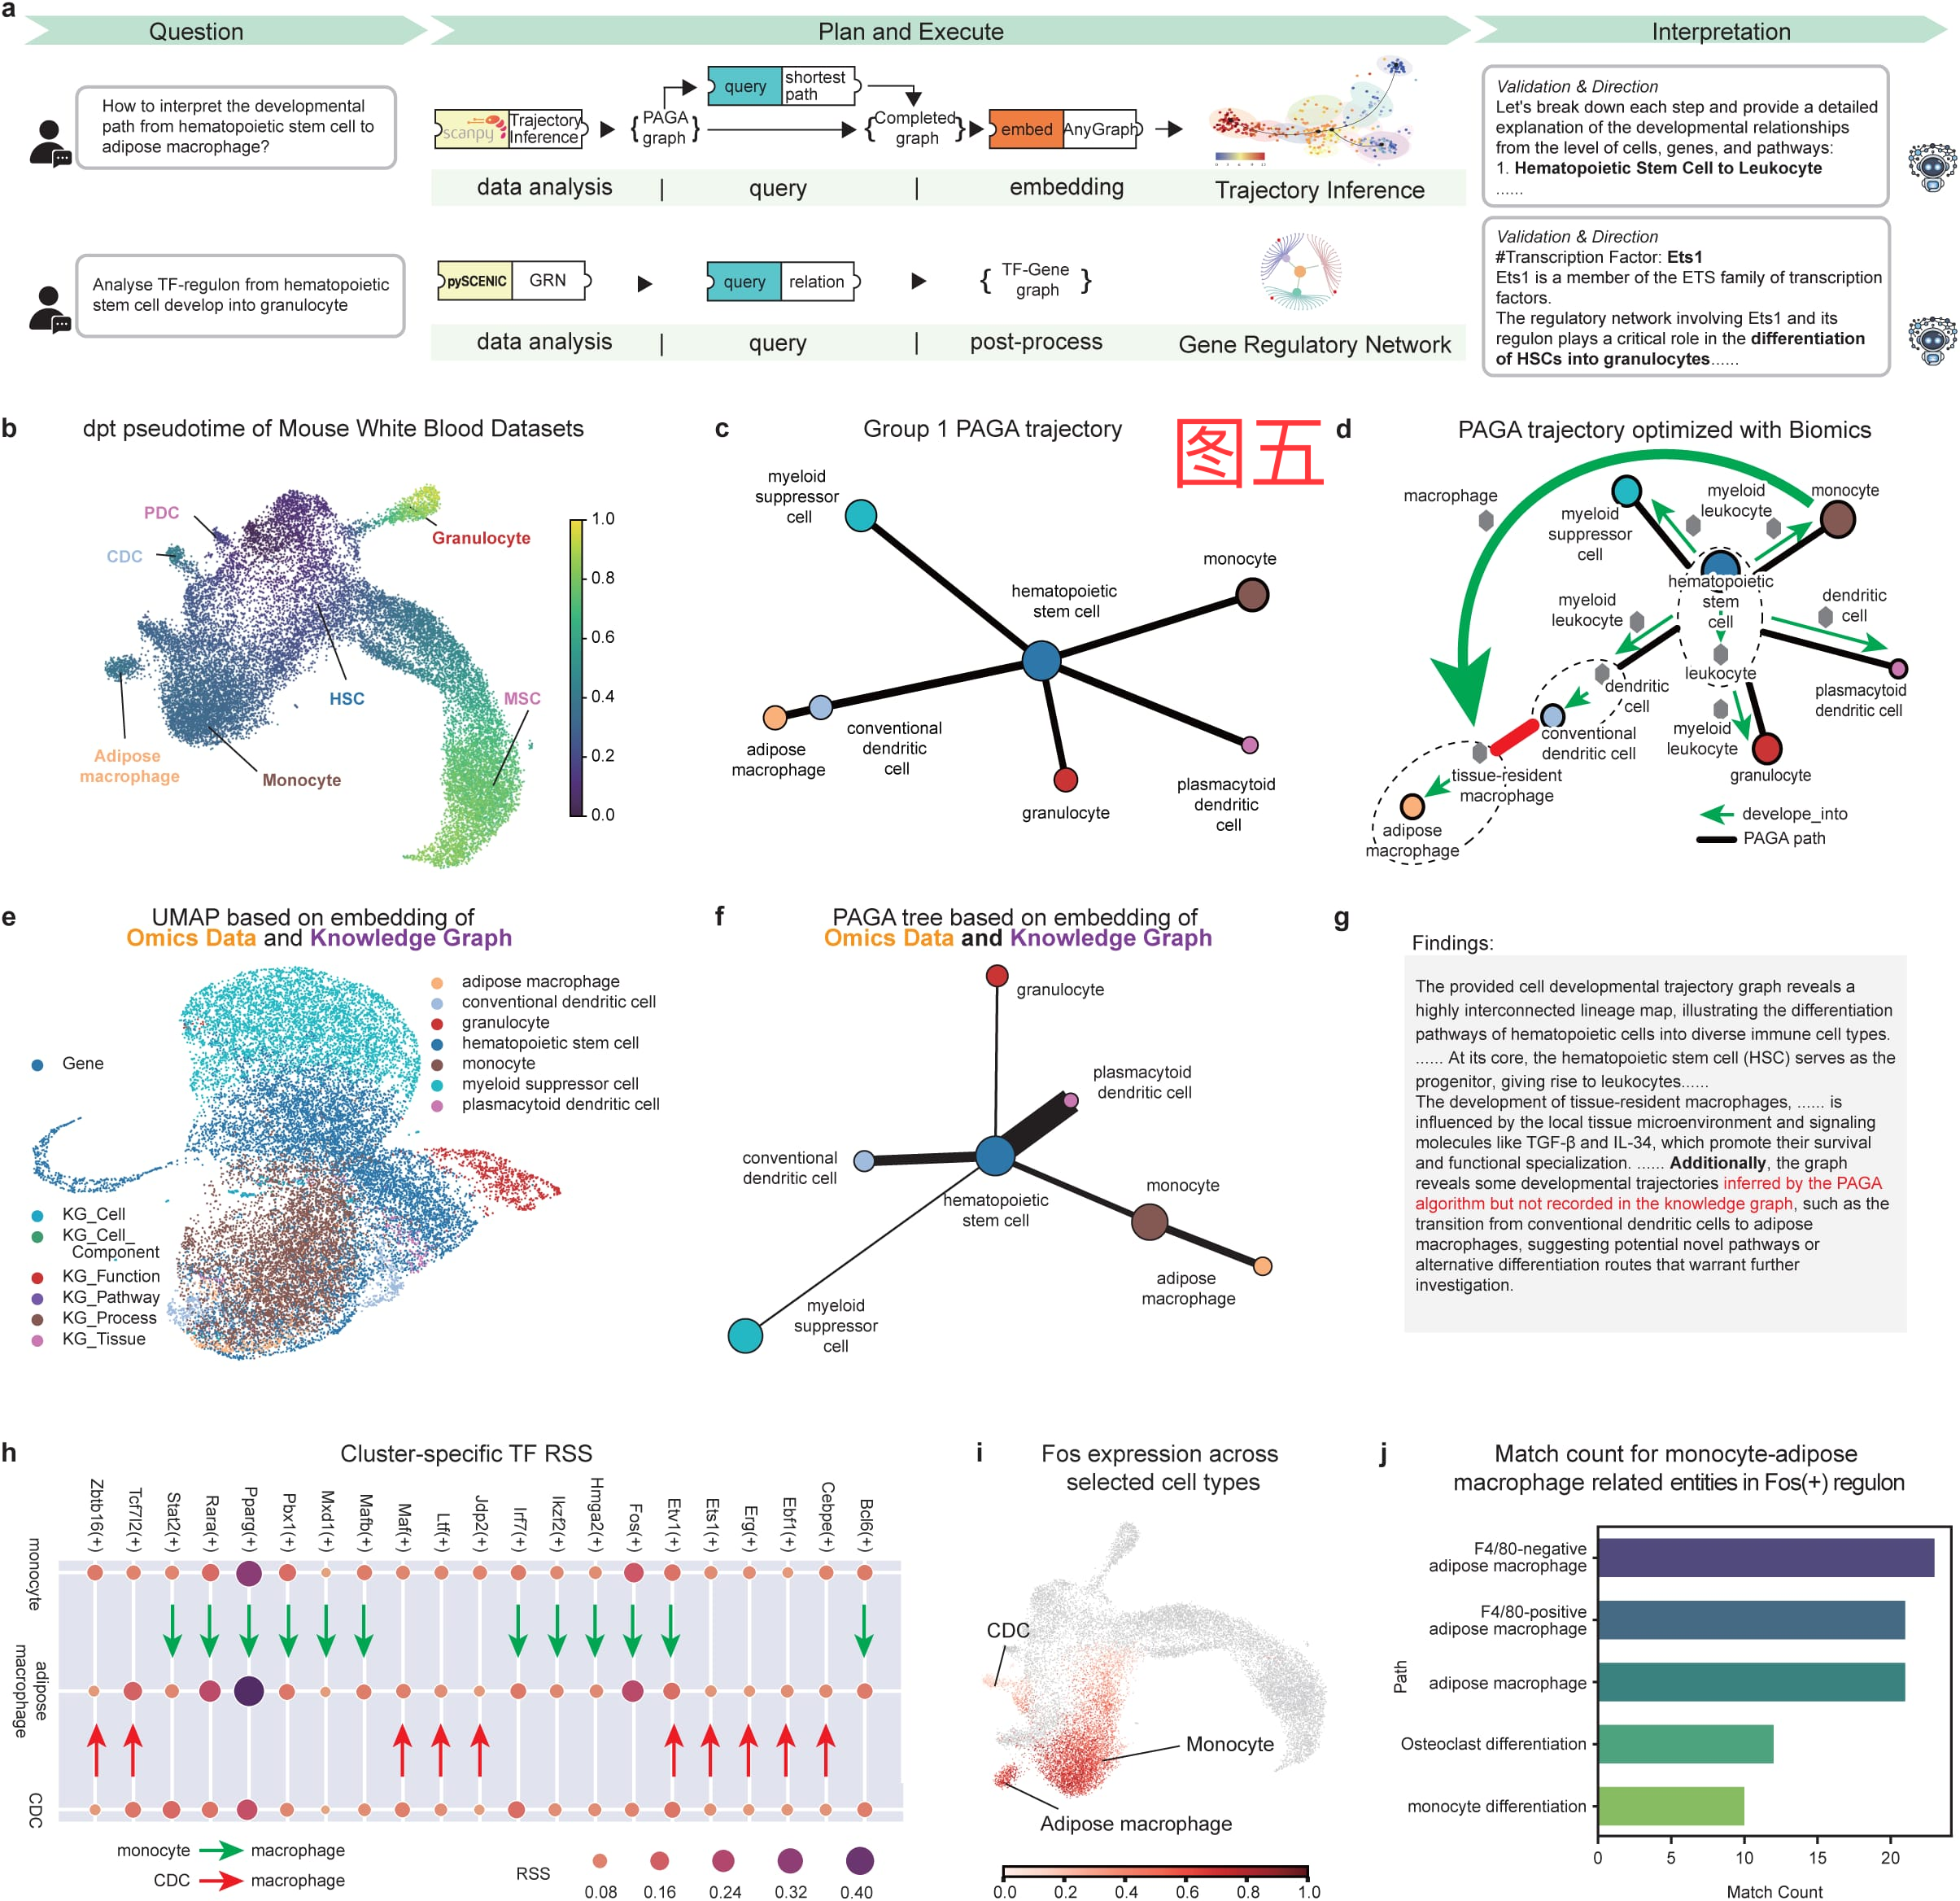 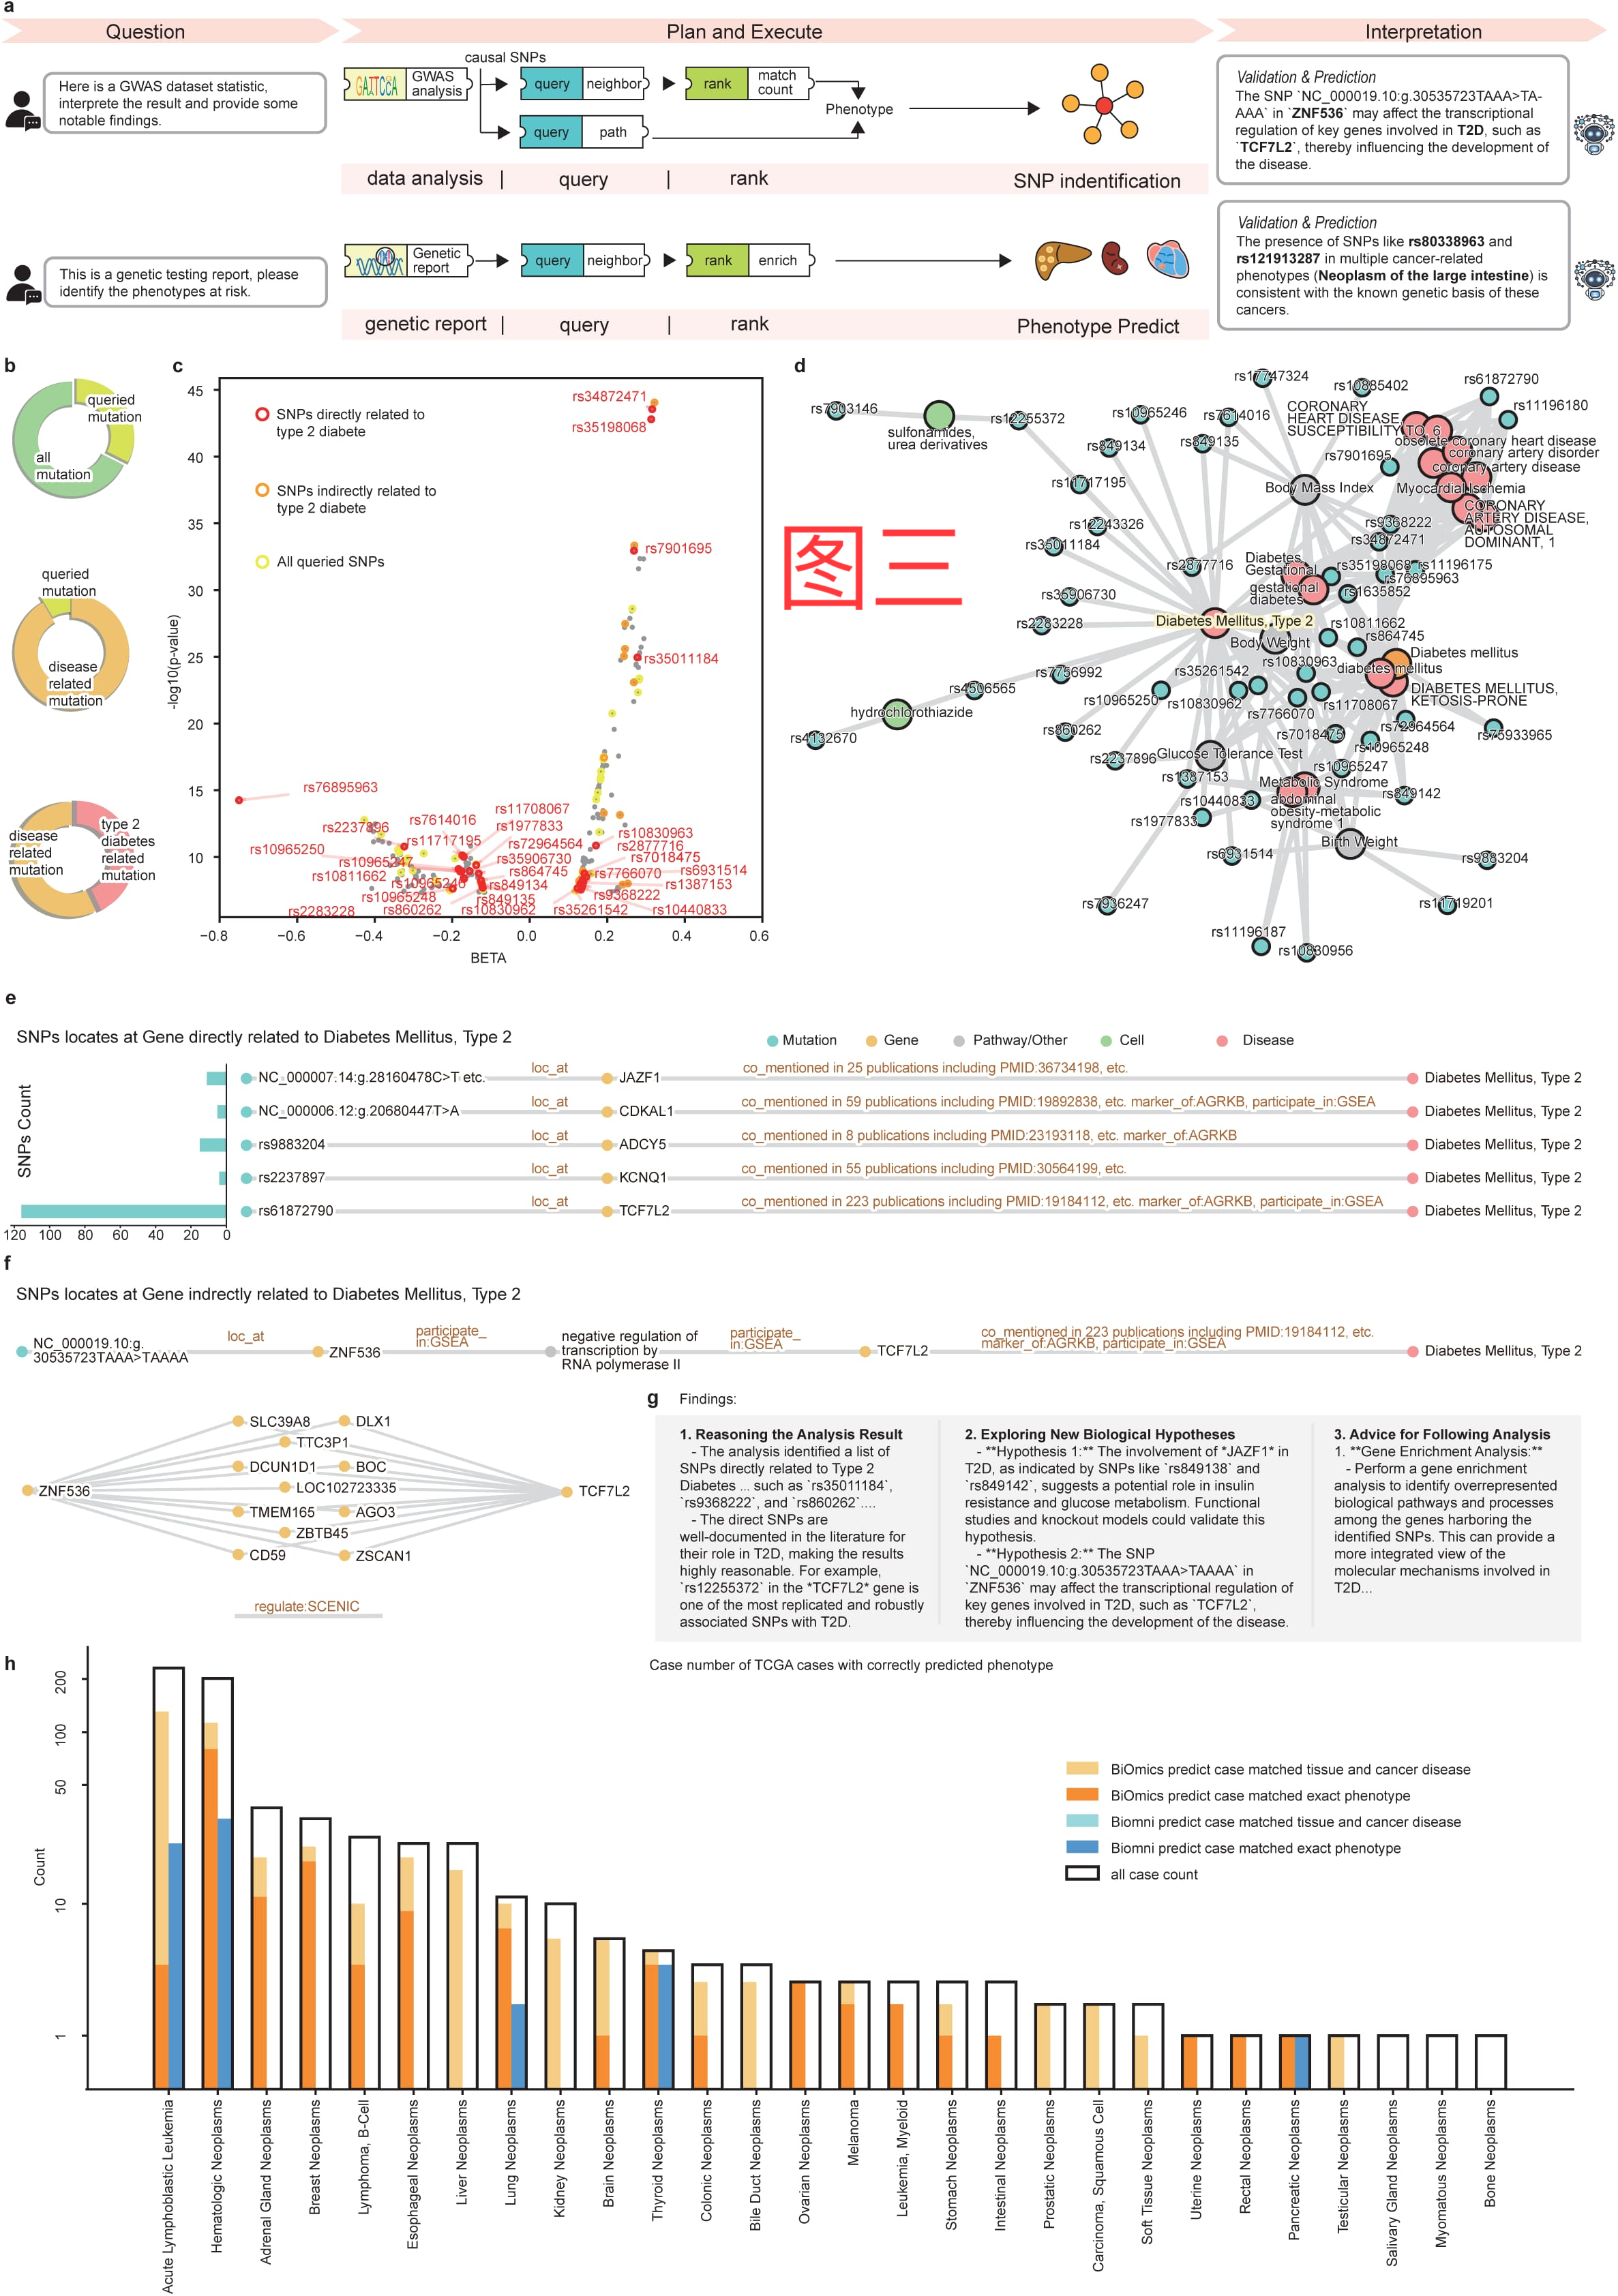 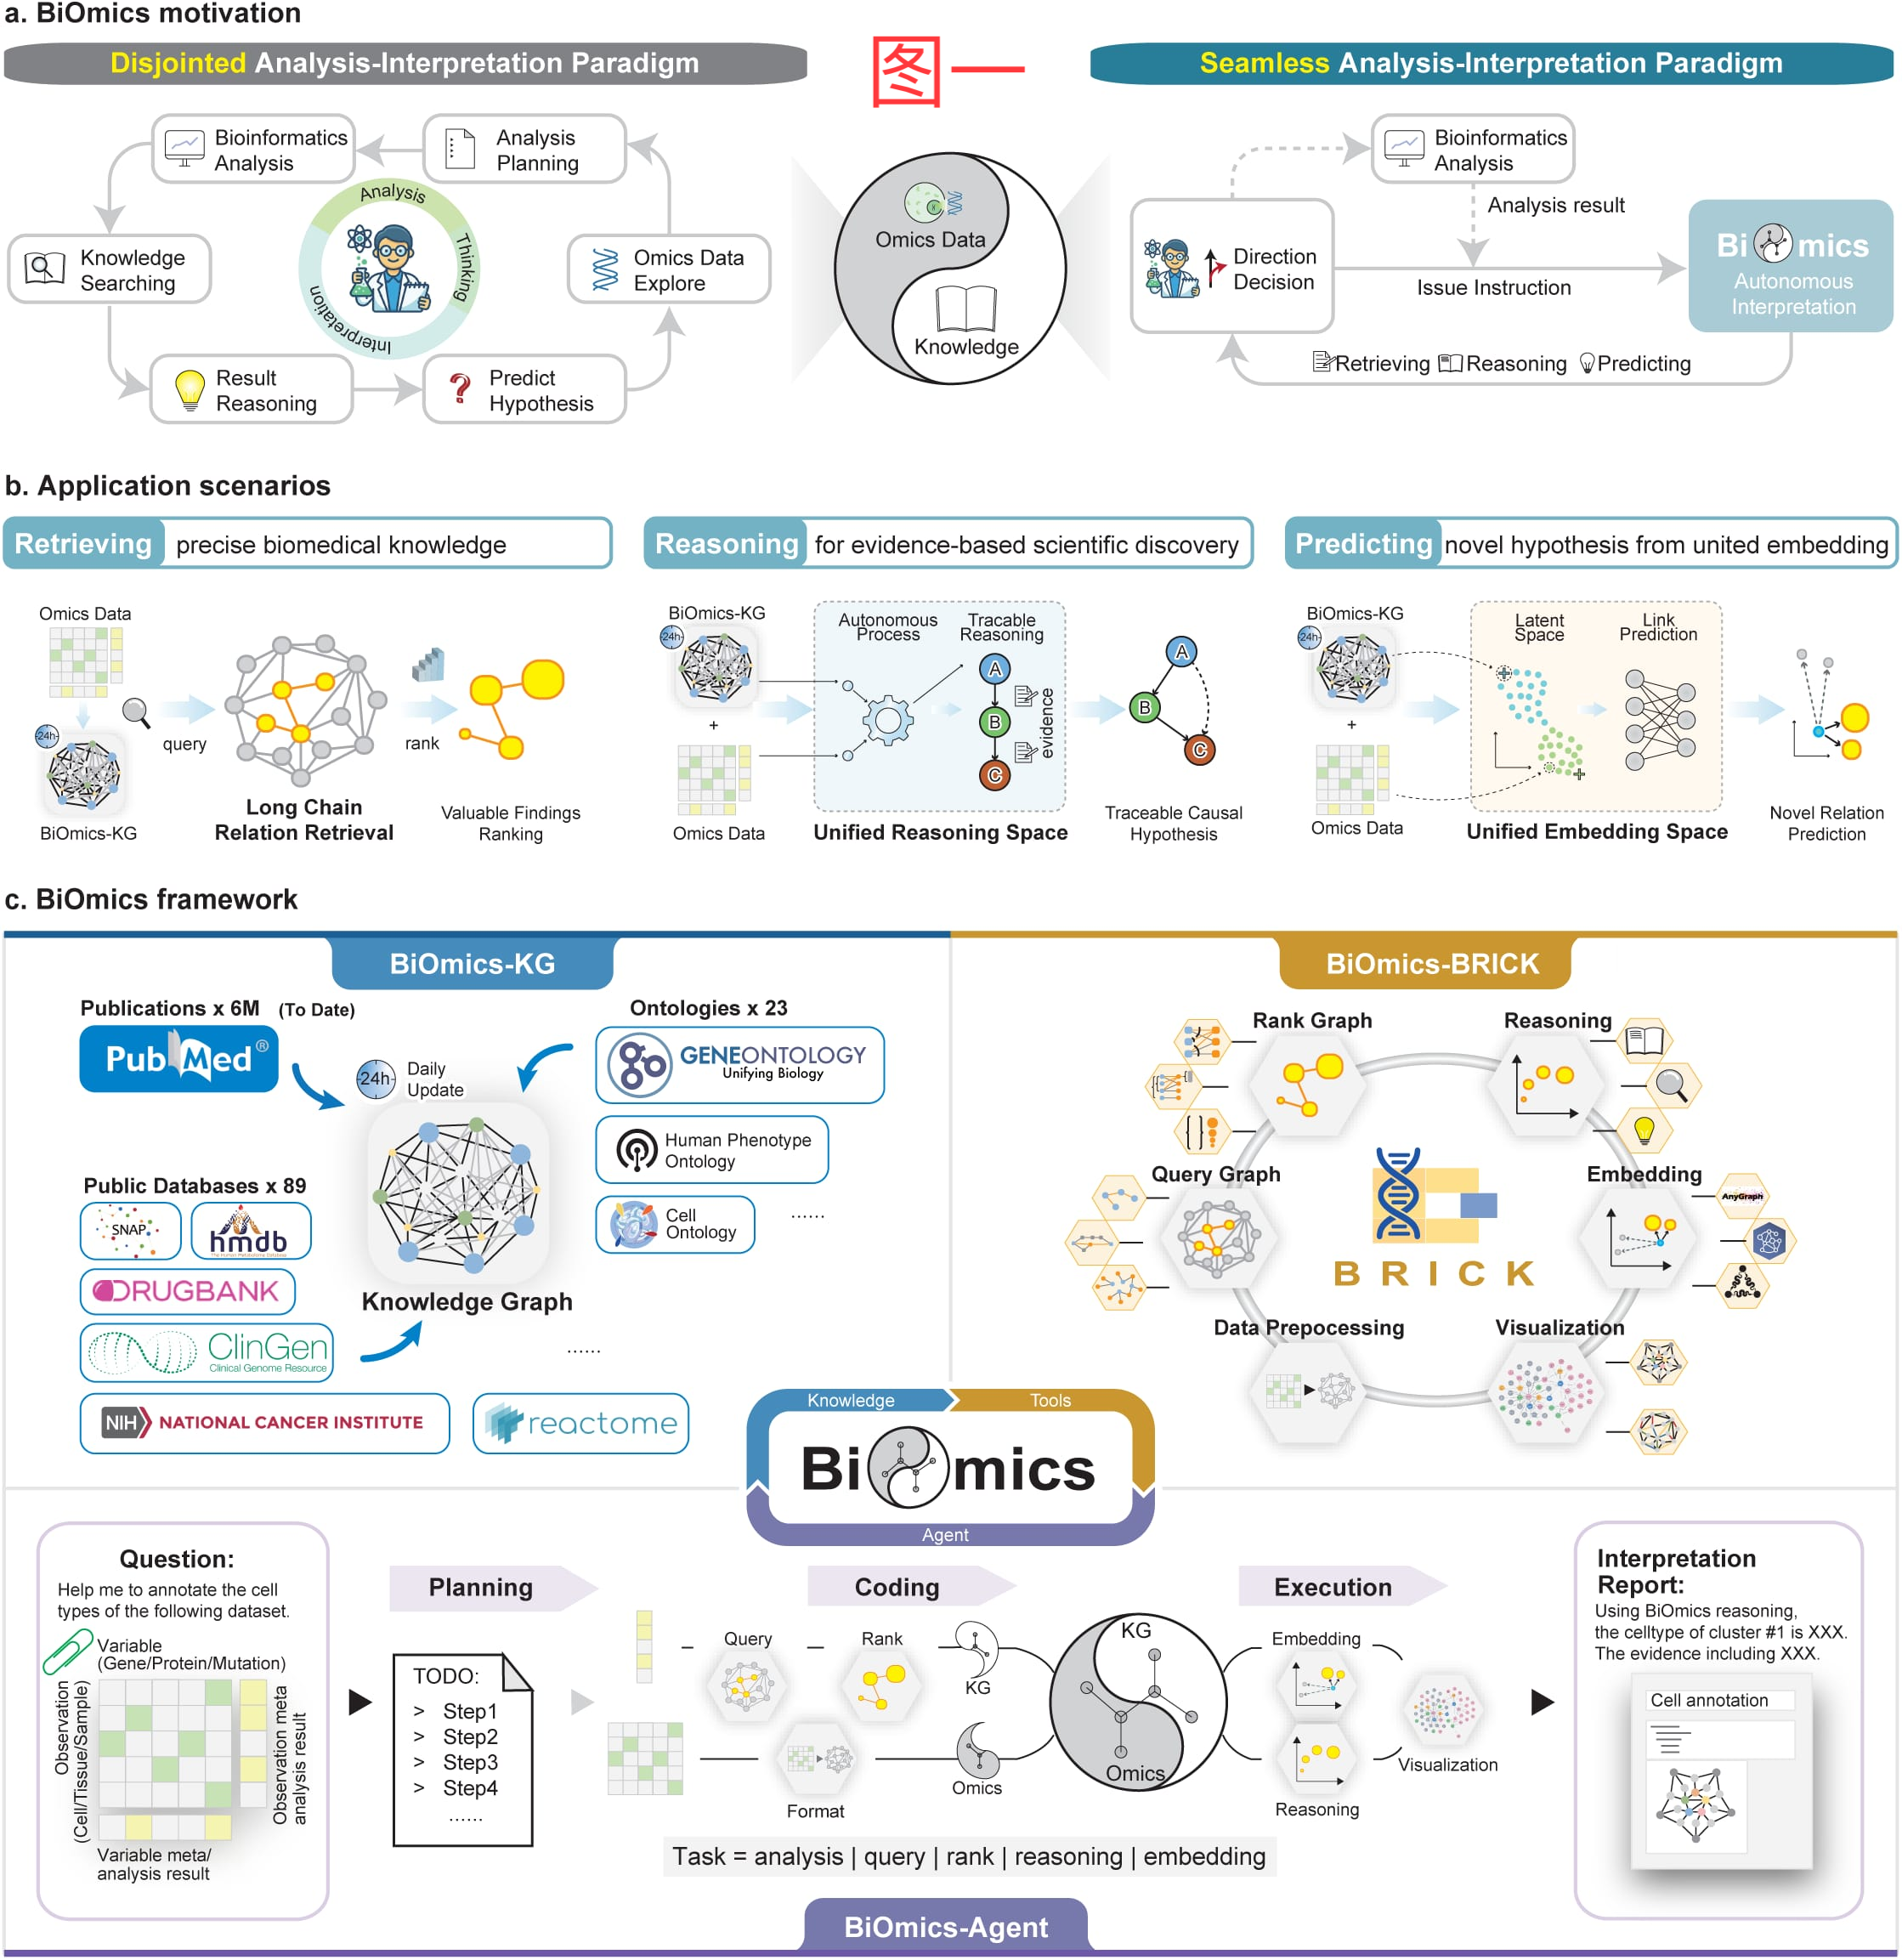 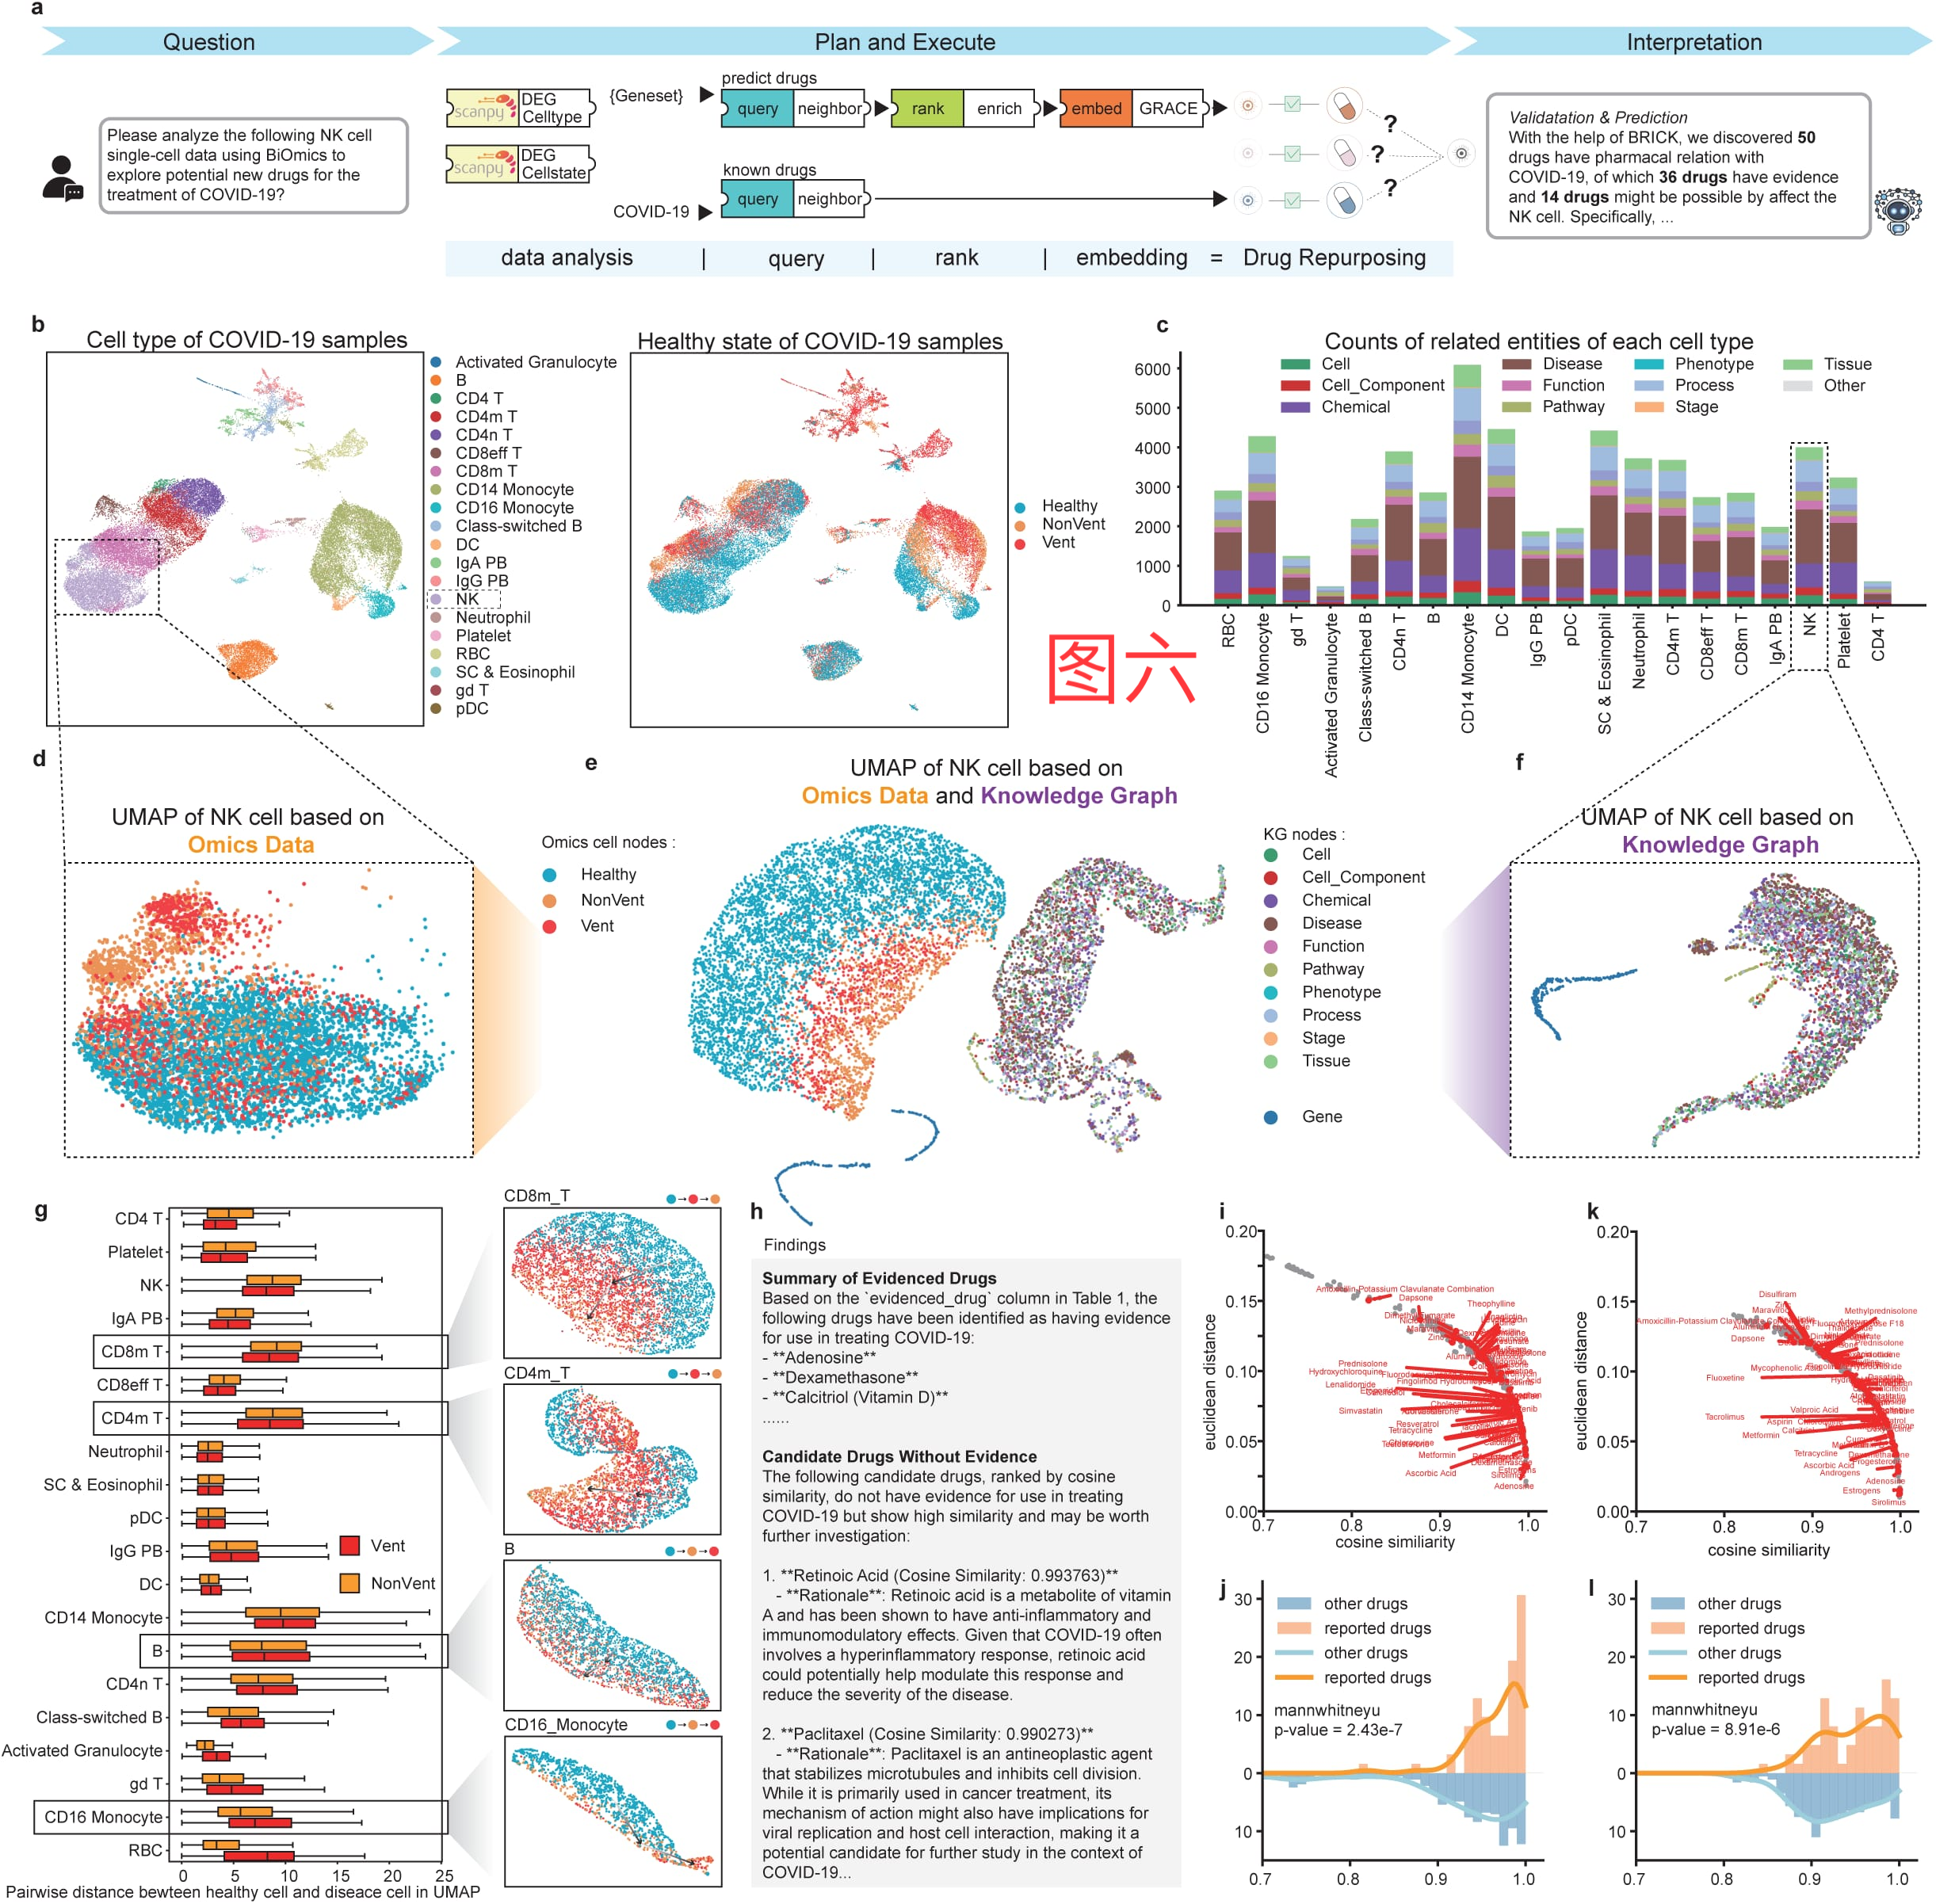 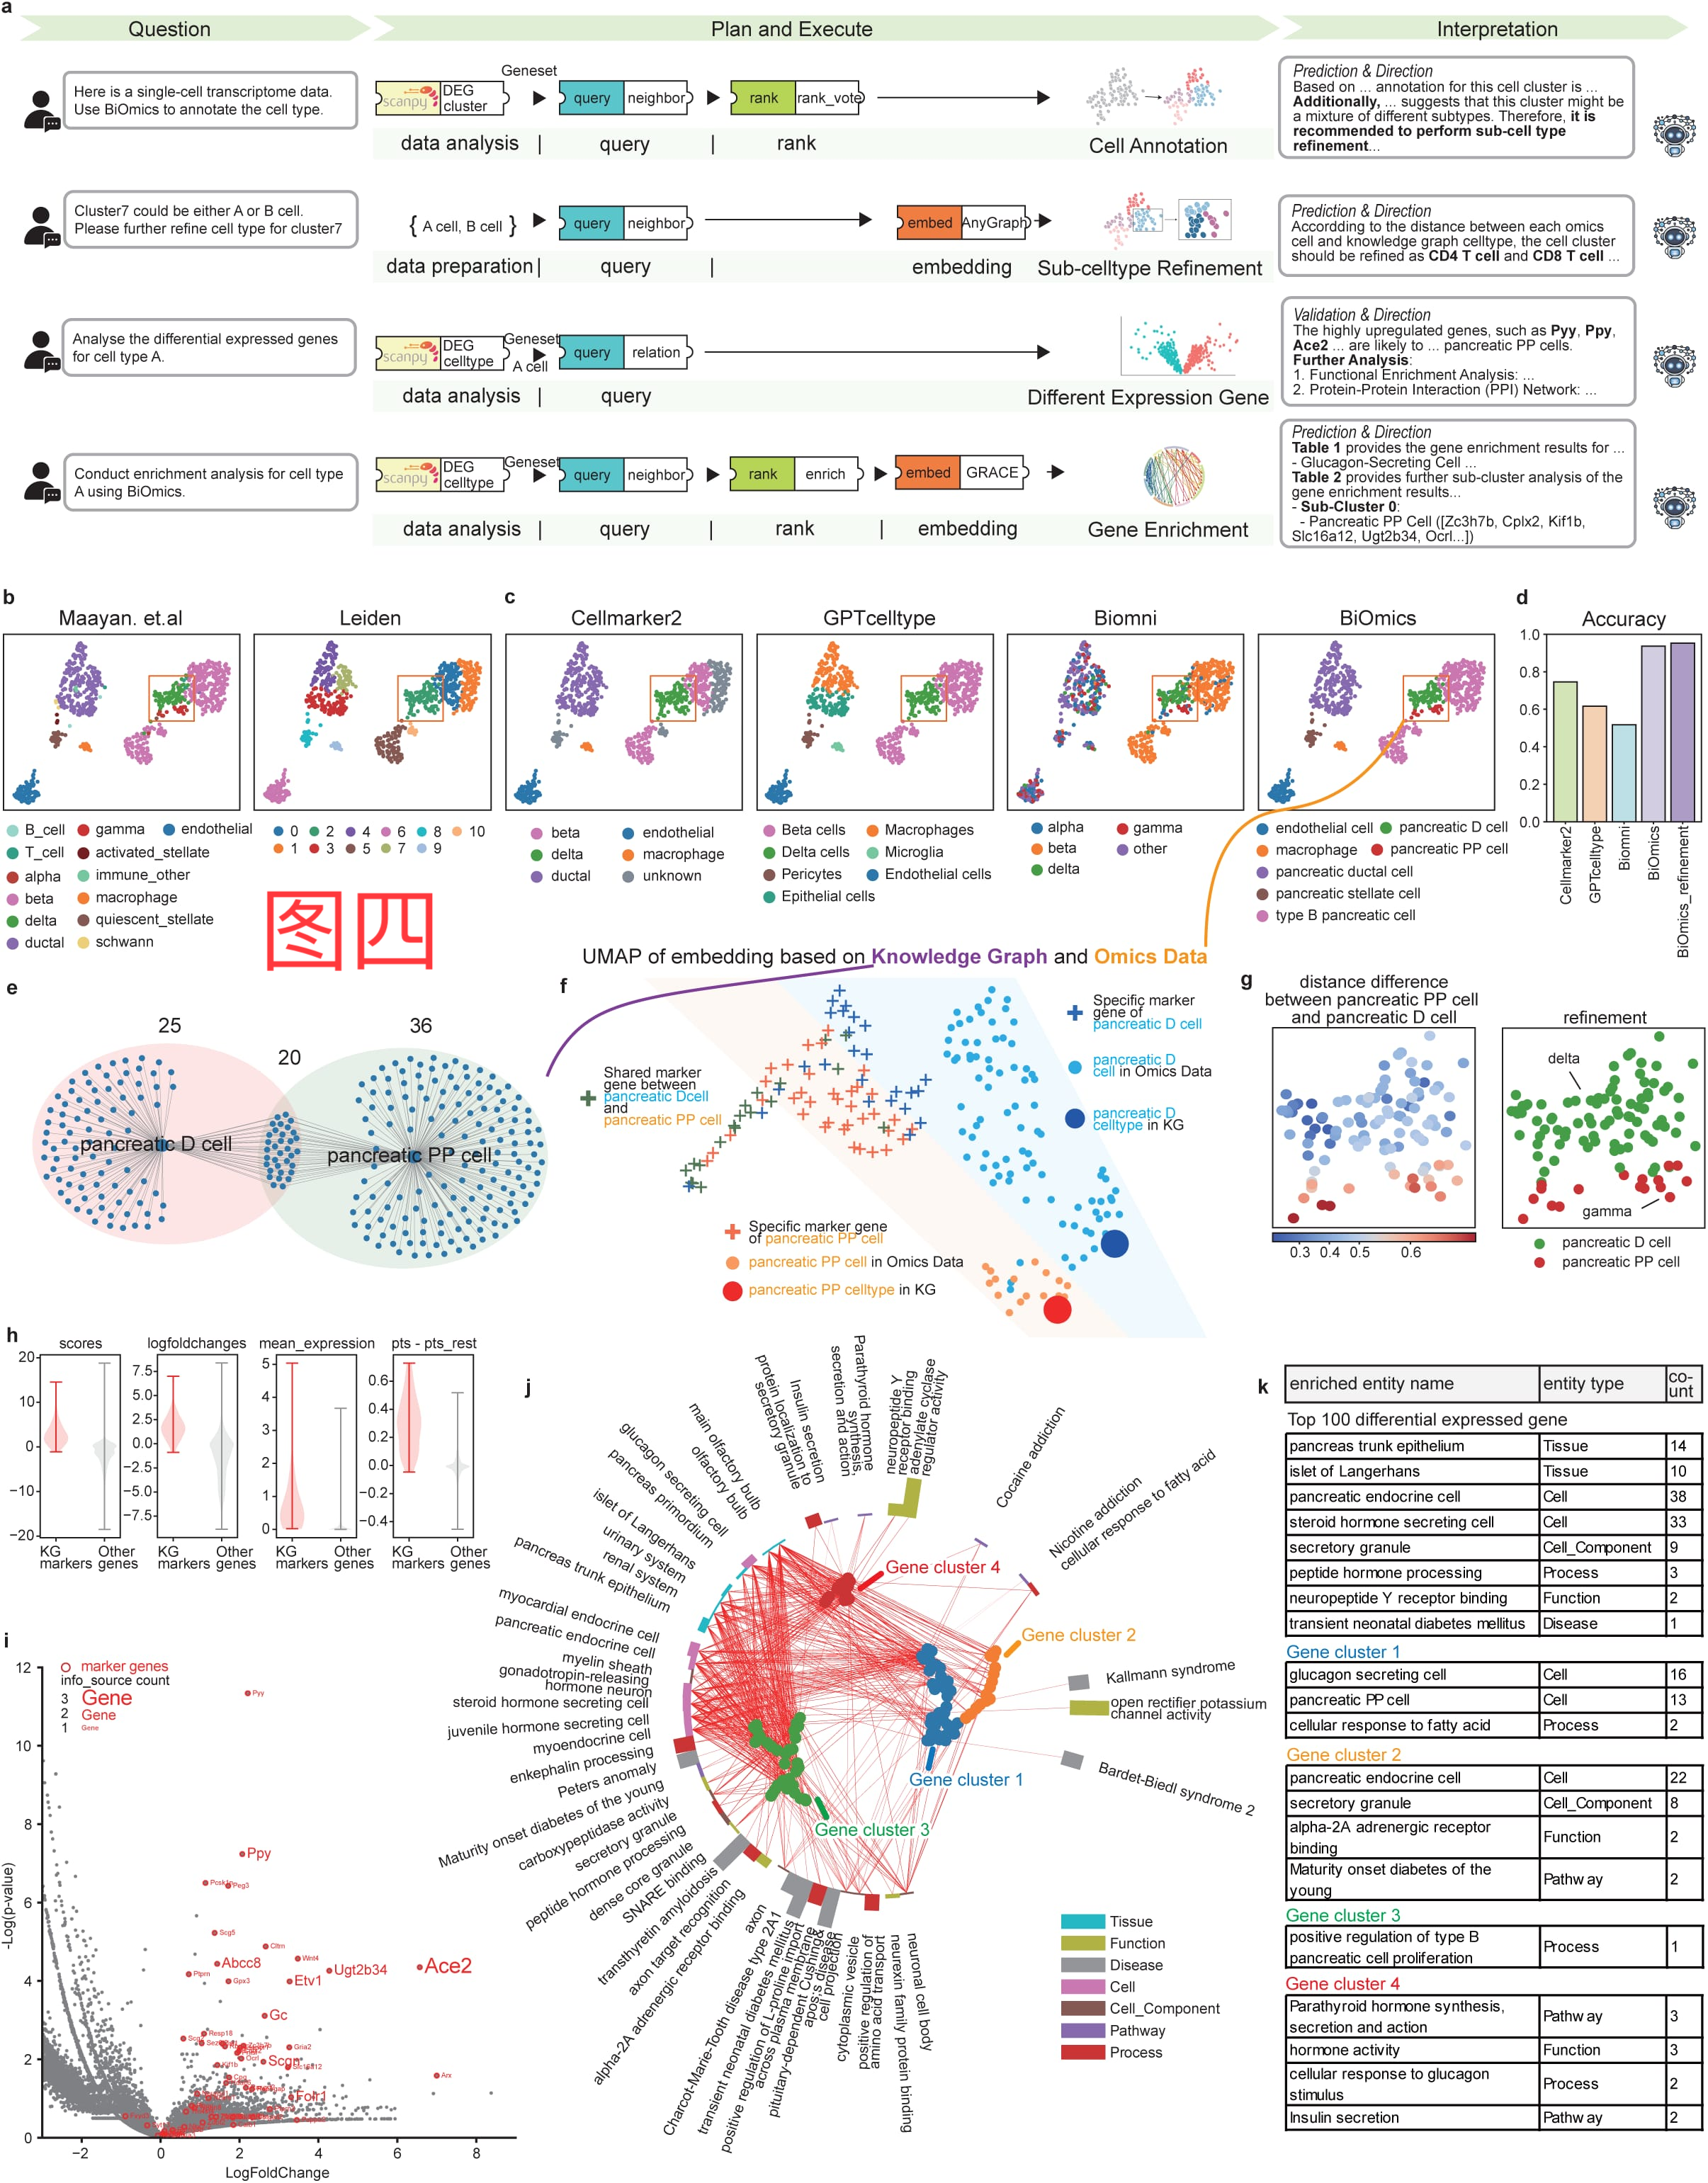 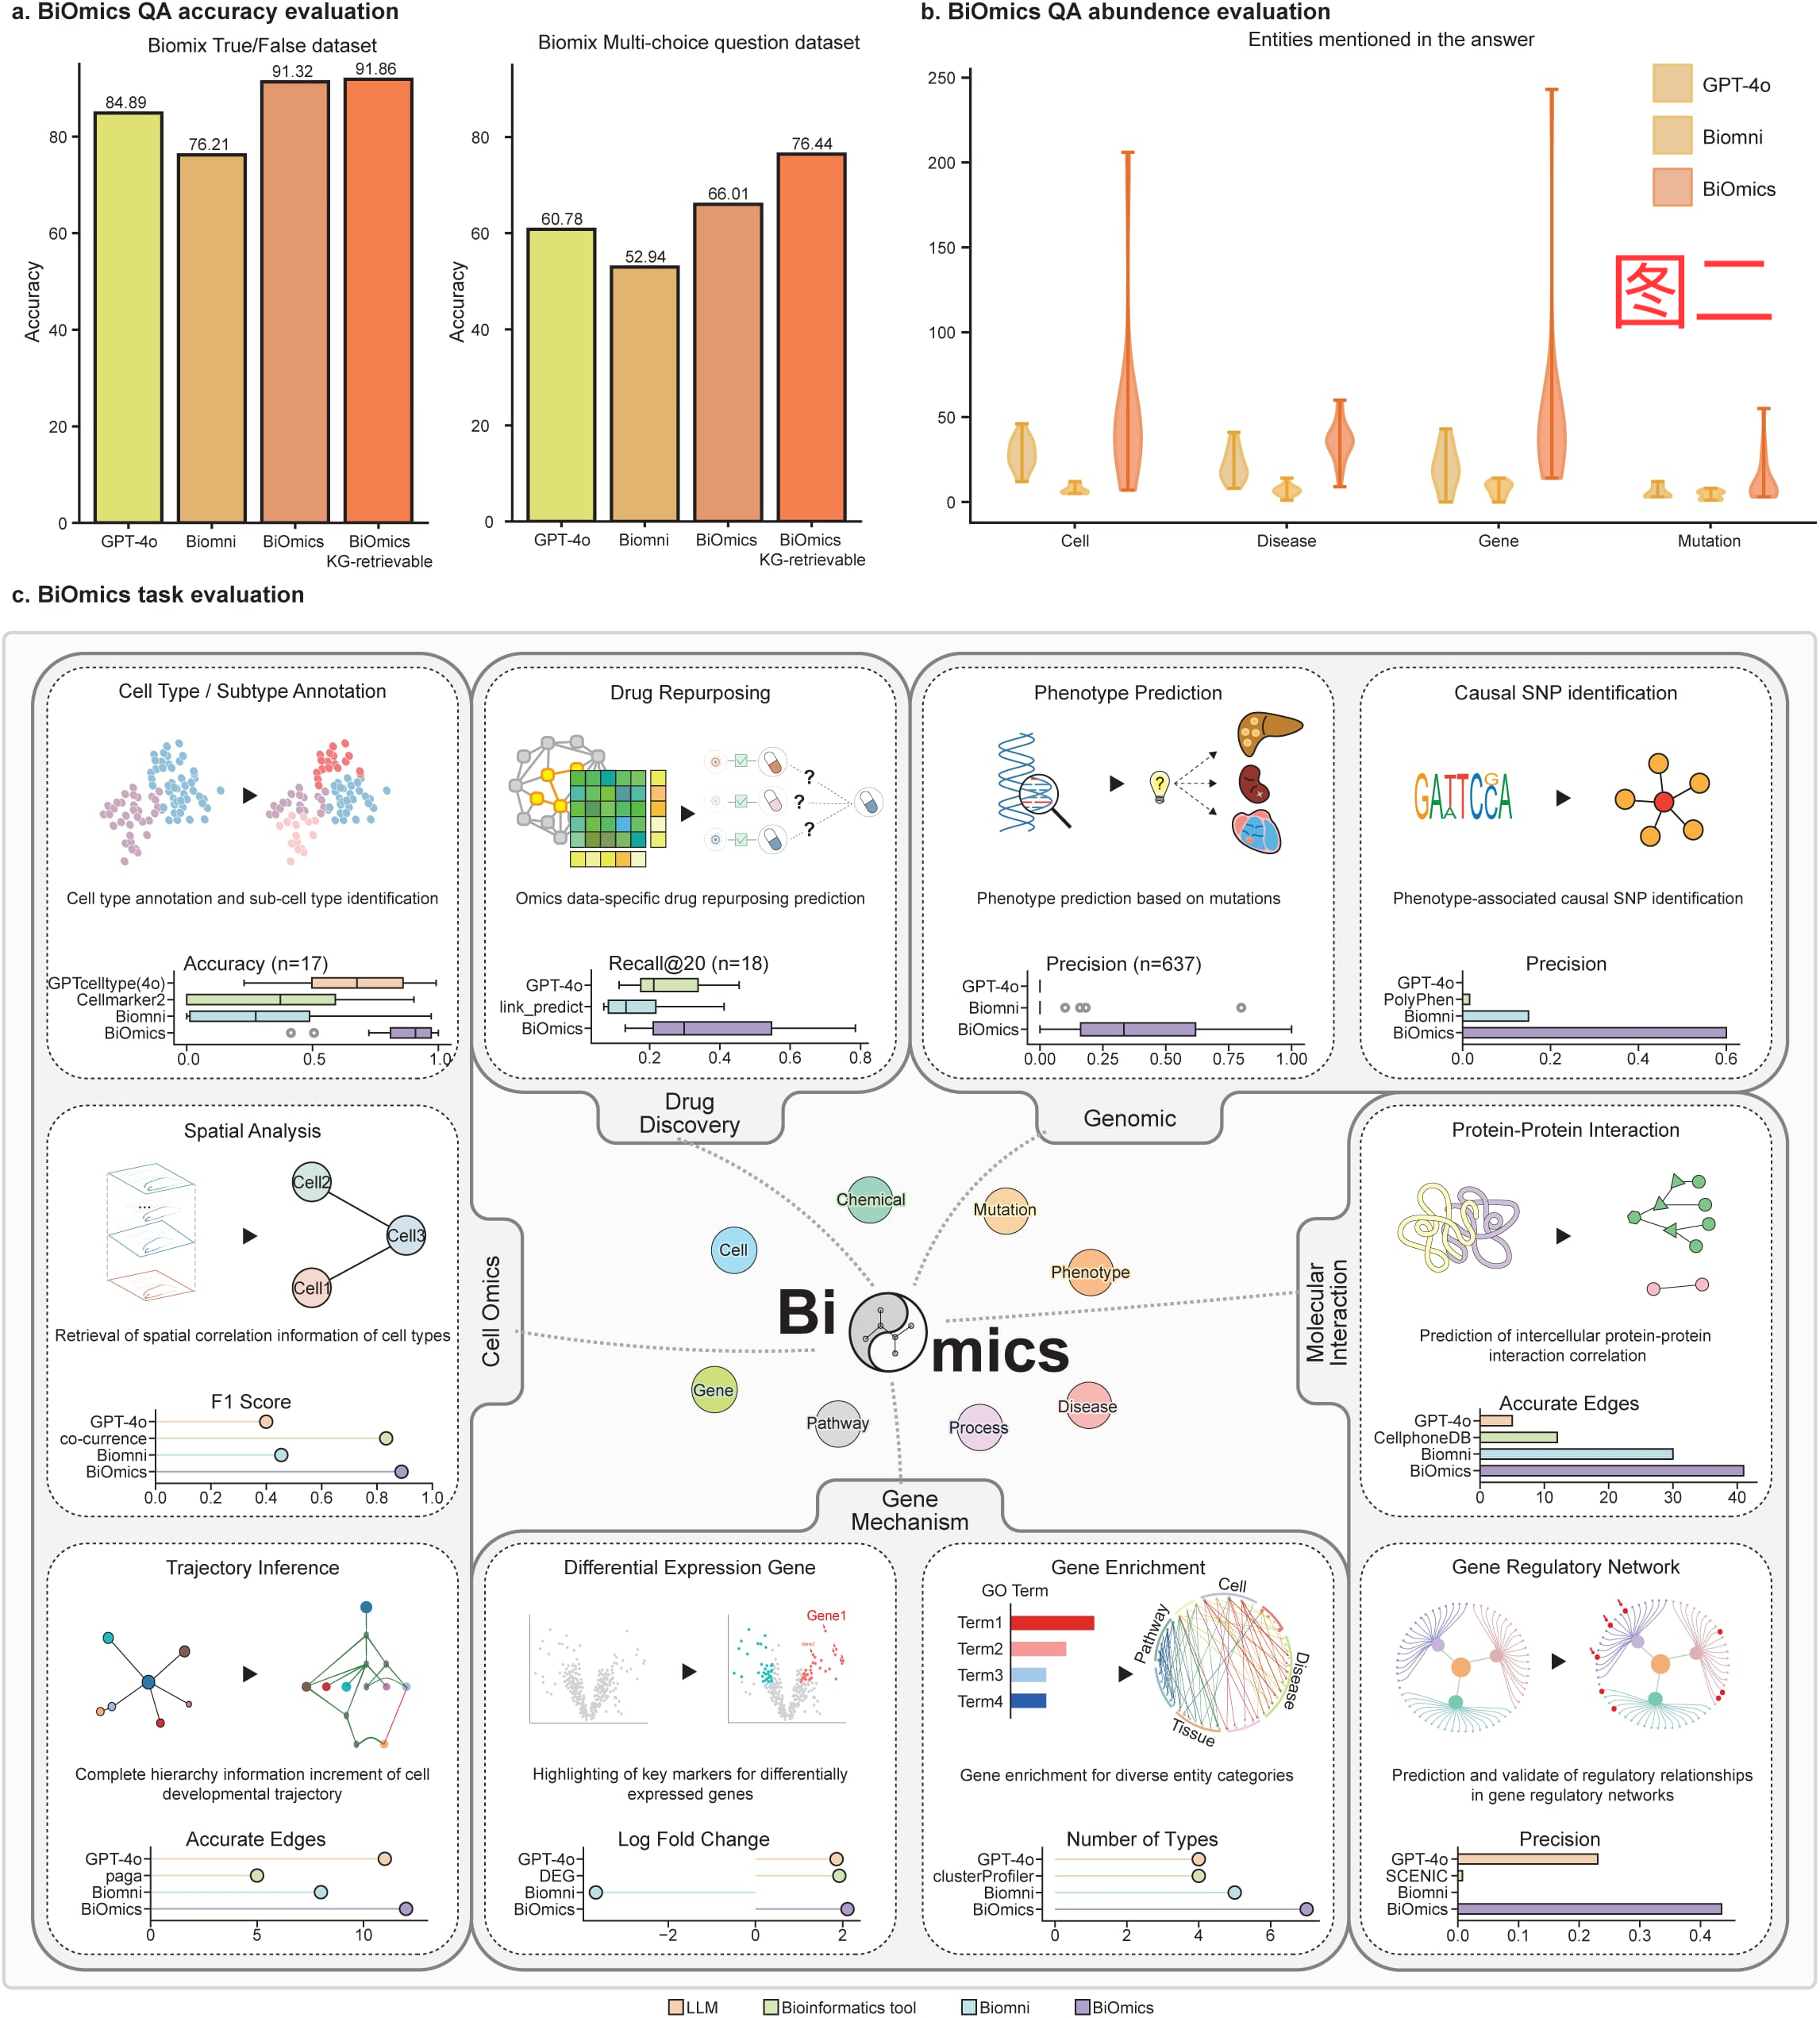 |
 回复此楼
» 猜你喜欢
 申博求助
已经有4人回复
-
27年申博自荐-能源/环境方向
已经有3人回复
-
闲聊
已经有3人回复
-
亲密关系
已经有13人回复
-
27秋申博自荐
已经有4人回复
» 本主题相关商家推荐: (我也要在这里推广)

