









| 查看: 136 | 回复: 0 | |||
[交流]
Genome Biology|零样本评测揭示单细胞基础模型的局限
|

|
▍导读 2025年,牛津大学与微软研究院团队在 Genome Biology 发表研究,对 scGPT 与 Geneformer 两个单细胞基础模型做零样本评测。在细胞类型分群与批次整合任务上,二者普遍未优于高变基因(HVG)选择及 scVI、Harmony 等经典方法,Geneformer 在批次整合各项指标上多在末位;基因表达重建评测也显示两者难以还原输入分布。作者据此主张把零样本评测纳入基础模型的开发与部署环节。 ▍研究背景 基础模型是在海量数据上预训练的机器学习模型,其表征既可在零样本设定下直接用于下游分析,也可借助少量数据快速专用化。单细胞领域近年涌现多个此类模型,多以自动完成细胞类型识别与基因表达预测为目标。 已提出的单细胞基础模型主要依赖微调,零样本设定下的探索有限。而在发现类研究中标签往往未知,难以开展依赖已知标签的监督微调,因此零样本性能对实际应用更为关键。 蛋白质序列与生物医学图像等领域的评测经验表明,零样本评测是判断预训练是否学到可迁移生物学理解的关键。但在单细胞基础模型中,这类评测仍不常见。 ▍研究方法 研究以统一基准对 scGPT 与 Geneformer 做零样本评测,并与高变基因选择、scVI、Harmony 三类基线对比: · 模型与基线:评测 Geneformer 与三个 scGPT 变体(肾 81.4 万细胞、血液与骨髓 1030 万细胞、非癌人类细胞 3300 万细胞);HVG 基线统一选择 2000 个高变基因,另与 scVI、Harmony 比较。需注意,scVI 与 Harmony 会在各目标数据集上拟合并显式使用批次标签,而 scGPT 与 Geneformer 直接进行零样本推理;这一不对称比较旨在模拟常见实际工作流。 · 数据集:使用胰腺、两组 PBMC、跨组织免疫细胞图谱与 Tabula Sapiens 五个数据集,覆盖技术批次与供体批次两类情形。 · 评测指标:以平均轮廓宽度与平均 BIO 分衡量细胞类型可分性,以批次整合分与主成分回归分衡量批次混匀,并另测基因表达重建表现。 ▍核心发现 1、零样本分群任务中两个基础模型不敌经典方法 总体上,两种模型的零样本嵌入在平均 BIO 分上表现不稳定。scGPT 仅在 PBMC(12k)数据集上优于 scVI、Harmony 与 HVG,在其余数据集上低于 scVI 和 Harmony;HVG 在总体比较中仍是很强的简单基线。 评测沿用 Atlas 级整合基准,以平均轮廓宽度、归一化互信息与调整兰德指数合成平均 BIO 分;其中 HVG 基线统一选择 2000 个高变基因。 这一结果出现在组织类型与测序平台都贴近预训练数据的条件下,说明零样本场景下基础模型的嵌入并未带来优势。(图 1) 图 1· 《细胞嵌入空间评测:平均 BIO 分与批次分对比》 · 来源:Kedzierska et al., 2025, Genome Biology · 点图与 UMAP 图 B、E 两栏以数据集点位对比 HVG、Harmony、scVI、scGPT 与 Geneformer 的平均 BIO 分和批次分,蓝色虚线表示跨数据集中位数;C、D 为胰腺数据集的 UMAP,分别按细胞类型和批次着色。读图先比较各数据集点位及虚线中位数,再看 UMAP 中细胞类型簇的分离度与批次是否混匀。 2、基因表达重建评测暴露预训练目标与表征的失配 在两模型的预训练目标上做重建评测,scGPT 预测分箱值、Geneformer 预测基因排序,输入统一采用全部基因未掩码的形式。 scGPT 在不使用细胞嵌入时预测误差高于直接取均值的朴素基线,引入细胞嵌入后提升有限;Geneformer 的排序相关中位数为 0.56。 作者提出两种解释:掩码语言建模框架本身未必产生有用的细胞嵌入,或模型并未真正学会预训练任务。(图 2) 图 2 · 《scGPT 与 Geneformer 的基因表达重建表现》 · 来源:Kedzierska et al., 2025, Genome Biology · 预测分布、散点图与点—误差线图 A、B 展示 scGPT 在两种预训练目标下按输入分箱得到的预测分布,应观察预测是否随输入分箱单调变化及其离散程度;C 展示 Geneformer 预测排序与输入排序的一致性,可看点云是否贴近对角线;D、E 为带误差范围的点图,蓝色虚线分别表示均值重构或平均排序基线。 3、批次整合任务中 Geneformer 多数指标垫底 在胰腺与 PBMC 等技术批次数据集上,scVI 与 Harmony 优于 scGPT;而在含供体差异的复杂数据集上,scGPT 优于 scVI 和 Harmony,但并非所有基线中表现最佳。 Geneformer 的嵌入在多数数据集上批次效应解释的方差占比高于原始数据,提示批次混匀不足。 综合各项指标,Geneformer 在批次混匀排名中稳定处于末位。 4、更大的预训练数据集未稳定带来更高表现 研究比较随机初始化 scGPT 与分别以 81.4 万、1030 万、3300 万细胞预训练的三个变体,三者的跨数据集中位分均高于随机基线。 在 PBMC 12k 数据集上预训练带来明显提升,但 3300 万细胞变体反而略低于 1030 万细胞变体。 此外,模型在曾用于预训练的评测数据上也未稳定优于基线,说明预训练目标与细胞类型分群之间的关系尚不清晰。由于不同变体的训练组织构成也不同,数据规模与数据组成相互混杂,不能据此推导普遍的规模上限。 5、主张设立专用基准数据集支撑可信评测 部分评测数据集曾参与预训练,使作者难以判断性能趋势是普遍规律还是数据重叠所致。 作者参考大语言模型的评测实践,提出设立专用评测数据集的思路,并强调这类数据应具代表性且与训练数据相互独立。 作者还建议后续把计算评测与针对性的体外实验结合,为基因—基因相互作用建立可信参照。 ▍核心结论速览 · scGPT 与 Geneformer 零样本分群普遍不敌 HVG 与 scVI、Harmony。 · 批次整合任务中 Geneformer 在多数指标上垫底。 · 在本研究比较的 scGPT 变体中,更大的预训练集未稳定带来更高分数;规模与组织构成的影响尚不能完全分离。 · 基因表达重建显示掩码语言建模目标与表征可能失配。 · 作者主张设立仅供评测、不参与预训练的基准数据集。 ▍研究意义 · 科学价值:以统一基准同时评测分群、批次整合与预训练目标重建,指出零样本评测可暴露微调评测无法发现的脆弱性,为单细胞基础模型的开发流程提供参照。 · 产业价值:评测结果显示简单基线在若干任务上仍具竞争力,为工具选型与算力投入提供了更保守、可复核的判断依据。 ▍局限与下一步方向 作者指出:部分评测数据集曾用于模型预训练,使性能趋势是普遍规律还是数据重叠所致难以区分,建议以专用评测数据集加以缓解;本研究数据集仅包含转录组数据,且只覆盖有限模型与数据,并未穷尽单细胞分析的全部应用;未来还需深入考察模型如何辨别基因—基因相互作用,并把计算评测与针对性的体外实验结合以获得可信参照。 ▍FAQ Q:什么是零样本评测? 指模型不做任何进一步训练,直接用其内部嵌入完成下游分析。对标签未知的发现类研究尤其关键,因为这类场景下难以开展依赖已知标签的监督微调。 Q:为什么基础模型会输给简单方法? 一种可能是掩码语言建模框架未产生有用的细胞嵌入,另一种是模型没有真正学会预训练任务。在本研究比较的 scGPT 变体中,更大的预训练数据集没有稳定改善这一点,但数据规模与组织构成的作用仍需进一步区分。 Q:高变基因选择为什么能作为基线? 它只保留表达变异最大的 2000 个基因,流程简单、无需训练。在分群与批次整合两类任务上,这一朴素做法反而常优于基础模型嵌入。 Q:预训练数据重叠会造成什么影响? 若评测数据曾参与预训练,就难以区分模型表现来自先前数据暴露还是可迁移的泛化能力。本研究中模型在见过的数据上同样未稳定占优,说明重叠并不能解释全部结果。 Q:这项工作对模型开发有什么建议? 作者主张把零样本评测纳入开发与部署流程,并构建仅供评测、永不用于预训练的基准数据集,让性能评估更接近真实应用场景。 ▍君录视角 · 虚拟细胞 解决的问题:单细胞基础模型的性能宣称多来自微调场景,而发现类研究中标签往往未知、难以开展依赖已知标签的监督微调,零样本能力此前缺少系统核查。该研究以统一基准覆盖分群、批次整合与预训练目标重建,把零样本表现在同一坐标系下摊开,指出模型在贴近预训练分布的数据上仍可能被简单基线超过。 集成判断:这是一篇方法学评测工作,本身不提供新模型,价值在于给下游流程的选型与验收设定了更保守的参照。把基础模型接入现有分析流程时,宜先用自有数据做零样本对拍,与高变基因选择、scVI、Harmony 等轻量基线同台比较,再决定是否引入;同时应记录评测数据与预训练数据的重叠情况,避免把数据重叠带来的表现误读为泛化能力。 ▍原文信息 Kedzierska KZ, Crawford L, Amini AP, Lu AX. Zero-shot evaluation reveals limitations of single-cell foundation models. Genome Biology. 2025;26(1):101. doi:10.1186/s13059-025-03574-x. PMID: 40251685; PMCID: PMC12007350 ▍关于我们 君录生物 · 以数据驱动创新药早期开发 自建心血管单细胞数据库 HeCellAstra,对话式生信分析平台IntelliCytoPilot 做靶点发现与药物管线早期资产 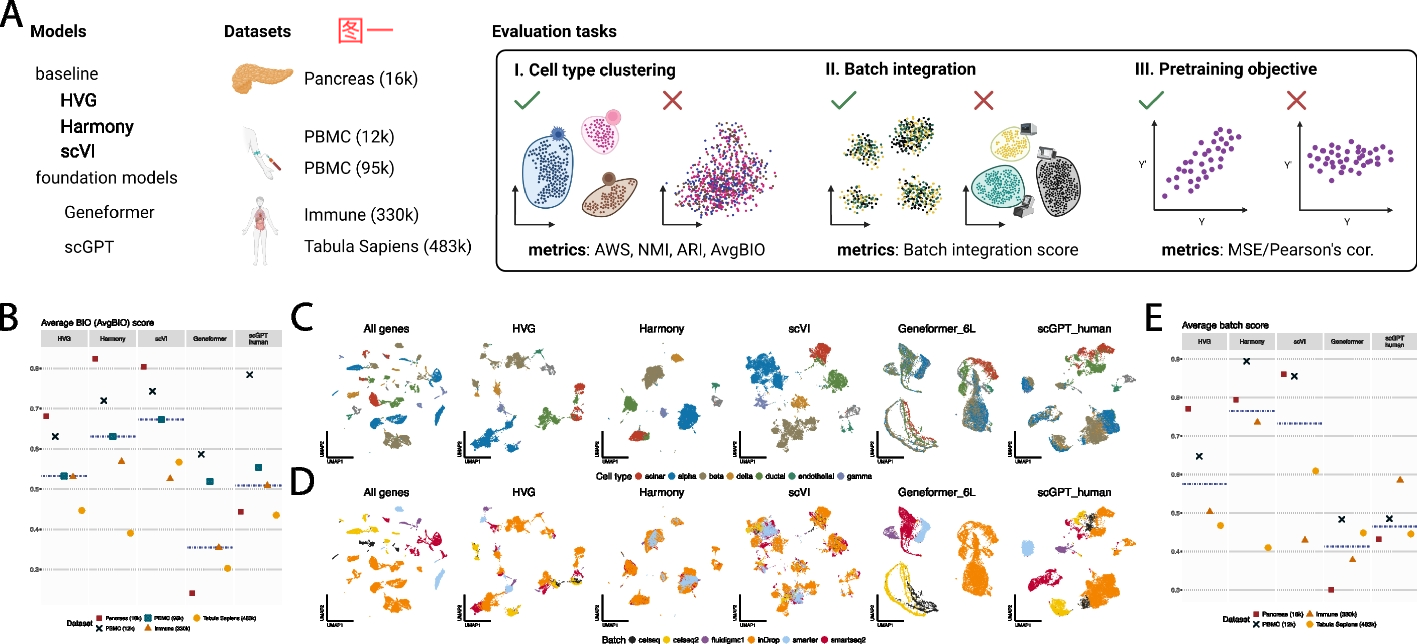 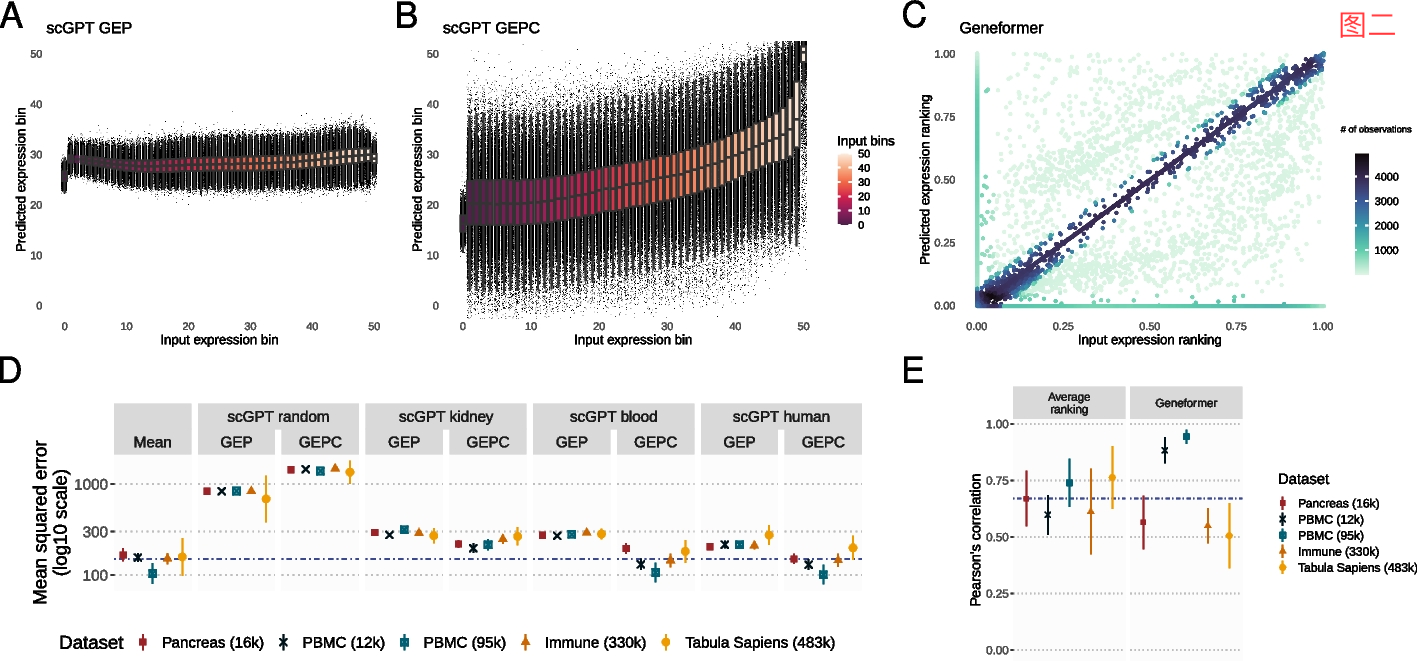 |
 回复此楼
» 猜你喜欢
 售SCI-T0P文章,我:8O.5.5.1.O.54,科目齐全,可+急
已经有16人回复
-
售SCI文章,我:8O.5.5.1O.54,科目全,可十急
已经有21人回复
-
越来越担心硕士毕业后没有竞争力了
已经有14人回复
-
论文的挂名怎么评判贡献?基金申请中,排名第一的挂名文章
已经有3人回复
-
申博自荐 2篇一区TOP+1篇EI+2公开发明专利 2027博士申请
已经有3人回复
-
闲聊
已经有6人回复
-
申博求助
已经有4人回复
