









| 查看: 57 | 回复: 3 | |||
| 【有奖交流】积极回复本帖子,参与交流,就有机会分得作者 peterfxmc 的 2 个金币 ,回帖就立即获得 1 个金币,每人有 1 次机会 | |||
peterfxmc新虫 (小有名气)
|
[交流]
从游戏帧率到QMC持续吞吐量:大模型本机部署做论文研读与脚本排错工作站
|
||

|
从游戏帧率到QMC持续吞吐量:大模型本机部署做论文研读与脚本排错,张量网络DMRG到量子蒙特卡洛的算力工作站怎么选 你懂游戏PC,但你可能不懂科学计算 你可能装过游戏主机,甚至帮同学挑过显卡:这张卡跑某款游戏多少帧、那张卡的光追强不强。但当你走进计算物理的世界,评分体系整个换了一套。 南京航空航天大学理学院的应用物理方向有一个很有代表性的研究领域:量子多体物理与量子信息。按照院系公开的研究介绍,这个方向关心凝聚态里的奇异物相和量子临界现象,而干活的家伙什里赫然列着两类数值方法--DMRG(密度矩阵重整化群)和iTEBD(无限时间演化块消减算法),两者都属于张量网络方法家族。2024年6月,北京计算科学研究中心举办的“量子磁性与多体计算”培训班上,南京航空航天大学的罗强副研究员作为特邀主讲人之一,讲的正是强关联电子体系中的量子磁性、量子物质和量子材料。 换句话说,在今天的应用物理专业里,"做物理"和"跑计算"早已是同一件事的两个侧面。而你手里那套从游戏世界习得的经验,有些依然管用,有些却会悄悄把你带进沟里。这篇文章就想把两套评分体系之间的差异聊清楚:量子多体问题到底在算什么,这些计算对硬件提出了什么要求,以及大模型本机部署为什么成了新一代计算物理工作者的标配。 量子多体问题:一堵指数增长的墙 问题从哪来 量子力学的基本方程大家都不陌生,但"会写方程"和"会解方程"之间隔着一堵指数墙。一个量子自旋体系的希尔伯特空间维度随粒子数指数膨胀:30个自旋1/2粒子,状态数就已经超过10亿;50个粒子,普通计算机的内存连一个完整的波函数都存不下。而真实的量子磁性材料、高温超导候选体系,粒子数是阿伏伽德罗常数量级的。物理学家能做的,是在经典计算机上用聪明的算法去逼近这些系统的真实行为。 这就引出了两条主流技术路线,也是本文的主角。 路线一:量子蒙特卡洛(QMC) 量子蒙特卡洛的思路是统计抽样。把量子体系映射成一个经典统计模型,设计一套马尔可夫链在其中做随机游走,通过大量采样来估算物理量的系综平均。常见的实现有随机序列展开(SSE)和辅助场量子蒙特卡洛(AFQMC)等。 这类方法有一个非常讨喜的特点:天然并行。每条马尔可夫链之间相互独立,你有一百个核心,就能同时跑一百条链,最后把结果合并统计误差。因此QMC对硬件的诉求可以概括为:尽可能多的物理核心、尽可能高的内存带宽、以及能扛住数天甚至数周满载的稳定散热。2025年初,arXiv上关于GPU加速AFQMC的研究工作也验证了一点:相位自由的AFQMC(ph-AFQMC)可以被GPU显著加速,把可处理的轨道空间推向更大规模。 路线二:张量网络 张量网络换了一个角度。它利用量子多体波函数"纠缠熵有限"这一物理事实,用一串低阶张量的乘积来压缩表达原本指数大的波函数。DMRG处理一维链和梯子是一把好手,iTEBD适合无限大均匀体系,而PEPS、CTMRG这些方法在向二维推进。 张量网络的计算形态和QMC完全不同:它换了一套打法,围绕矩阵乘积态的键维χ做一轮又一轮的奇异值分解和张量收缩。这类计算往往是内存带宽受限的串行迭代,一颗高频大缓存的处理器加足够大的内存,比一堆弱核更有用。二维张量网络对内存的胃口尤其惊人,键维稍微开大一点,单节点几百GB内存眨眼就满。 一个真实的案例:TMGO"寻参记" 这两条路线配合的威力,有一个漂亮的真实样本。二维阻挫磁性晶体TmMgGaO4(简称TMGO)的微观模型长期不明:三角晶格量子伊辛模型是一个合理的出发点,但模型参数谁来定?北京航空航天大学物理学院的研究团队开发了指数热态张量网络方法(XTRG),计算出模型体系的比热、磁化率随温度和磁场的变化,再与实验测得的磁热力学数据反复比对,最终确定了正确的微观模型和精确参数。复旦大学的研究团队基于这套参数,预测该体系会在特定温区出现拓扑Kosterlitz-Thouless(KT)相--这种相此前从未在量子磁性材料中被找到。随后量子蒙特卡洛计算了模型的自旋动力学谱函数,与非弹性中子散射实验测得的自旋谱函数完全吻合;南京大学的实验团队生长单晶样品,用核磁共振测到了KT相温区内自旋-晶格弛豫率的特征平台,与理论预言相互印证。这套"张量网络寻参、QMC验证动力学、实验最终拍板"的组合拳,发表于2020年前后的系列工作中,如今已是量子磁体研究的范式操作。 范式背后是真金白银的机时:XTRG要在宽温区做高精度热力学计算,QMC要算谱函数这种比平衡态难一个量级观测量。没有一台靠谱的工作站,这些计算根本排不上日程。 三套类比,把硬件需求翻译成人话 类比一:游戏帧率 vs 持续吞吐量 游戏显卡宣传页上最显眼的是瞬时帧率:某款大作在2K分辨率下平均多少帧。但帧率测的是短时间爆发,跑十分钟甜甜圈烤机不降频、跑三周QMC不蓝屏,靠的是另一套功夫--供电余量、散热风道、VRM温度。QMC的一个典型生产任务,是让马尔可夫链在数十亿量级的蒙特卡洛步数上稳定演化,误差棒随采样量按平方根压缩,你多熬一周机时,误差就小一分。这种负载下,消费级显卡和游戏主机常见的温度墙、功耗墙偷降频,会直接体现在你的误差统计里:两条链算出的结果漂移了,你还以为发现了新物理。 类比二:显存和内存,相当于相机的RAW格式 玩摄影的都知道RAW比JPG占地方,但后期空间大。科学计算里对应的概念是精度:张量网络的SVD分解、QMC的配分函数求和,主流都用双精度浮点(FP64),数据宽度是消费级AI推理常用半精度(FP16)的四倍。更关键的是内存总量:键维χ开到一千以上的二维张量网络收缩,工作集轻松越过256GB;而"内存不够砍键维"这件事,和"像素不够裁构图"一样,都是先污染后治理的妥协--截断误差会悄悄渗进你的相图结论。 类比三:水冷,相当于越野车的涉水喉 越野改装圈里,涉水喉看着像炫技,实则是极端工况下的保险。工作站的水冷同理。QMC和张量网络作业动辄全核满载连续跑数天,夏天实验室空调一罢工,风冷机箱里的CPU温度立刻顶到降频线,跑了两周的算例可能出现静默错误。水冷的意义在于把持续散热能力做厚,让处理器在全核睿频上待得住。同样道理也适用于整机的系统级设计:内存通道插满后的供电与散热、多块硬盘同时读写的风道,都不是单件堆料能解决的。 论文研读与脚本排错:大模型本机部署的用武之地 聊完物理计算本身,有个现实问题绕不开:计算物理工作者每天还有大量"非物理"的脑力劳动--读论文、写代码、调bug。这正是大模型本机部署能接管的场景。 为什么要在本地部署 一来是数据隐私。课题组未发表的手稿、内部讨论笔记、正在做的课题思路,丢给云端API等于把学术优先权交了出去;本地部署模型全部数据不出机,这是底线。二来是长期成本,一个课题组每天几十上百次问答,API按token计费一年下来并不便宜,本地一次投入,边际成本接近电费。三来是离线可用,出差开会、假期居家,工作站上的模型服务照常在线。 选哪两个模型 结合计算物理的日常,有两款开源模型非常趁手: R1-Distill-Qwen-32B  eepSeek-R1的蒸馏版本,具备长链推理能力,适合啃物理论文--把一篇几十页的arXiv预印本丢给它,让它梳理推导链条、解释群论记号、总结实验与理论的对应关系,长链推理恰好用在刀刃上。写于2025年1月的这个蒸馏版本,是当前32B档位里推理能力的标杆之一。 Qwen2.5-14B-Instruct:2024年9月发布的通用指令模型,响应快、代码能力强,适合当随身的排错搭子--SSE循环里的数组越界、DMRG代码里规范形没更新干净、张量缩并维度对不上,把报错栈贴给它,大概率能指出问题所在。 显存怎么算 估算公式很简单: 所需显存 ≈ 参数量(B) × 量化字节数 × 1.2 FP16每参数2字节,Q8每参数1字节,Q4每参数0.5字节,1.2是给KV cache和系统开销的预留系数。三档的取舍很直白:FP16无损但太占地方,Q8几乎无损但容量依旧可观,Q4把权重压到半字节、对推理类任务的精度损失通常在可接受范围,所以成了消费级显卡上的默认选择--宁可模型大一点,也要先装得下。 模型 FP16 Q8 Q4 Q4舒适档 Qwen2.5-14B-Instruct 约34 GB 约17 GB 约9 GB 12~16 GB显存 R1-Distill-Qwen-32B 约77 GB 约38 GB 约19~22 GB 24 GB显存 所以一台带24 GB显存的单卡工作站,就能让32B的蒸馏模型在Q4量化下从容运行,解码速度有几十tokens/s,读论文的等待感完全可接受;14B模型更是轻松加愉快。 这里必须交代速度的数量级:同样的32B模型,纯CPU推理只有个位数tokens/s,读一段摘要要干等半天;单卡GPU则是几十到上百tokens/s,体验天差地别。这就是"为什么需要一台工作站而不是一台普通办公电脑"的直接答案。 还有微调的分层。如果只想让14B模型学会课题组的文献术语和黑话,LoRA轻量化微调的显存增量只有3~5 GB,推理档位加一块大显存卡就够用;但要是做全参数微调,7B模型就要吃掉80 GB以上显存--那是训练机的世界,档位选择直接上移。 主流软件生态一览 工欲善其事,先装对软件。这个领域的开源生态相当成熟,按用途分大致是这样几块: 量子蒙特卡洛方向 ALPS:洛桑联邦理工主导开发的多体数值工具集,SSE、QMC、精确对角化一应俱全,老牌但生命力顽强。 QuSpin:基于Python的精确对角化与量子动力学工具,写科研脚本非常顺手,常和QMC做交叉验证。 mVMC / neVMC:日本理研开发的变分蒙特卡洛包,支持神经网络波函数拟设,是"机器学习+QMC"这条热门路线的入门装备。 DiagHam:专注分数量子霍尔体系的数值工具,相关方向课题组基本绕不开。 张量网络方向 ITensor:C++与Julia双实现的张量网络库,DMRG的事实标准之一,接口干净、文档友好。 TenPy:纯Python的DMRG与张量网络包,适合快速验证想法,教学与科研两用。 Quimb:基于NumPy/SciPy生态的张量网络库,收缩路径优化做得出色,做PEPS收缩很趁手。 NetKet:基于JAX的机器学习与变分蒙特卡洛框架,GPU加速友好,适合神经网络量子态研究。 GPU化是一个明确的趋势 值得专门提一句:上面这些工具里,NetKet和mVMC系天然拥抱GPU,ph-AFQMC的GPU加速在2025年也已被系统验证。QMC+GPU、张量收缩+GPU的组合,正在把"单机能算的体系规模"整体往上抬。如果你打算让工作站服役五年以上,配置时给GPU留足余量是清醒的决策。 该配一台什么样的机器 前面从算法聊到硬件,原理部分差不多了,但算力需求最终要落到"这台机器能不能把活干完"上。QMC要并行、张量网络要带宽和内存、大模型要显存,三套需求叠在一台机器上,配置思路就清晰了:大内存打底、核心数管够、配一张能同时喂饱物理计算和本地大模型的GPU。下面是我们按任务规模从低到高整理的几档参考,用越野圈的语言说-- 方案A:城市SUV 适用场景:本科毕设与课程级规模--20个以内自旋的格点模型精确对角化、入门SSE练习、小键维DMRG,以及日常论文研读与14B级本地大模型推理。 推荐机型:A350 153128-MCT CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷 GPU:RTX 5090D v2 24GB+水冷 内存:128GB DDR5 存储:4TB NVME + 8TB SATA 显存:24GB 显存带宽:1.34 TB/s 注:CPU频率为UltraLAB全核超频实测优化频率。 方案B:硬派越野 适用场景:硕士课题常规规模--数百核并行QMC采集中等体系、一维与梯子体系DMRG生产计算、键维数百的张量网络收缩,兼顾14B级大模型本机部署与轻量级LoRA微调。 推荐机型:EX660 227192-MCX CPU:2×Xeon金牌6530(64核,2.7GHz)+工业水冷 GPU:RTX 5060Ti 16G 内存:192GB DDR5 存储:4TB NVME Gen5 显存:16GB 显存带宽:448 GB/s 注:CPU频率为UltraLAB全核超频实测优化频率。 方案C:长途拉力车 适用场景:课题组主力共享机--大规模QMC生产机时、GPU加速QMC与神经网络波函数探索、大内存张量网络计算,32B与70B量化模型的本地推理与知识库问答服务。 推荐机型:EX660 229512-MDT CPU:2×Xeon铂金8592+ (128核,2.9GHz) +工业水冷 GPU:RTX 4090 48G 内存:512GB DDR5 存储:8TB NVME Gen5 显存:48GB 显存带宽:1.01 TB/s 注:CPU频率为UltraLAB全核超频实测优化频率。 方案D:改装赛车 适用场景:平台级基础设施--多课题组共享的蒙特卡洛与多体计算平台,超大键维二维张量网络、多用户并发提交、本地大模型微调与推理一体化,瞄准五年以上的服役周期。 推荐机型:AlphaPro660 241768-MDF CPU:2×AMD霄龙9655(192核,4.1GHz) GPU:RTX Pro 6000 96G 内存:768GB DDR5 系统盘:8TB NVME(14GB/s) 数据盘:20TB SATA 显存:96GB 显存带宽:1.79 TB/s 注:CPU频率为UltraLAB全核超频实测优化频率。 常见FAQ 笔记本加外置显卡能跑QMC吗 能跑,但只能跑演示。笔记本的持续功耗释放撑不起全核满载数天的QMC生产任务,散热降频会让你的误差统计失真。外置显卡方案则把内存带宽这个QMC的命门卡死在接口上。学习和调试可以,产出数据不行。 QMC和张量网络,哪个更吃CPU核心数 QMC更吃。它是天然并行的独立马尔可夫链,核心数几乎线性折算成采样吞吐量。张量网络尤其是DMRG,是带宽受限的串行迭代,高频、大缓存、满通道内存比堆弱核有效得多。买机器前先想清楚自己主攻哪条路。 内存多少才算够 做一维DMRG,128GB很从容;做二维张量网络,256GB起步,384GB到512GB才敢说"键维管够";如果还想在本机开大模型、跑多用户共享,直接按512GB规划。内存是这个方向最不该省的钱。 双精度性能重要吗 非常重要。张量网络的SVD和QMC的统计求和都以FP64为主,选购GPU时关注它的双精度吞吐,而不是只看游戏显卡宣传里的AI算力数字。 大模型部署和物理计算会抢资源吗 不会根本冲突。物理计算是长任务批处理,大模型推理是短时交互,两者错峰使用。真要多用户并发,把模型服务和计算队列分别绑定到不同核心与显存分区即可,现代调度工具都能做到。 自己攒机是不是更划算 账面上便宜,总成本上常常更贵。QMC机时是按周计的,一次兼容性翻车或静默错误浪费的机时就把差价吃回去,还没算售后和备件周期。课题组第一台机器,建议交给经过满载验证的品牌整机。 结语 从游戏PC到科学计算工作站,差别从来不在配置单的高低--两类机器从设计目标开始就是两个物种:一个为峰值帧率优化,一个为持续吞吐量、内存容量和长期稳定服役优化。量子多体计算这条路上,张量网络负责"寻参",QMC负责"验证",实验负责"拍板",而工作站负责让前三者不必为机时发愁。再配上一台能读懂论文、会修代码的本地大模型,一个计算物理工作者的完整生产力闭环,就在你桌上那台安静的塔式机箱里了。 UltraLAB专业图形工作站定制 关于 UltraLAB:UltraLAB(西安坤隆计算机科技有限公司)是国内知名高端定制图形工作站厂家,面向光学设计、计算光学、光子学、人工智能等领域提供"工具链→算法路径→硬件"精准匹配的专业计算平台,支持预装开源软件栈与多机集群交付。 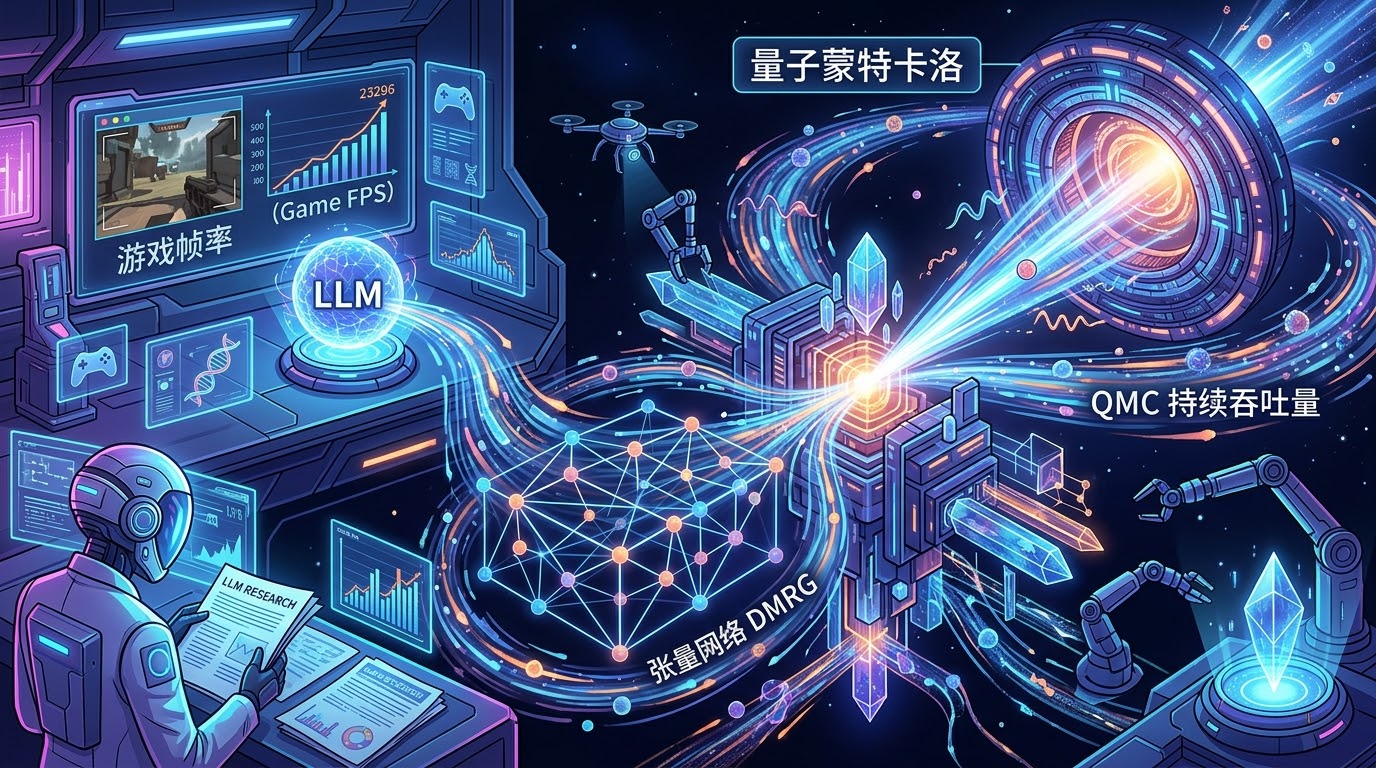 |
 回复此楼
» 猜你喜欢
 40+中年人失业后,还能找到好工作吗?
已经有15人回复
-
二审4个多月了还是Awaiting Reviewer Scores
已经有5人回复
-
申请科研项目纯靠实力能成功吗?
已经有12人回复
-
用NBS溴化时溶剂除了CCl4外还有什么
已经有6人回复
-
极限拉扯,如何抉择
已经有15人回复
-
OpenAI又攻克数学难题了,离AI做有机合成还有多远?
已经有13人回复
-
课题组会帮你通过考核么?
已经有7人回复
-
招收博士生一名
已经有3人回复
» 本主题相关商家推荐: (我也要在这里推广)
简单回复
2026-10-16 16:49
回复
peterfxmc(金币+1): 谢谢参与

2026-10-16 19:15
回复
peterfxmc(金币+1): 谢谢参与
tfang4楼
2026-10-16 22:32
回复
peterfxmc(金币+1): 谢谢参与