| 查看: 59 | 回复: 0 | |||
[交流]
Nature|Geneformer:迁移学习如何让基因网络预测成为可能
|

|
▍导读 2023年,Dana-Farber 癌症研究所与 Broad Institute 等团队在 Nature发表 Geneformer,一个上下文感知、基于注意力的深度学习模型。它在Genecorpus-30M 约 2990 万人类单细胞转录组上自监督预训练,以 rank value 编码表示每个细胞转录组,并把网络层级编码进注意力权重。仅用少量任务数据微调,模型在基因剂量敏感性(AUC 0.91)、染色质动态(AUC 0.93/0.88)与网络层级(AUC 0.81)等预测上提升;在心肌病建模中筛出的靶点 GSN、PLN 经 CRISPR 验证改善心肌微组织收缩张力,为数据受限场景的靶点发现提供可迁移的通用表征。 ▍研究背景 解析驱动疾病的基因调控网络,有助于筛选纠正核心调控元件、而非仅作用于外围下游效应分子的药物;但刻画网络结构需要大量转录组数据来学习基因之间的连接。 在罕见病、以及病灶组织在临床难以获取的疾病中,数据尤其稀缺,这成为网络校正类药物发现的主要阻碍。近年测序技术发展带来人体组织转录组数据的快速增长,单细胞技术又避免了把多细胞基因表达平均化,为推断更精细的网络互作提供了条件。 与此同时,自然语言理解与计算机视觉中的迁移学习显示:在大规模通用数据上预训练的深度模型,可在任务数据有限时通过微调迁移到多种下游任务;基因调控网络高度依赖细胞上下文,而基于注意力的 Transformer 天然适合这种上下文相关的建模。 ▍研究方法 研究以「大规模自监督预训练+少量任务数据微调」为核心,构建面向网络生物学的 Geneformer,并从多类下游任务系统评估其预测能力: - 预训练语料:组装 Genecorpus-30M,纳入约 2990 万人类单细胞转录组、561 个数据集,排除高突变负荷细胞,仅保留液滴法测序平台以保证表达值可比。 - rank value 编码:以基因在该细胞内的表达、经全语料非零中位表达归一化后按排位编码,压低调低看家基因、突出区分细胞状态的转录因子。 - 模型架构:6 层 Transformer 编码器,输入规模 2048、256 维嵌入、每层 4 个注意力头,采用全密集自注意力。 - 训练与微调:预训练遮蔽 15% 的基因做自监督预测;微调时加载预训练权重并加一层任务层,基因或细胞分类任务统一使用同一套超参数。 - 计算机扰动:以把基因移出编码模拟删除、移编码前端模拟激活,通过细胞与基因嵌入的余弦相似度衡量扰动影响。 ▍核心发现 1 、提出 Geneformer:把迁移学习范式引入网络生物学 研究提出 Geneformer,一个上下文感知、基于注意力的深度学习模型,用迁移学习把大规模转录组数据中习得的知识迁移到数据有限的下游任务。 模型先在大规模预训练语料 Genecorpus-30M 上自监督训练:每个细胞的转录组以 rank value 编码表示,经 6 层 Transformer 编码器处理,遮蔽 15% 的基因并让模型预测被遮蔽位置上的基因。 这一设计使模型能从海量无标注数据中学习网络动态,再以少量任务数据微调,为网络生物学中样本稀缺的场景提供预测能力。(图 1) 全图分三部分:先看 (a) 从大规模自监督预训练到多任务微调的迁移学习流程,再看 (b) Genecorpus-30M 的组织来源分布,最后看 © 单细胞转录组经 rank value 编码进入 6 层 Transformer 编码器(输入规模 2048、256 维嵌入、每层 4 个注意力头),可输出基因嵌入、细胞嵌入、注意力权重与上下文预测。 2、 以极少数据预测基因剂量敏感性,并验证新候选 TEAD4 在转录因子剂量敏感性预测任务上,Geneformer 仅用 1 万个随机单细胞转录组微调,就显著提升了预测能力,AUC 达 0.91。 研究进一步显示,预训练语料越大、越多样,同一少量任务数据下的下游预测力越强,说明预训练本身带来了可迁移的知识。 微调后的模型在无额外训练的情况下预测新报告的一组疾病基因,在胎儿脑细胞情境下与高置信基因集的一致率达 96%;其预测的新候选基因 TEAD4 经 CRISPR 敲除后,心肌微组织的收缩张力显著下降。(图 2) 先看 (a) 转录因子剂量敏感性预测的 ROC 曲线,Geneformer 的 AUC 达 0.91;再看 (b) 预训练语料越大越多样、下游预测越强的趋势;(d) 展示计算机删除疾病相关基因对心肌细胞嵌入的影响,(e) 展示实验敲除 TEAD4 后收缩张力的下降。 3 、从转录组推断染色质动态:二价结构域与调控距离 在染色质动态任务上,Geneformer 用约 1.5 万个胚胎干细胞的转录组微调,即可区分二价修饰(H3K4me3/H3K27me3)基因与无上述组蛋白甲基化标记或仅 H3K4me3 修饰的基因,AUC 分别为 0.93 与 0.88。 该二价修饰预测任务的微调仅使用基因组中 56 个保守位点的标注基因,但预测可外推到未参与微调的全基因组,与后续全基因组研究结果一致。 模型还能仅凭转录组区分长程与短程调控的转录因子,而对照方法的预测接近随机,显示它能从表达数据中推断更高阶的调控属性。(图 3) 先看 (a)(b) 两条 ROC 曲线:区分二价修饰与无相应组蛋白甲基化标记、与仅 H3K4me3 修饰基因时 Geneformer 的 AUC 分别为 0.93 与 0.88,均高于对照方法;再看 © 仅在 56 个保守位点微调后仍能外推到全基因组的曲线,最后看 (d) 长程与短程转录因子区分中对照方法的曲线接近随机。 4 、编码基因网络层级:区分核心与外围调控因子 在基因网络层级任务上,Geneformer 仅用约 3 万个正常内皮细胞的转录组微调,区分 NOTCH1(N1)依赖网络中核心与外围因子的 AUC 达 0.81。 微调数据减少至 5 千个内皮细胞时,AUC 仍为 0.80;另用 884 个更相关的健康或扩张主动脉内皮细胞微调,AUC 为 0.74,超过对照方法用约 3 万细胞的水平。 对预训练注意力权重的分析显示,20% 的注意力头以完全自监督方式显著关注转录因子,且早期层关注的基因更分散、后层更集中于定义细胞状态的高排位基因。(图 4) (a) 区分 N1 网络核心与外围基因,(b) 区分 N1 激活的靶基因与非靶基因,AUC 均为 0.81;© 减少至 5 千个细胞时 AUC 为 0.80,进一步减少至 1 千个时降至 0.59;(d) 用 884 个更相关的主动脉内皮细胞微调,AUC 为 0.74,超过用约 3 万细胞训练的对照方法;(e) 展示注意力头对转录因子的显著偏好。 5、 用计算机删除还原基因网络连接 研究者设计计算机删除方法:把某个基因从细胞的 rank value 编码中移除,再量化其余基因嵌入受到的影响。 在胎儿心肌细胞中删除 GATA4,其影响显著集中在 ChIP-seq 定义的直接靶基因上,而非间接靶点;删除 TBX5 也呈现同样模式(扩展数据图 9f)。 同时删除 GATA4 与 TBX5 对其共结合靶点的影响超过二者单独效应之和,提示模型捕捉到了两个转录因子在这些靶点上的协同作用。(图 5) 先看 (a) 箱线图:GATA4 计算机删除对直接靶点的影响显著高于管家基因、NOTCH1 靶点、NKX2-5 靶点与间接靶点;再看 (b) 小提琴图:单独删除 GATA4 或 TBX5 对共结合靶点的影响均高于管家基因,联合删除的效应超过二者单独效应之和。 6 、计算机治疗筛选出候选治疗靶点并获实验验证 在人类疾病建模中,Geneformer 用有限患者样本微调,区分非衰竭心脏与肥厚型、扩张型心肌病心肌细胞,出样本准确率达 90%。 通过计算机删除基因,模型分别识别出 447 个与 478 个基因,其缺失被预测会使非衰竭心肌细胞嵌入向肥厚型与扩张型心肌病状态偏移。 反向的计算机治疗分析给出候选靶点;在携带 TTN 截短突变的 iPSC 心肌微组织中,CRISPR 敲除模型预测的 GSN 与 PLN 显著改善了收缩张力,为该方法的实用性提供了实验支持。(图 6) 先看 (a) 的示意图:先固定各细胞状态的嵌入位置,再通过计算机删除或激活基因、观察嵌入是否向疾病态或健康态偏移;然后看 (b) 出样本预测的三个指标(准确率 90%、精确率 82%、召回率 87%),再看 (e) 候选靶点引起的平均嵌入偏移分布,最后看 (f)(g) 箱线图中 TTN 突变微组织收缩力低于野生型、以及敲除 GSN/PLN 后收缩张力回升。 ▍核心结论速览 - Geneformer 在约 2990 万单细胞转录组上自监督预训练。 - 以 rank value 编码与 6 层 Transformer 保留基因级上下文。 - 仅用少量任务数据微调即可显著提升多类预测。 - 计算机删除可还原转录因子与其靶基因的网络连接。 - 在心肌病建模中筛出靶点,GSN、PLN 获实验验证。 ▍研究意义 科学价值:把迁移学习范式引入网络生物学,用大规模无标注转录组预训练、以少量任务数据微调,统一支撑剂量敏感性、染色质动态与网络层级等多类预测,并把网络层级直接编码进注意力权重。 临床价值:在患者样本有限的心肌病建模中,模型可预测候选治疗靶点,并经 iPSC 疾病模型的 CRISPR 验证改善收缩功能,为难治或病灶组织在临床难以获取的疾病提供可行的靶点发现路径。 ▍局限与下一步方向 作者指出若干局限:基于排序的 rank value 编码没有充分利用转录计数中的精确表达测量;预训练语料仅纳入液滴法测序平台以保证表达值可比;所有微调任务统一使用同一套超参数、未逐任务调参,因此 Geneformer 在下游任务中的最大预测潜力可能被低估。此外,新候选基因 TEAD4 在心脏发育中的具体作用仍待进一步研究。 ▍FAQ Q:Geneformer 与以往单细胞模型有何不同? 以往方法往往为每个组织或任务从头训练模型,只能利用该任务少量标注数据;Geneformer 先在海量无标注单细胞转录组上自监督预训练,再以少量任务数据微调,把通用知识迁移到多种下游任务。 Q:什么是 rank value 编码,为什么要用它? 它把每个细胞内的基因按表达排位表示,排位经全语料非零中位表达归一化。这样可压低调低广泛高表达的看家基因,突出虽表达低但能区分细胞状态的转录因子,并且对绝对计数受技术偏差影响更稳健。 Q:为什么 Geneformer 只需很少的数据就能做预测? 关键的通用知识已在约 2990 万细胞的预训练阶段习得,微调只是把这份知识对齐到具体任务。因此即使把微调数据减到数千、甚至 884 个更相关的细胞,仍能保持较好性能。 Q:模型预测的治疗靶点可靠吗? 在扩张型心肌病中,模型预测的 GSN 与 PLN 经 CRISPR 敲除后,显著改善了携带 TTN 截短突变的心肌微组织收缩张力,作者据此认为这为 Geneformer 作为靶点发现工具提供了实验支持。 ▍君录视角 · 虚拟细胞 解决的问题:基因调控网络的刻画高度依赖大量转录组数据,在罕见病、病灶组织在临床难以获取等样本有限的场景下难以展开,而传统做法往往需要为每个任务从头训练模型。Geneformer 把大规模无标注单细胞转录组上的自监督预训练与少量任务数据微调结合起来,让基因剂量敏感性、染色质动态、网络层级等预测在数据受限时仍可获得,并用计算机删除给出基因网络的连接线索与候选治疗靶点。 集成判断:模型的关键增量在于把每个细胞的转录组表示为按表达排序的 rank value 编码,交由 6 层 Transformer 以全密集注意力处理,使网络层级被自然编码进注意力权重;这一「大规模预训练+少量微调」的骨架可复用于注释之外的多种下游任务,构成虚拟细胞方向可插拔的表征与扰动推演层。 ▍原文信息 Theodoris CV, Xiao L, Chopra A, et al. Transfer learning enables predictions in network biology. Nature. 2023;618(7965):616–624. doi:10.1038/s41586-023-06139-9 ▍关于我们 君录生物 · 以数据驱动创新药早期开发 自建心血管专病数据基座+分析平台 做靶点发现与药物管线早期资产 合作 · 投资 · 学术交流:留言「合作」。 本文由AI辅助生成,内容基于已公开发表的学术论文进行科学讨论,不涉及任何未披露的产品信息、临床试验数据或公司管线进展;仅用于生物医药科普及行业学习,不构成医学建议、用药建议或投资建议。如需引用,请参阅原文。转载请注明出处。AI生成内容仅供参考,不构成任何专业建议或决策依据,最终解释权归君录生物所有。 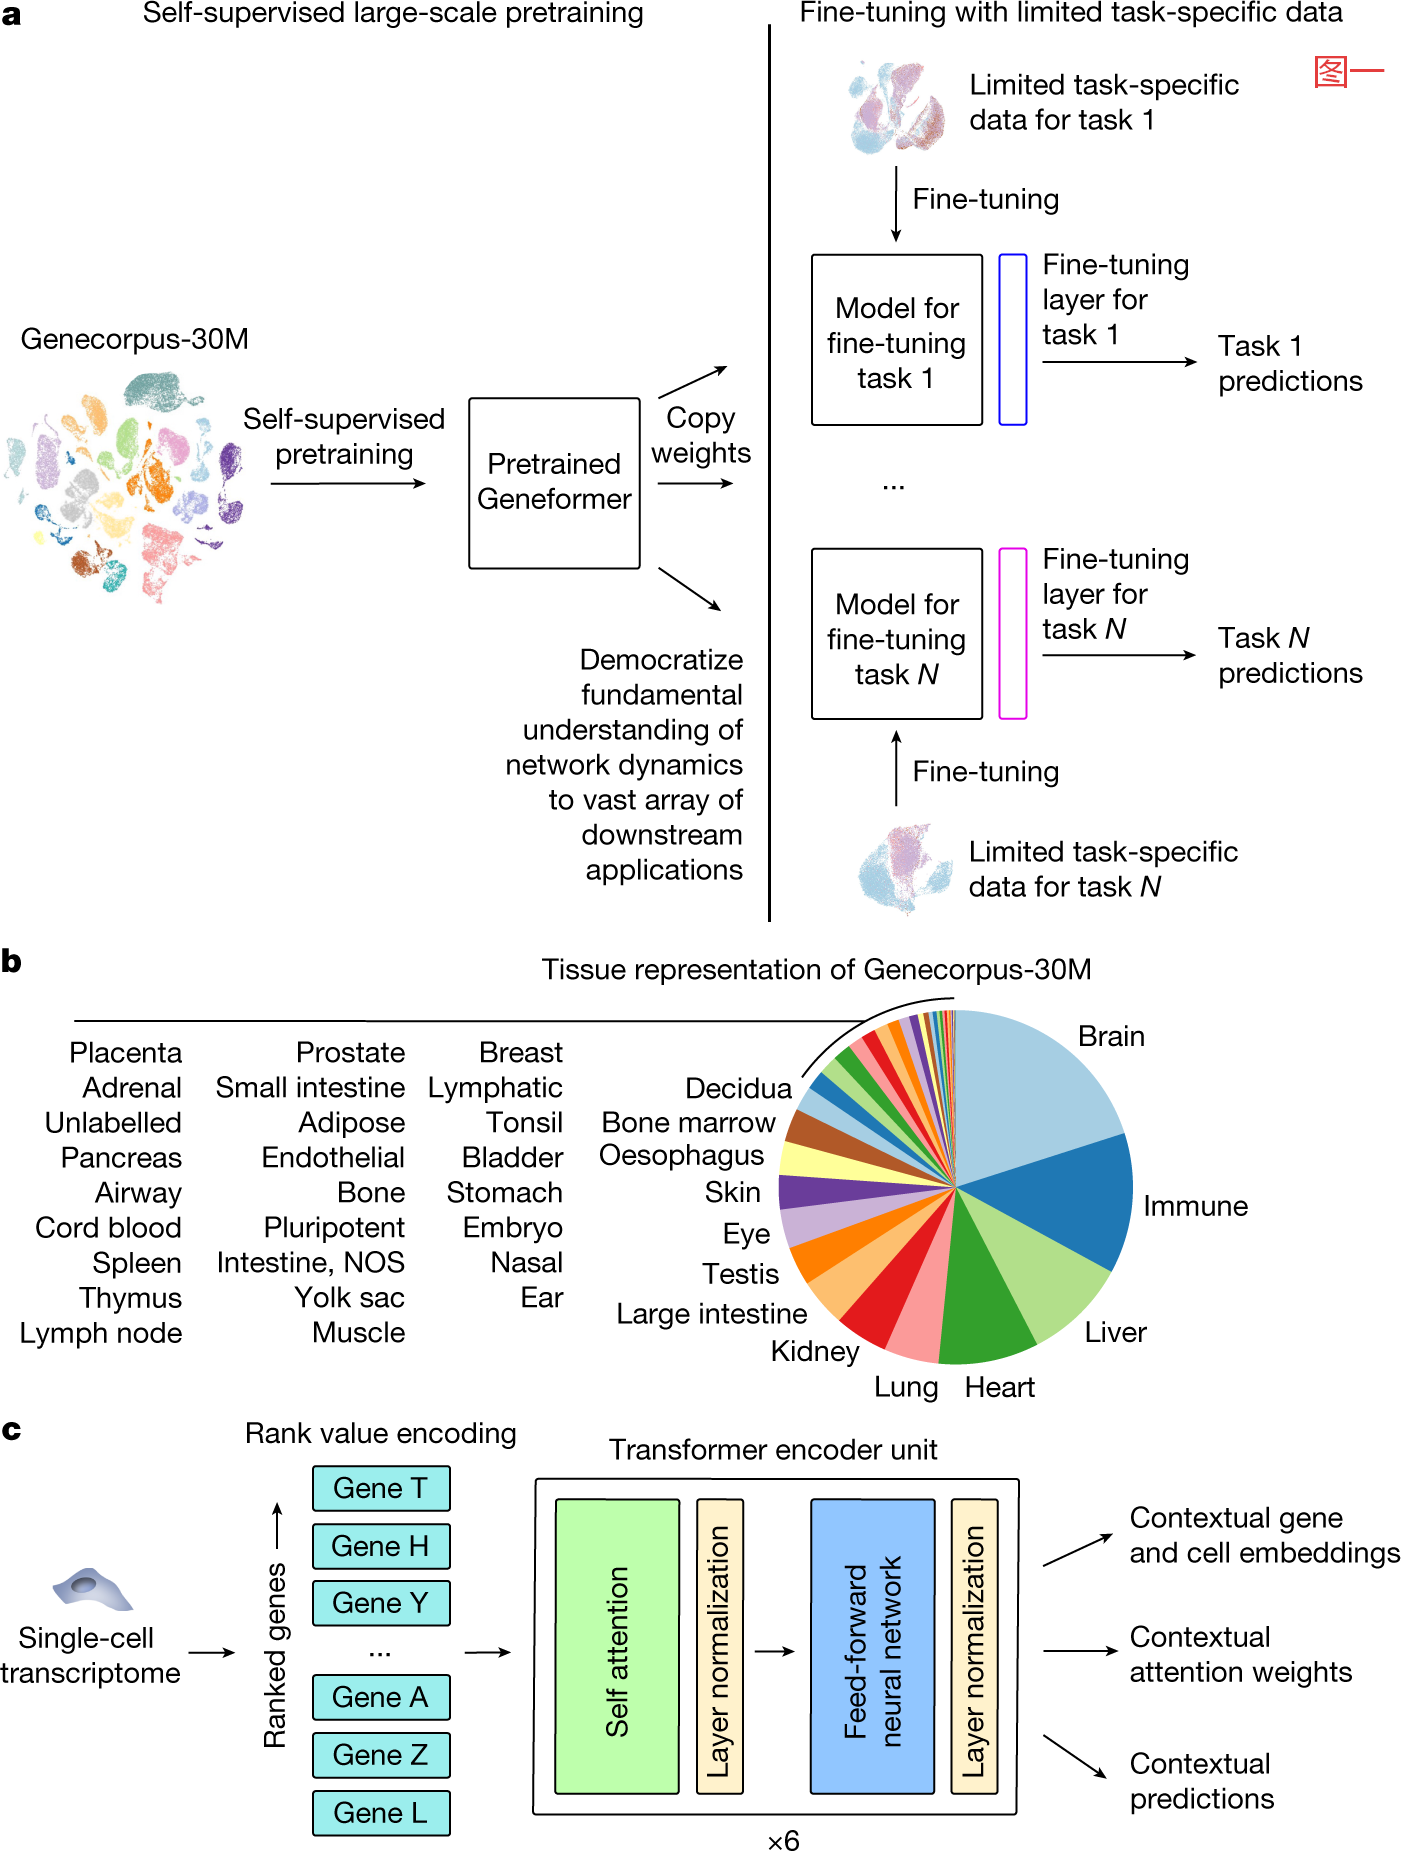 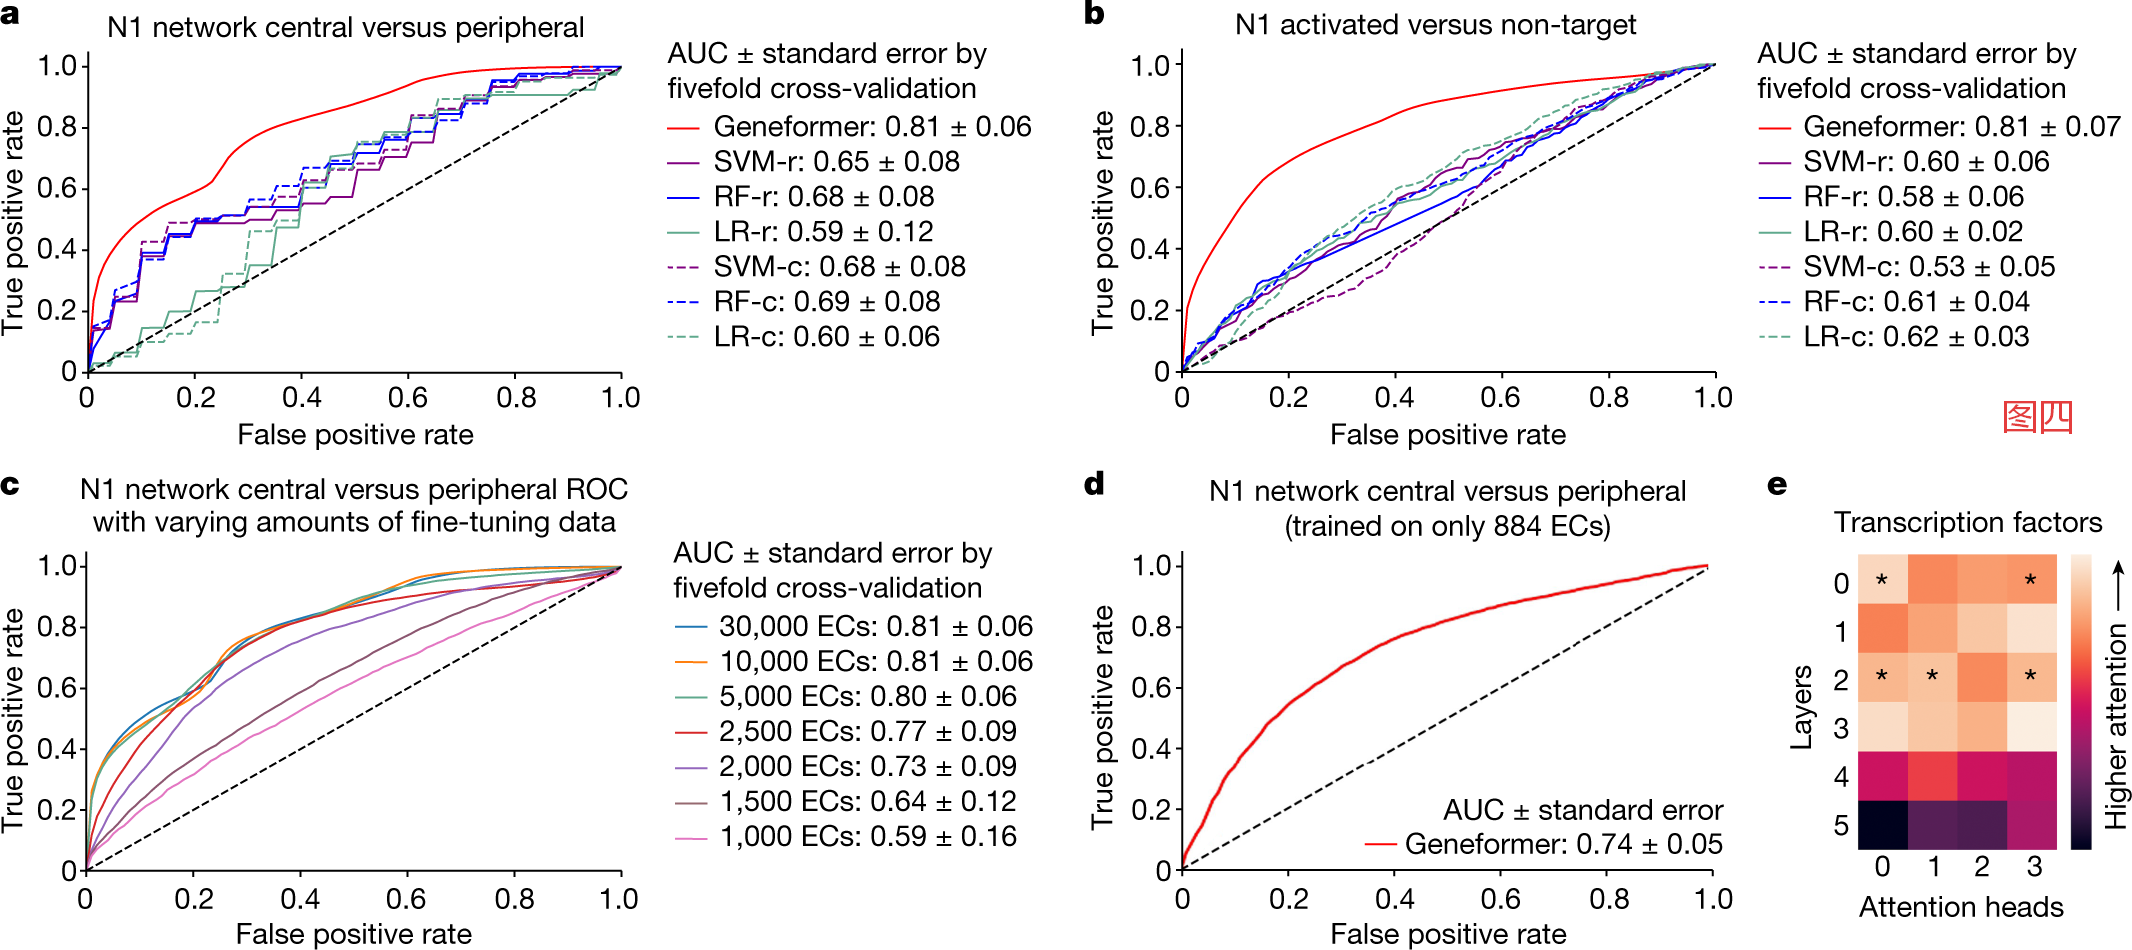 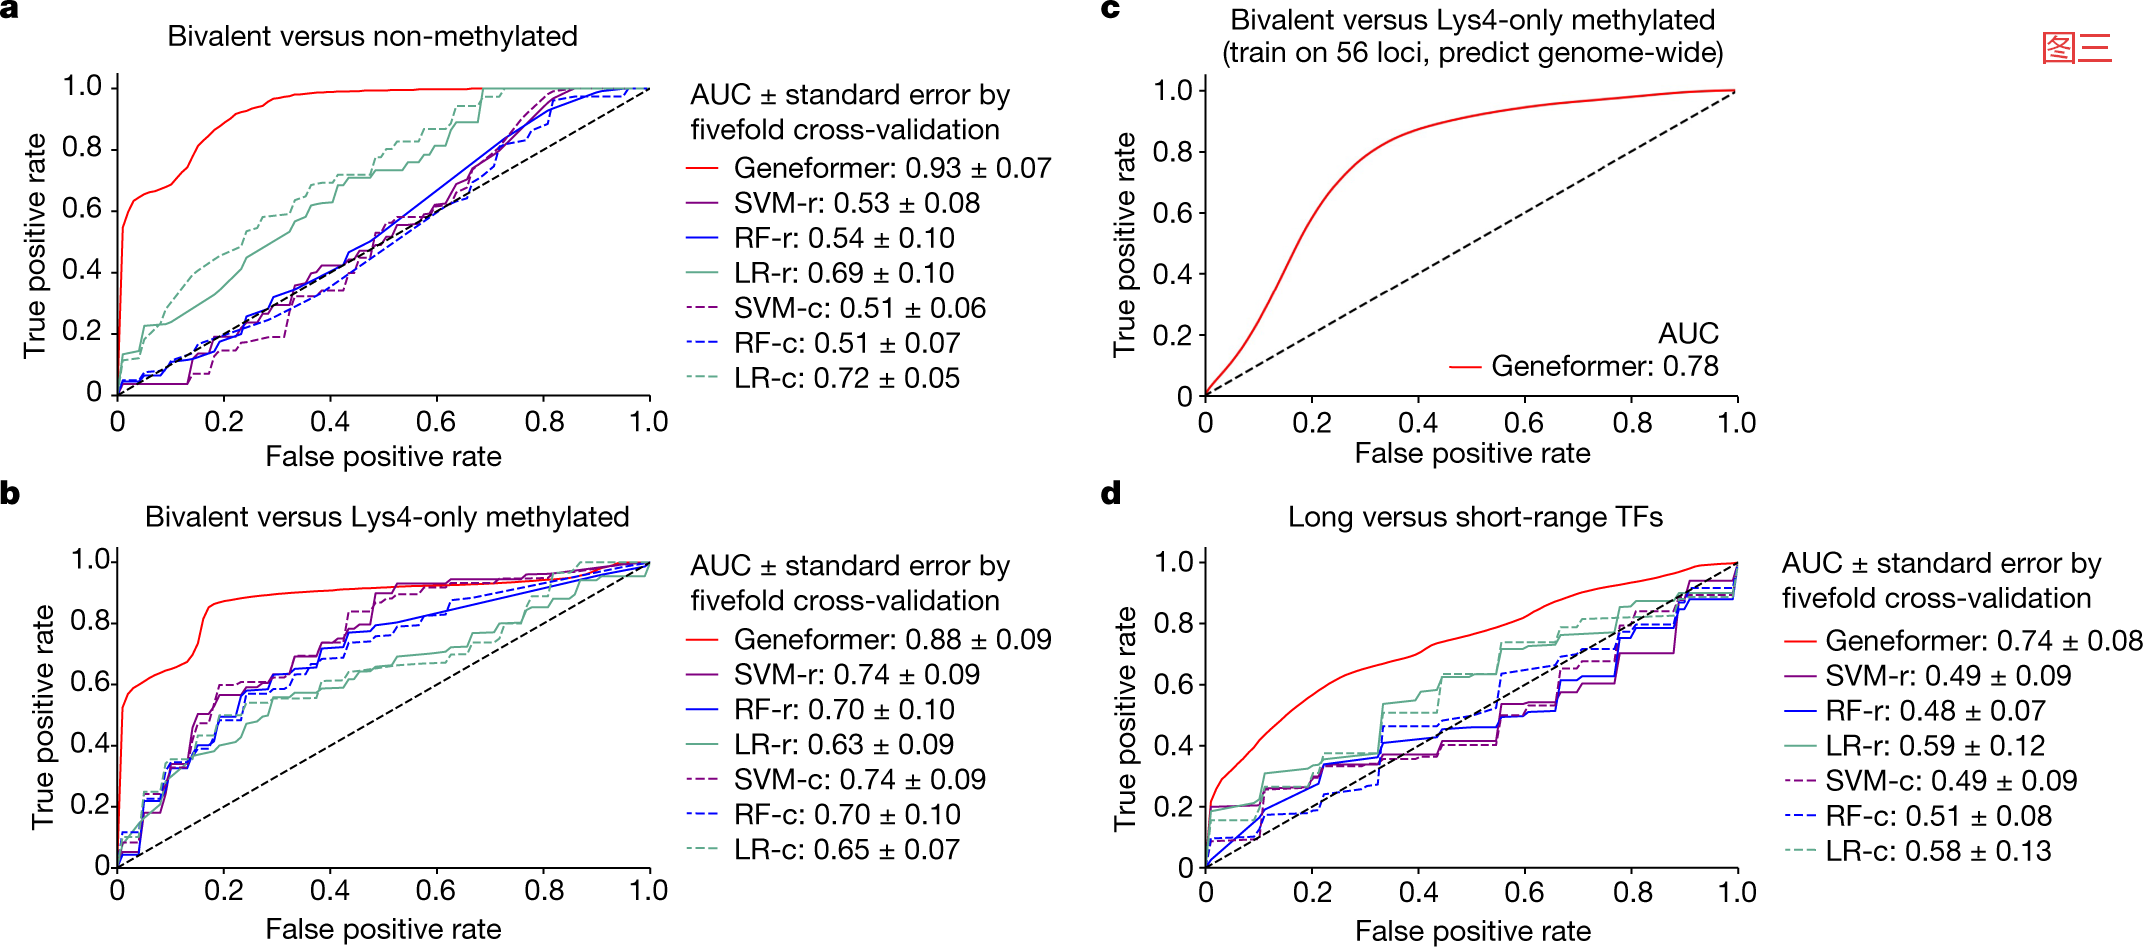 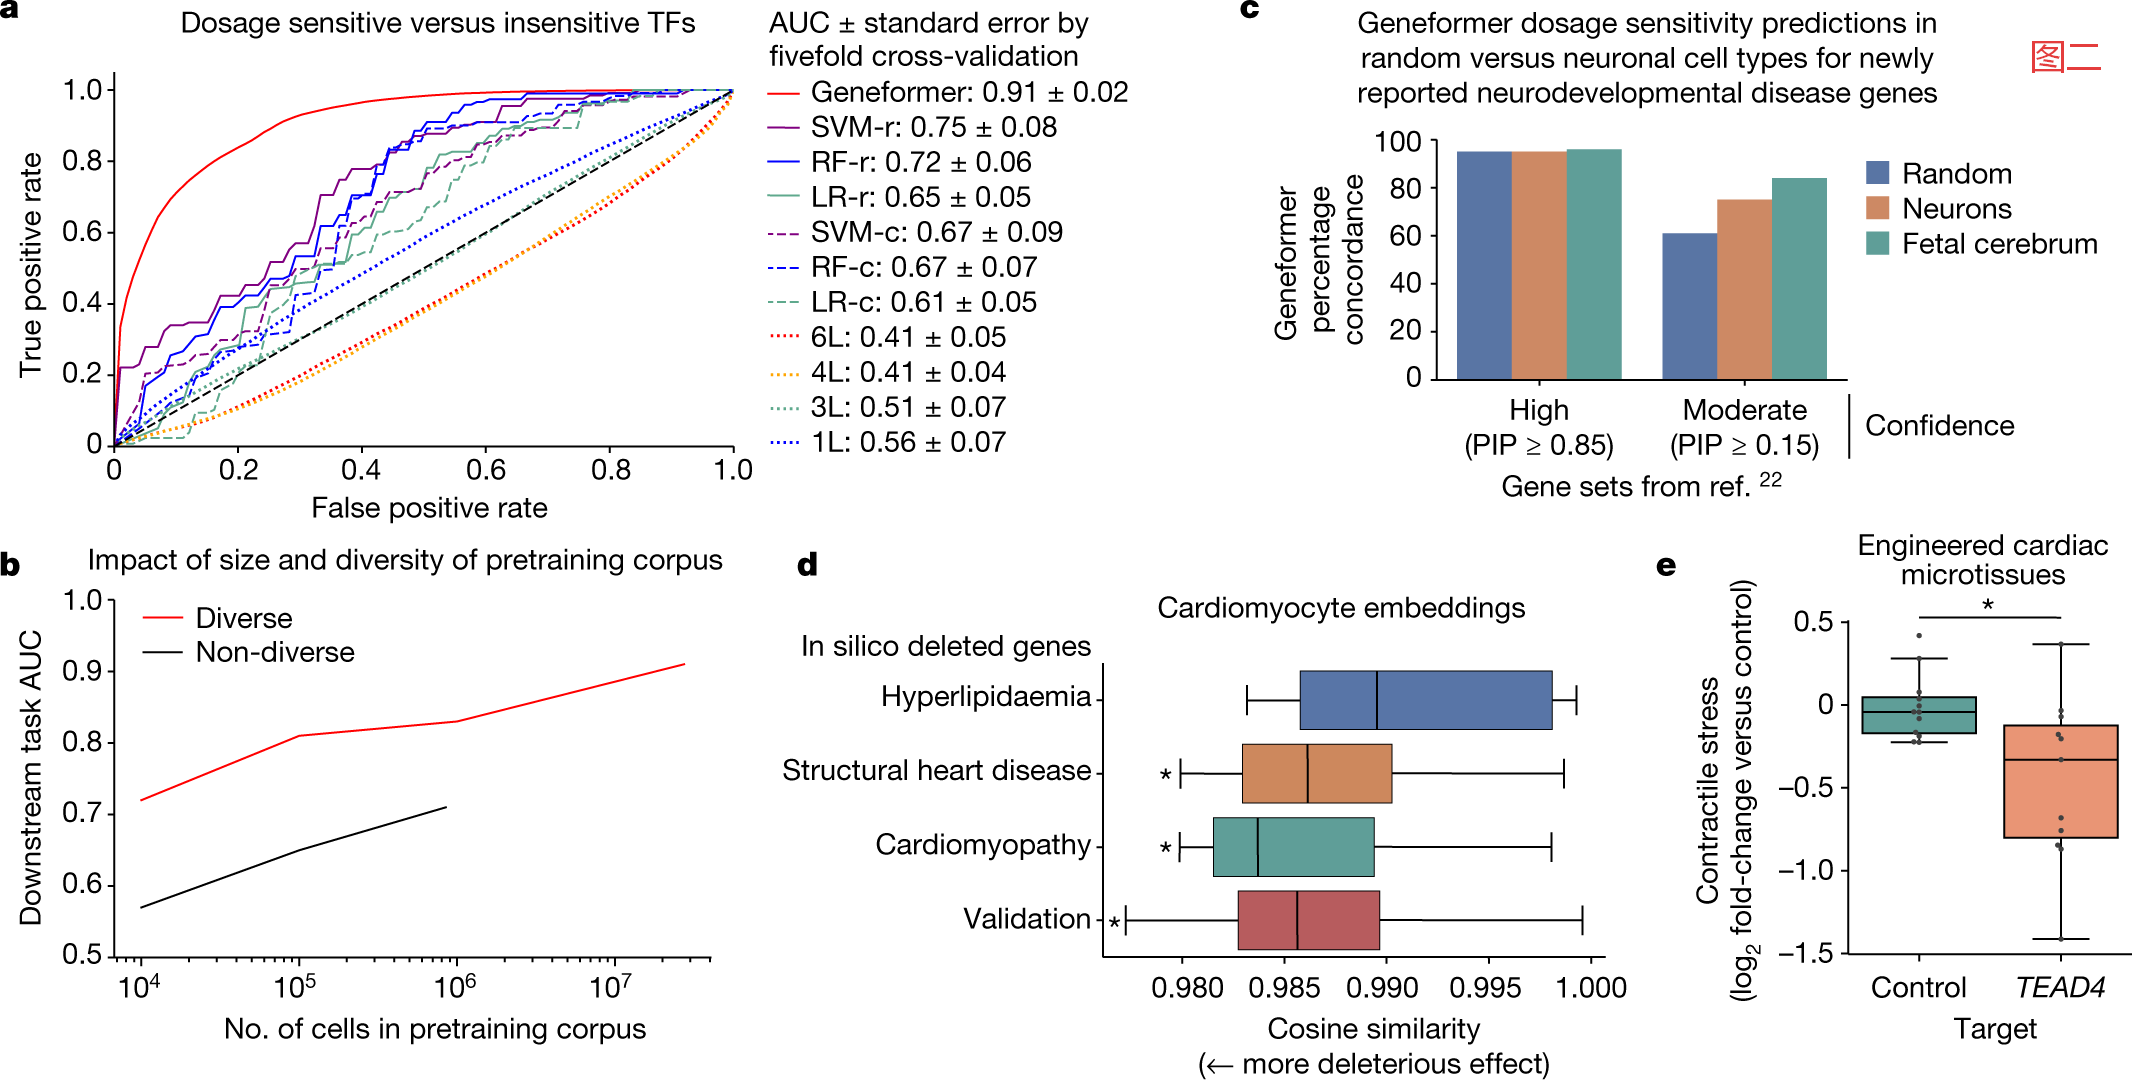  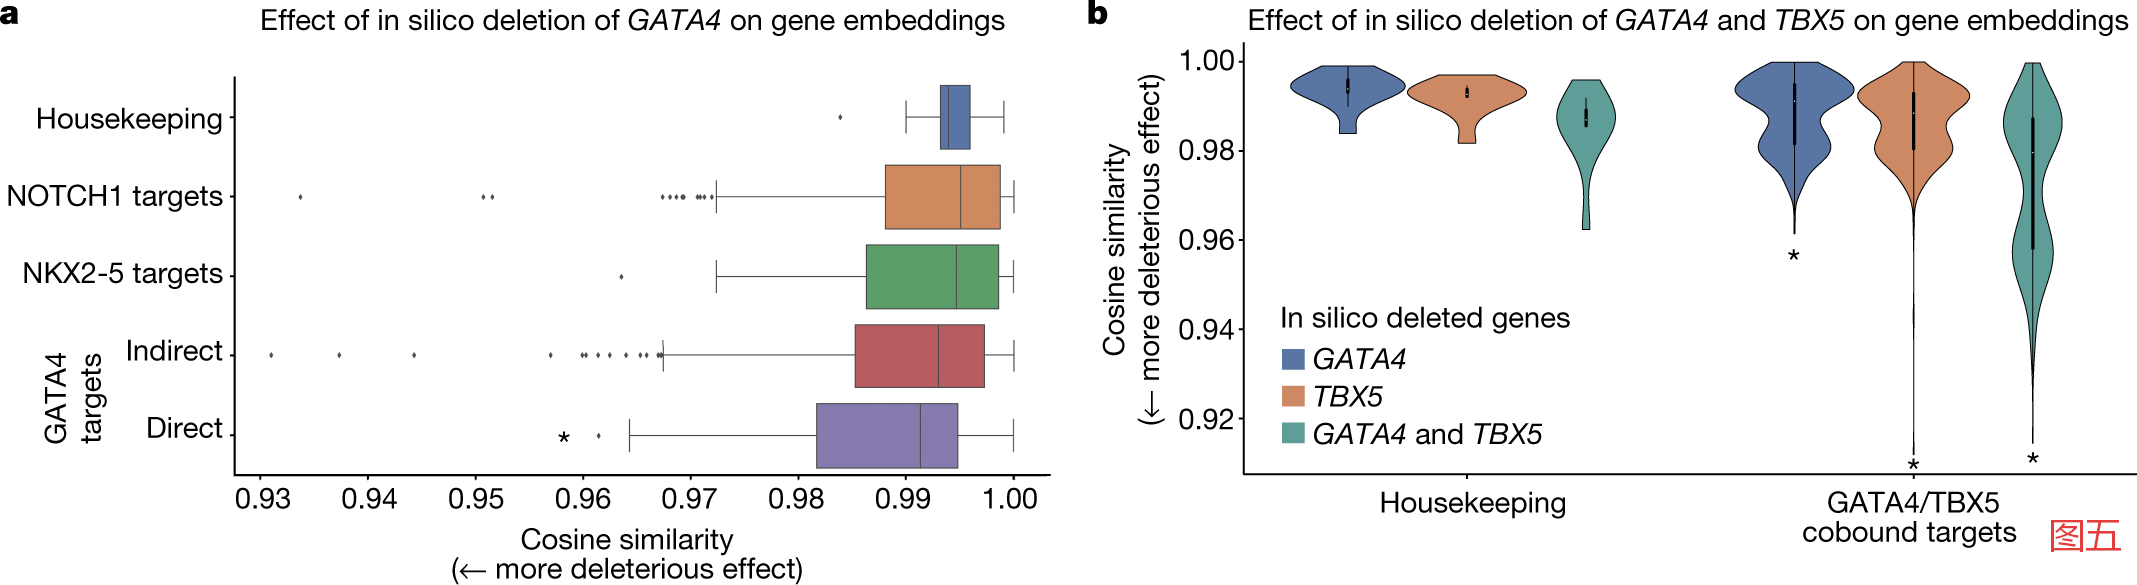 |
 回复此楼
» 猜你喜欢
 40+中年人失业后,还能找到好工作吗?
已经有15人回复
-
二审4个多月了还是Awaiting Reviewer Scores
已经有5人回复
-
申请科研项目纯靠实力能成功吗?
已经有12人回复
-
用NBS溴化时溶剂除了CCl4外还有什么
已经有6人回复
-
极限拉扯,如何抉择
已经有15人回复
-
OpenAI又攻克数学难题了,离AI做有机合成还有多远?
已经有13人回复
-
课题组会帮你通过考核么?
已经有7人回复
-
招收博士生一名
已经有3人回复
» 本主题相关商家推荐: (我也要在这里推广)