









| 查看: 50 | 回复: 0 | |||
[交流]
Nature|VirTues:跨队列跨平台的空间蛋白组通用基础模型
|

|
▍导读 2026年,瑞士洛桑联邦理工学院(epfl)charlotte bunne 团队联合苏黎世联邦理工、日内瓦大学等在 nature发表 virtues(virtual tissues),一个面向空间蛋白组学的通用基础模型。它把每个标志物的蛋白序列经 esm-2 蛋白语言模型 嵌入为「标志物 token」,与图像 token 融合,并用因子化的标志物注意力与空间注意力 替代全注意力,从而能处理数十至上百通道的多重成像。模型在 15 个 imc 队列(3,102 例患者、146 个标志物)上自监督预训练,并扩展至 4 种成像技术、32 个队列、逾 5,100 例患者与 239 个标志物。单一骨干即可完成标志物重建、细胞分割与分型、生态位注释、组织级诊断与患者分层,并支持跨异质面板的零样本注释;在三阴性乳腺癌中,其衍生的空间标志物预测抗 pd-l1 化疗免疫治疗反应,并在独立队列中分层无病生存,优于同数据集来源的最优标志物与现行临床分层方案。 ▍研究背景 肿瘤组织在患者、疾病分期乃至瘤内都存在显著异质性,其多样细胞表型、状态与空间排布共同决定治疗反应;肿瘤微环境的空间组织与功能因此成为癌症治疗关注的核心。 刻画这种组织需要超越传统方法的分子成像。空间蛋白组技术(如多重免疫荧光、成像质谱 imc)可在亚细胞分辨率下同时测量数十至数百种蛋白,揭示肿瘤—免疫互作、预后相关的空间生态位与耐药机制。 但让这些检测强大的灵活性也割裂了领域:每个研究使用定制的抗体面板、流程与平台,数据集在标志物种类与数量、动态范围与噪声上各不相同。为单一检测搭建的流程难以跨队列或跨平台迁移知识、复用注释参考,或建立可泛化的标志物;实现统一图谱需要一种能把异质队列、面板与技术联合分析的协调表示,而传统编码器假定固定面板、无法关联未参与训练的标记物。 ▍研究方法 研究以「蛋白语言模型嵌入+因子化注意力+自监督掩码重构」构建 virtues,并在多尺度、多队列、多平台上系统评估其表示与应用: - 数据语料:核心为 15 个 imc 队列(3,102 例患者、146 个标志物、8,887 张图像),并扩展为覆盖 imc、codex、orion、mibi 四种成像技术的 32 个队列,逾 5,100 例患者与 239 个标志物。 - 标志物感知 token 化:每个通道按 8×8 像素切块(约含一个细胞),每个标志物经 esm-2 蛋白语言模型得到序列嵌入,与图像 token 线性投影后相加融合,使模型带上蛋白序列层面的生物学先验。 - 因子化注意力:编码器为 16 层 transformer,交替使用「标志物注意力」(仅同一空间位置的不同标志物相互注意)与「空间注意力」(仅同一标志物内不同位置相互注意),把全注意力的二次复杂度拆解,可扩展到高维多重数据。 - 自监督掩码重构:以掩码自编码器框架训练,按通道随机遮蔽 60%╟100% 的 token,解码器逐通道重构像素强度,以均方误差为损失;训练时随机丢弃 0╟25% 的通道,以增强对未见标志物与数据集的泛化。 - 多尺度读出:patch 级表示经聚合得到 cell、niche、tissue 三级 summary token;组织级监督任务用注意力深度多示例学习(abmil)加权聚合,检索类无监督任务则用简单平均。 - 评估设计:跨队列分割与细胞分型均采用留一队列的零样本设置,并与 cellpose、instanseg、stardist 及 kronos、ca-mae、resnet 等基线对比。 ▍核心发现 1、提出 virtues:用蛋白序列嵌入与因子化注意力统一空间蛋白组 研究提出 virtues,一个面向空间蛋白组学的通用基础模型:它直接从多重成像数据中学习「标志物感知、多尺度」的表示,覆盖蛋白、细胞、生态位与组织四个层级。 关键设计有两处。其一,把每个标志物经蛋白语言模型(esm-2)得到的序列嵌入作为「标志物 token」,与相应图像 token 融合,从而能关联训练中从未见过的标记物;其二,把 transformer 的注意力拆成「标志物注意力」与「空间注意力」,分别刻画标志物间关系与组织内空间格局,使计算量不再随通道数二次膨胀。 由此,单一骨干即可复用于标志物重建、细胞分割与分型、生态位注释、组织级诊断与患者分层等任务,并在训练集之外的数据集与面板上实现零样本迁移。(图 1) 图 1 |《virtues 平台总览:架构、数据规模与计算—性能标度》 · 来源:wenckstern et al., 2026, nature | 模型架构与数据总览图 先看 (d) 多重图像经切块、与标志物 token 融合后进入编码器,再聚合为 cell、niche、tissue 三级 summary token;再看 (b)(c) 15 个 imc 队列覆盖 8 个器官、146 个标志物,共 8,887 张图像、3,102 例患者;最后看 (e) 随标志物数量增加,virtues 的推理计算成本增长远低于 ca-mae,而细胞分型性能持续上升。 2、遮蔽重构验证模型对分子与空间结构的理解 研究用三种由易到难的遮蔽策略检验 virtues 对组织结构的理解:独立遮蔽(逐标志物随机遮蔽)、标志物遮蔽(整条通道被隐藏)与生态位遮蔽(所有标志物在若干空间位置同时被遮蔽)。 在独立遮蔽下,重构与真值的平均 pearson 相关达 0.800±0.130,远高于均值强度基线;整通道遮蔽下为 0.700±0.173,超过「最相关标志物」基线;生态位遮蔽下仍达 0.668±0.132,说明模型捕捉的是全局组织结构而非局部像素。 在一个完全留出的肺癌数据集上,virtues 对训练中见过的标志物(如 cd14)与从未见过的标志物(如 cd63)都能给出准确重构;分析显示,当新标志物在预训练蛋白表示空间中存在近邻时,零样本重构更易成功。(图 2) 图 2 |《三种遮蔽策略下的组织与标志物重构》 · 来源:wenckstern et al., 2026, nature | 重构对比与相关性统计图 先看 (a╟c) 三种遮蔽示意与重构示例:独立遮蔽、整通道标志物遮蔽、整块生态位遮蔽下,预测图与原始图在空间分布与强度上高度一致;再看 (d) 各数据集平均 pearson 相关,独立遮蔽约 0.80、标志物遮蔽约 0.70、生态位遮蔽约 0.67,均高于均值或最相关标志物基线;最后看 (e╟h) 零样本场景中已知与新标志物的重构表现差异。 3、单细胞尺度分割与分型,并跨队列零样本迁移 在细胞分型任务上,研究对 virtues 的 cell summary token 做线性探针(逻辑回归),在肺、乳腺与黑色素瘤数据上 macro-f1 一致领先,平均相对提升约 +5.81%(对 kronos)与 +65.79%(对 ca-mae),对极稀有细胞群(如血管、自然杀伤细胞)同样保持增益。 把标注协调后训练的分割模块(搭建在 virtues 的 patch 级表示上)应用到留出队列,可同时预测细胞实例掩膜与语义细胞类型掩膜,在 9 个数据集中的 8 个上超过 cellpose、instanseg 与 stardist;细胞分型也大体优于专用工具 maps 与 astir。 在严格的零样本设置下,逐一把评测队列整体留出,macro-f1 相对域内训练几乎不变(差异 ≤0.03);模型还迁移到训练中未遇到的技术,codex 零样本 macro-f1 达 0.691、orion 达 0.607。(图 3) 图 3 |《virtues 在单细胞尺度分割与注释组织》 · 来源:wenckstern et al., 2026, nature | f1 分数对比与细胞掩膜图 先看 (b) 在肺、乳腺与黑色素瘤数据上各细胞类型的 f1 分数对比;原文报告,virtues 的宏平均 f1 相对 kronos 与 ca-mae 的平均提升分别约为 +5.81% 与 +65.79%;再看 (c) 用全部数据集训练的模型在多数细胞类型上超过仅用单队列训练的模型,稀有免疫细胞提升最大;最后看 (f)(g) 跨队列分割与分型的 f1,以及 (i) 预测细胞类型掩膜与原始图像、cellpose+astir 组合的对照。 4、组织级诊断、微环境风险分层与相似病例检索 在组织层面,研究用注意力深度多示例学习把 patch 表示聚合成患者级预测,在肺癌亚型与分级、乳腺癌 er 状态与分级等诊断任务上表现突出,例如肺癌亚型 macro-f1 达 0.856、分级 0.530。 把 virtues 的细胞表示聚为 120 种表型状态、再拼成患者级组成指纹,可把 er+ metabric 患者分为生存显著不同的高风险与低风险两组:高风险组中,此前已被证实与预后相关的 tme 结构(如抑制性扩张、apc 富集、血管基质)呈现一致的富集或缺失方向。 virtues 的生态位 summary token 还能构成可检索的「虚拟组织数据库」:以最优传输距离度量相似性,在癌症亚型等临床变量的匹配上显著优于随机检索,并能把分子组成与细胞组成相似的档案病例一并召回,为病例式决策支持提供定量框架。(图 4) 图 4 |《virtues 的临床应用:风险分层、诊断预测与相似病例检索》 · 来源:wenckstern et al., 2026, nature | 生存曲线与检索示意组合图 先看 (c) kaplan╟meier 曲线:基于 virtues 指纹把 er+ metabric 患者分为高风险(n=265,21 年内 99 例死亡)与低风险(n=276,58 例死亡)两组,组间生存差异显著;再看 (d) 高风险组中各 tme 结构的风险比,血管基质在高风险组中相对缺乏(结构出现的风险比为 0.399),抑制性扩张与 apc 富集被明显富集(4.464、5.636);最后看 (f) 组织级预测 f1 与 (g╟k) 相似病例检索的结果。 5、从表示中挖掘治疗反应与生存预测的新标志物 在 neotrip 三阴性乳腺癌队列中,virtues 的嵌入能捕捉治疗前后明显的位移,反应者的组织重塑程度显著大于非反应者,而原始平均标志物强度无法区分二者。 研究用「先无监督、后有监督」的流程从治疗前活检挖掘特征:先嵌入所有细胞,再以多分辨率 leiden 聚类得到表型分区,按患者聚合为频率,并用交叉验证模型为每个聚类打分,最终保留两个反应特征与两个非反应特征,各自 auroc 为 0.783、0.707、0.599 与 0.577。 四者组合而成的 virtues 标志物交叉验证 auroc 达 0.823,超过既往空间预测器与经典免疫比例基线;迁移到未参与发现与预训练的独立队列后,特征分别定位于免疫浸润区与免疫排斥区,并据此把患者分为三个生存组(kaplan╟meier p=0.0037),一致性指数 0.628 高于既有分层体系。(图 5) 图 5 |《virtues 衍生标志物用于治疗反应与生存预测》 · 来源:wenckstern et al., 2026, nature | umap、auroc 与生存曲线组合图 先看 (b) 治疗前后各阶段在虚拟组织空间中的位移:反应者的组织重塑幅度远大于非反应者,而原始标志物强度无法分辨二者;再看 (e) 交叉验证 auroc,四个特征组合的 virtues 标志物达 0.823,超过既往空间预测器与免疫比例基线;最后看 (j)(k) 特征迁移到独立队列后,患者被分为生存明显不同的三组,一致性指数 0.628 高于既有分层体系。 ▍核心结论速览 - virtues 是面向空间蛋白组学的通用基础模型。 - 以蛋白序列嵌入标记标志物,用因子化注意力扩展通道数。 - 15 个 imc 队列自监督预训练,扩展至四种成像技术。 - 单一骨干覆盖分割、分型、诊断、分层与病例检索。 - 三阴性乳腺癌标志物 auroc 达 0.823,并在独立队列分层生存。 ▍研究意义 科学价值 :以蛋白序列嵌入与因子化注意力把异质标志物面板映射到共享的「虚拟组织」空间,使标志物重建、细胞分割与分型、生态位注释与组织级预测共用一个表征,为空间蛋白组从孤立研究走向图谱级联合分析提供可复用的骨干。 临床价值 :在组织层面支持癌症亚型、分级与 er 状态等诊断预测,并可把患者分为生存显著不同的风险组、按相似性检索历史病例;在三阴性乳腺癌中无假设地筛出的空间标志物能预测抗 pd-l1 化疗免疫治疗反应,并在独立队列中分层无病生存。 ▍局限与下一步方向 作者指出若干局限:对与训练集序列相关性较弱的标志物,零样本重构会明显退化,因此虚拟增补应经过校准并锚定到实测通道;稀有细胞状态与不常见的组织结构仍难以捕捉,这可能源于当前语料中样本稀缺而非架构限制,作者预期通过定向收集与数据增长逐步弥合;生存分析虽具支持性,仍属早期概念验证,在临床使用前还需跨独立队列的协变量校正建模与前瞻性验证。 ▍FAQ Q:virtues 与以往的空间蛋白组模型有何不同? 以往编码器多假定固定标志物面板,无法关联未参与训练的标记物,也难以扩展到高通道数据;virtues 把每个标志物经蛋白语言模型嵌入后与图像 token 融合,使异质面板进入同一表示空间,天然支持零样本迁移。 Q:为什么它能对没见过的标志物做零样本预测? 标志物的身份由其蛋白序列嵌入表示,而非固定的通道编号或独热编码。因此只要新标志物在预训练蛋白表示空间中有近邻,模型就能借助标志物之间的关系推断其表达。 Q:virtues 的临床结果可靠到什么程度? 在组织级诊断与风险分层上,它超过若干专用工具与现行分层方案;三阴性乳腺癌的反应标志物交叉验证 auroc 达 0.823,并在独立队列中分层无病生存。但作者强调生存分析仍属早期概念验证。 Q:它一次能处理多少标志物,算力代价如何? 因子化注意力把计算复杂度从随通道数二次增长中解放出来,使其可处理数十至上百个通道;在相同标志物数量下,其参数量与推理成本远低于采用全注意力的 ca-mae,且性能随标志物深度持续上升。 ▍君录视角 · 虚拟细胞 解决的问题 :空间蛋白组学长期被「每个研究一套抗体面板与流程」分割——数据集在标志物种类、数量、动态范围与噪声上各不相同,为单一检测搭建的流程难以跨队列或跨平台迁移知识、复用注释参考,或建立可泛化的标志物。virtues 用蛋白序列嵌入把任意标志物放进同一表示空间,用因子化注意力扛住高通道的计算量,让异质队列、面板与技术第一次能被联合分析,并从一个骨干同时支撑分割、分型、生态位注释、组织级诊断、患者分层与相似病例检索。 集成判断 :其增量不在单一任务的精度领先,而在于把「标志物身份=蛋白序列嵌入」与「注意力拆成标志物维与空间维」两条设计固化为可插拔的表征层——这使模型对未参与训练的标记物、未遇到的技术与不同面板组合都保持可迁移;组织级临床任务再以多示例学习在同一表示上读出,标志物发现则可由该表示无假设地自动完成,构成把空间蛋白组从孤立研究推向图谱级联合分析的核心器件。 ▍原文信息 wenckstern j, jain e, von querfurth b, et al. the virtual tissues foundation model resolves spatial proteomics across scales. nature. 2026;657:744╟754. doi:10.1038/s41586-026-10884-y ▍关于我们 君录生物 · 以数据驱动创新药早期开发 自建心血管专病数据基座+分析平台,做靶点发现与药物管线早期资产。 合作 · 投资 · 学术交流:留言「合作」。 本文由ai辅助生成,内容基于已公开发表的学术论文进行科学讨论,不涉及任何未披露的产品信息、临床试验数据或公司管线进展;仅用于生物医药科普及行业学习,不构成医学建议、用药建议或投资建议。如需引用,请参阅原文。转载请注明出处。ai生成内容仅供参考,不构成任何专业建议或决策依据,最终解释权归君录生物所有。 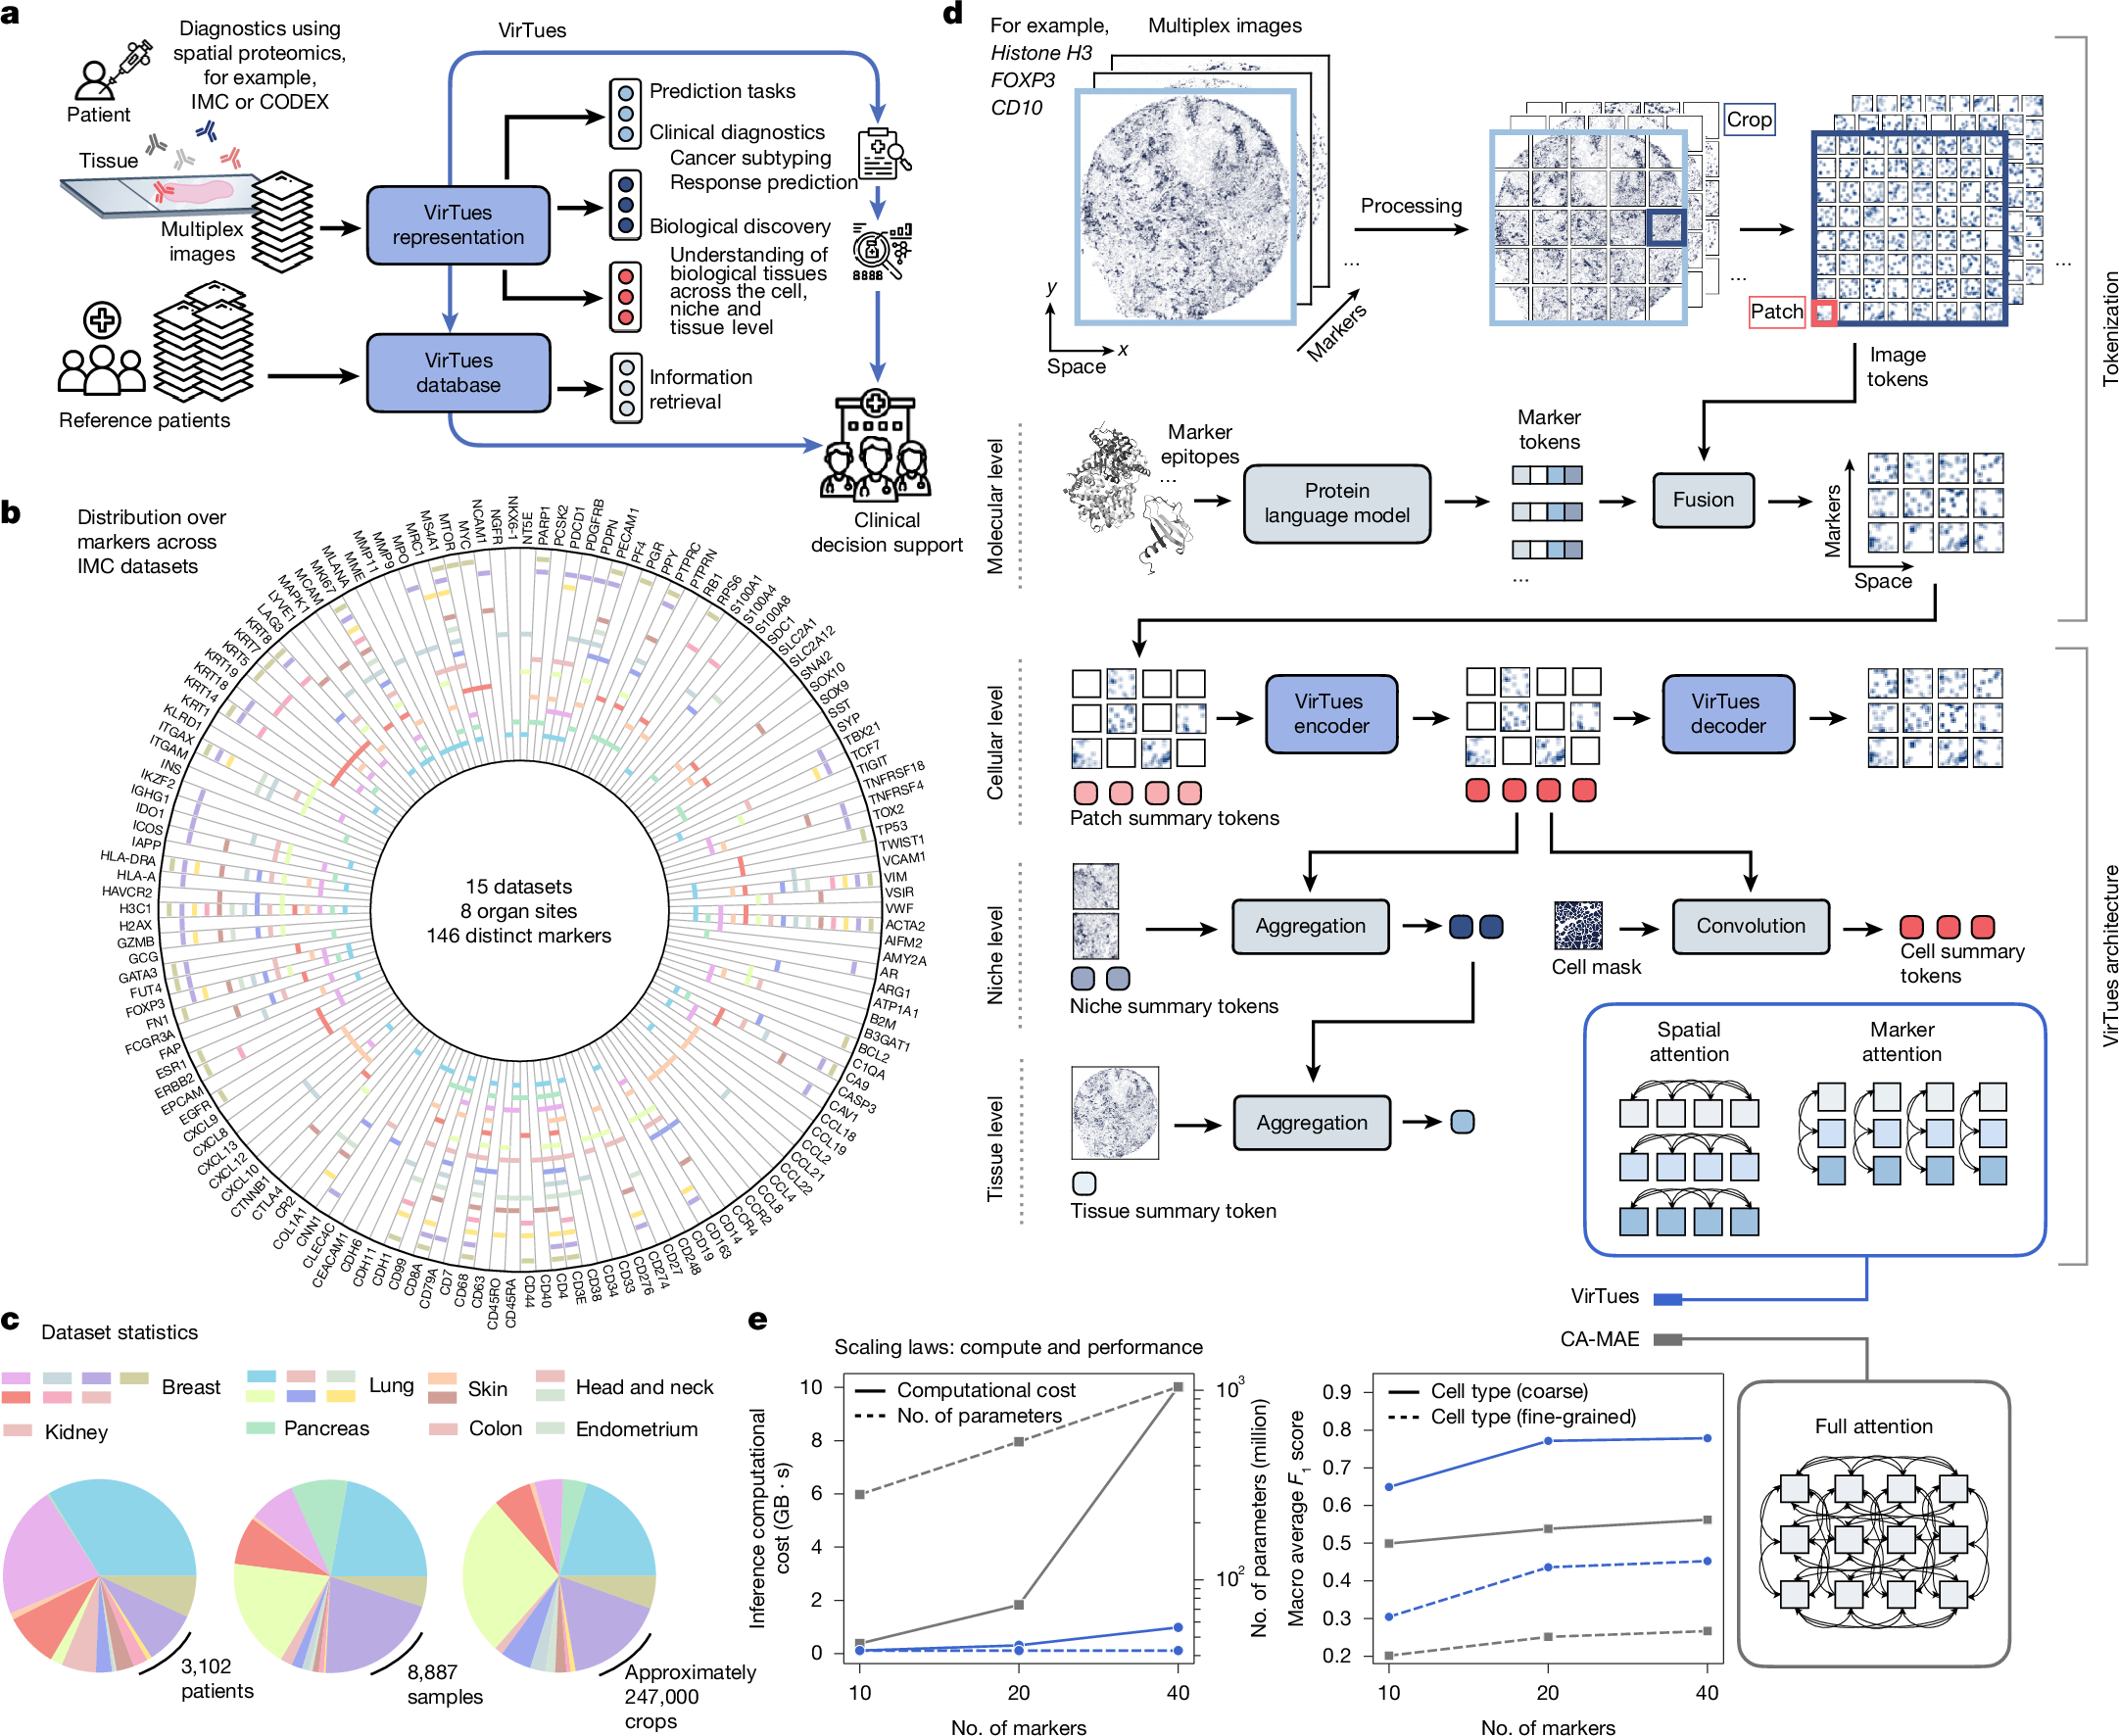 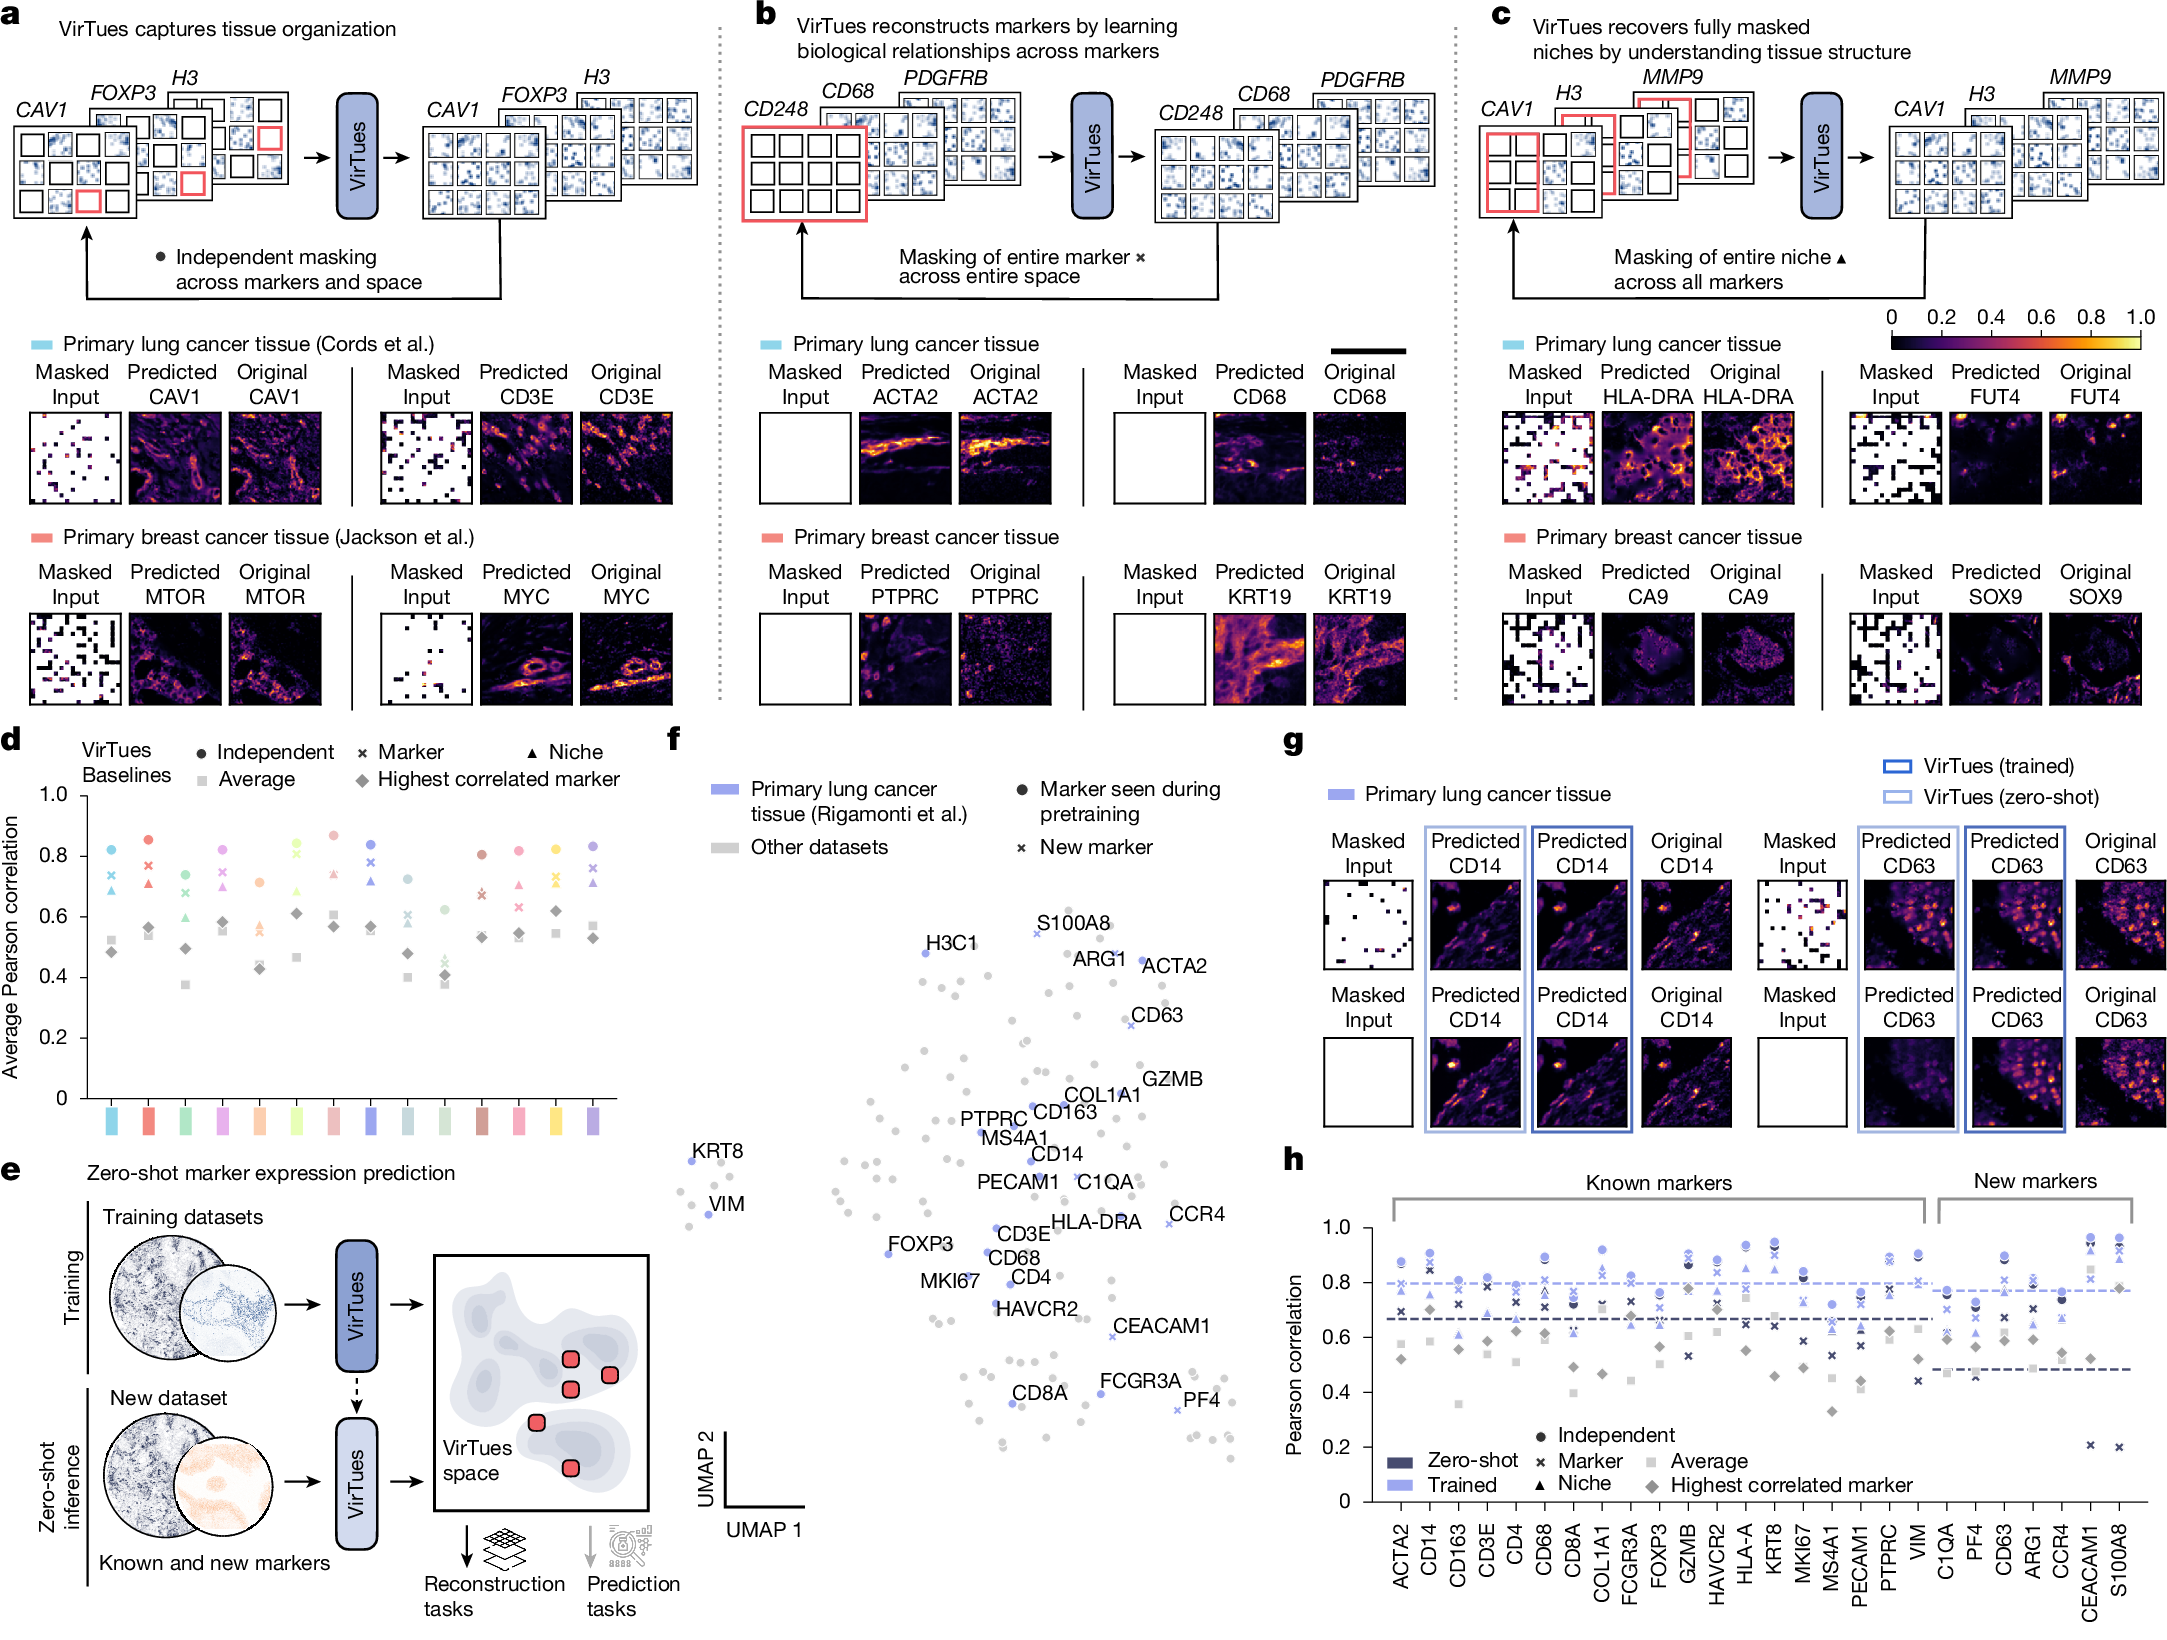 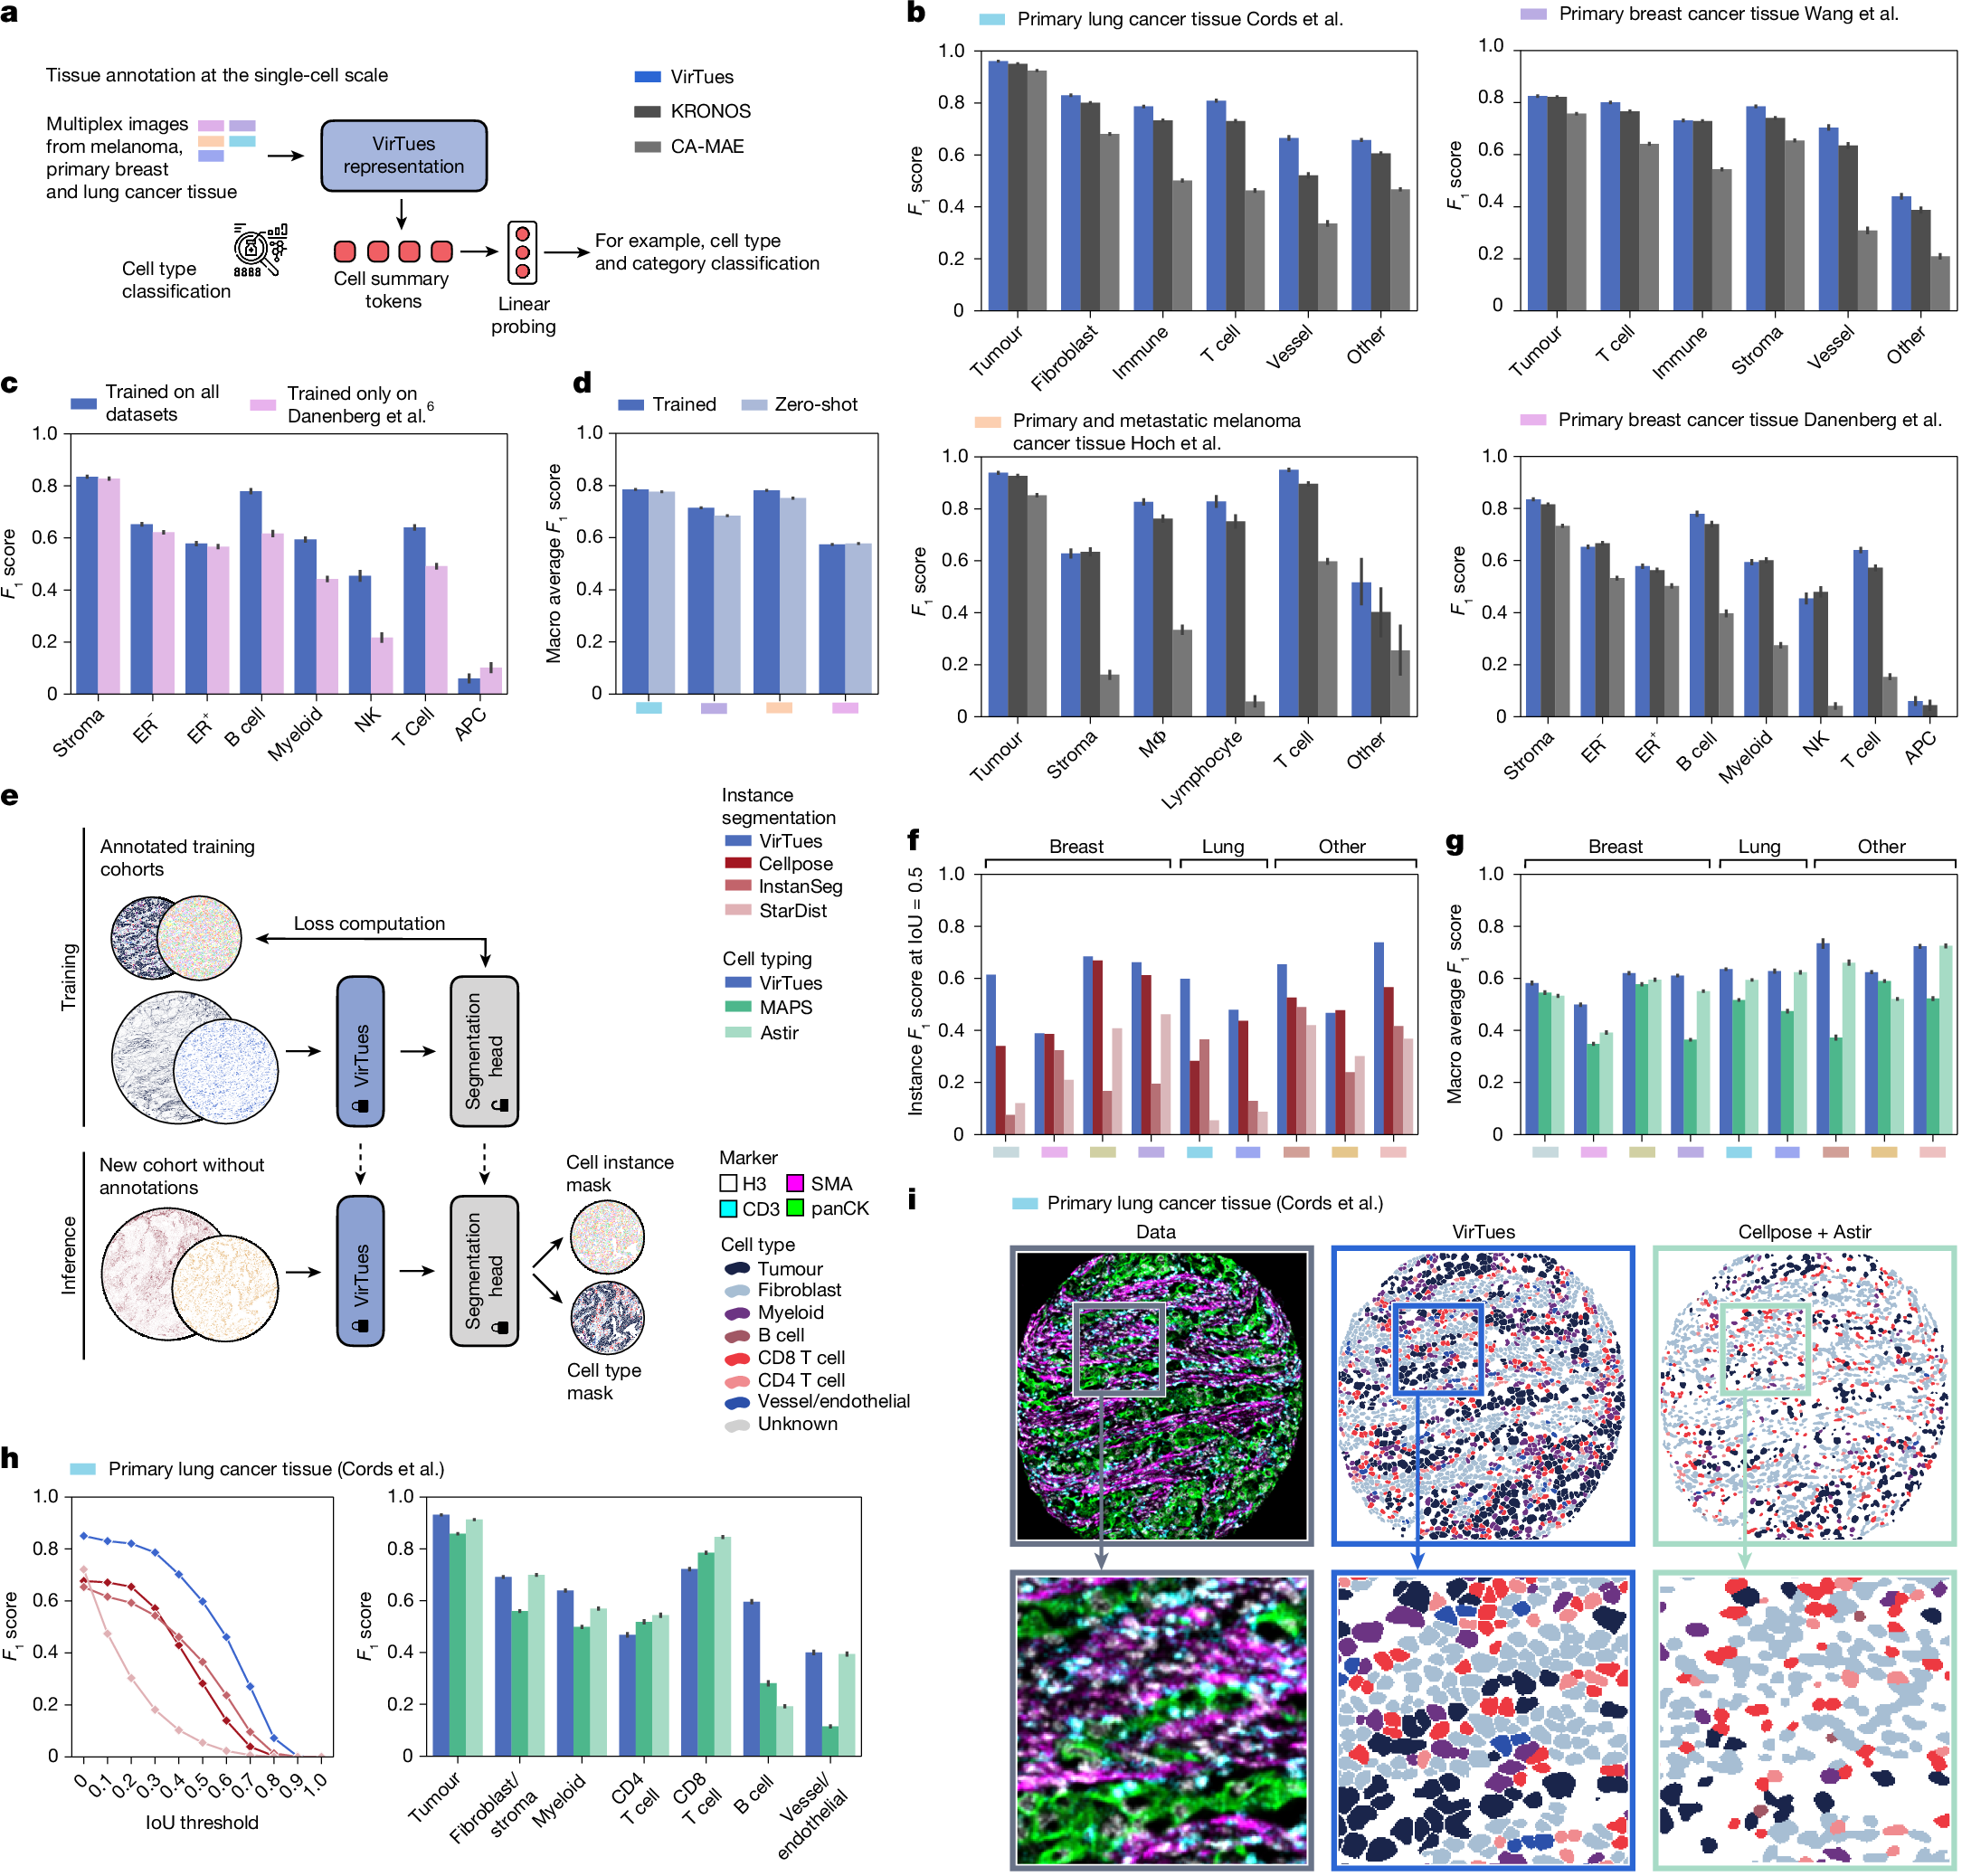 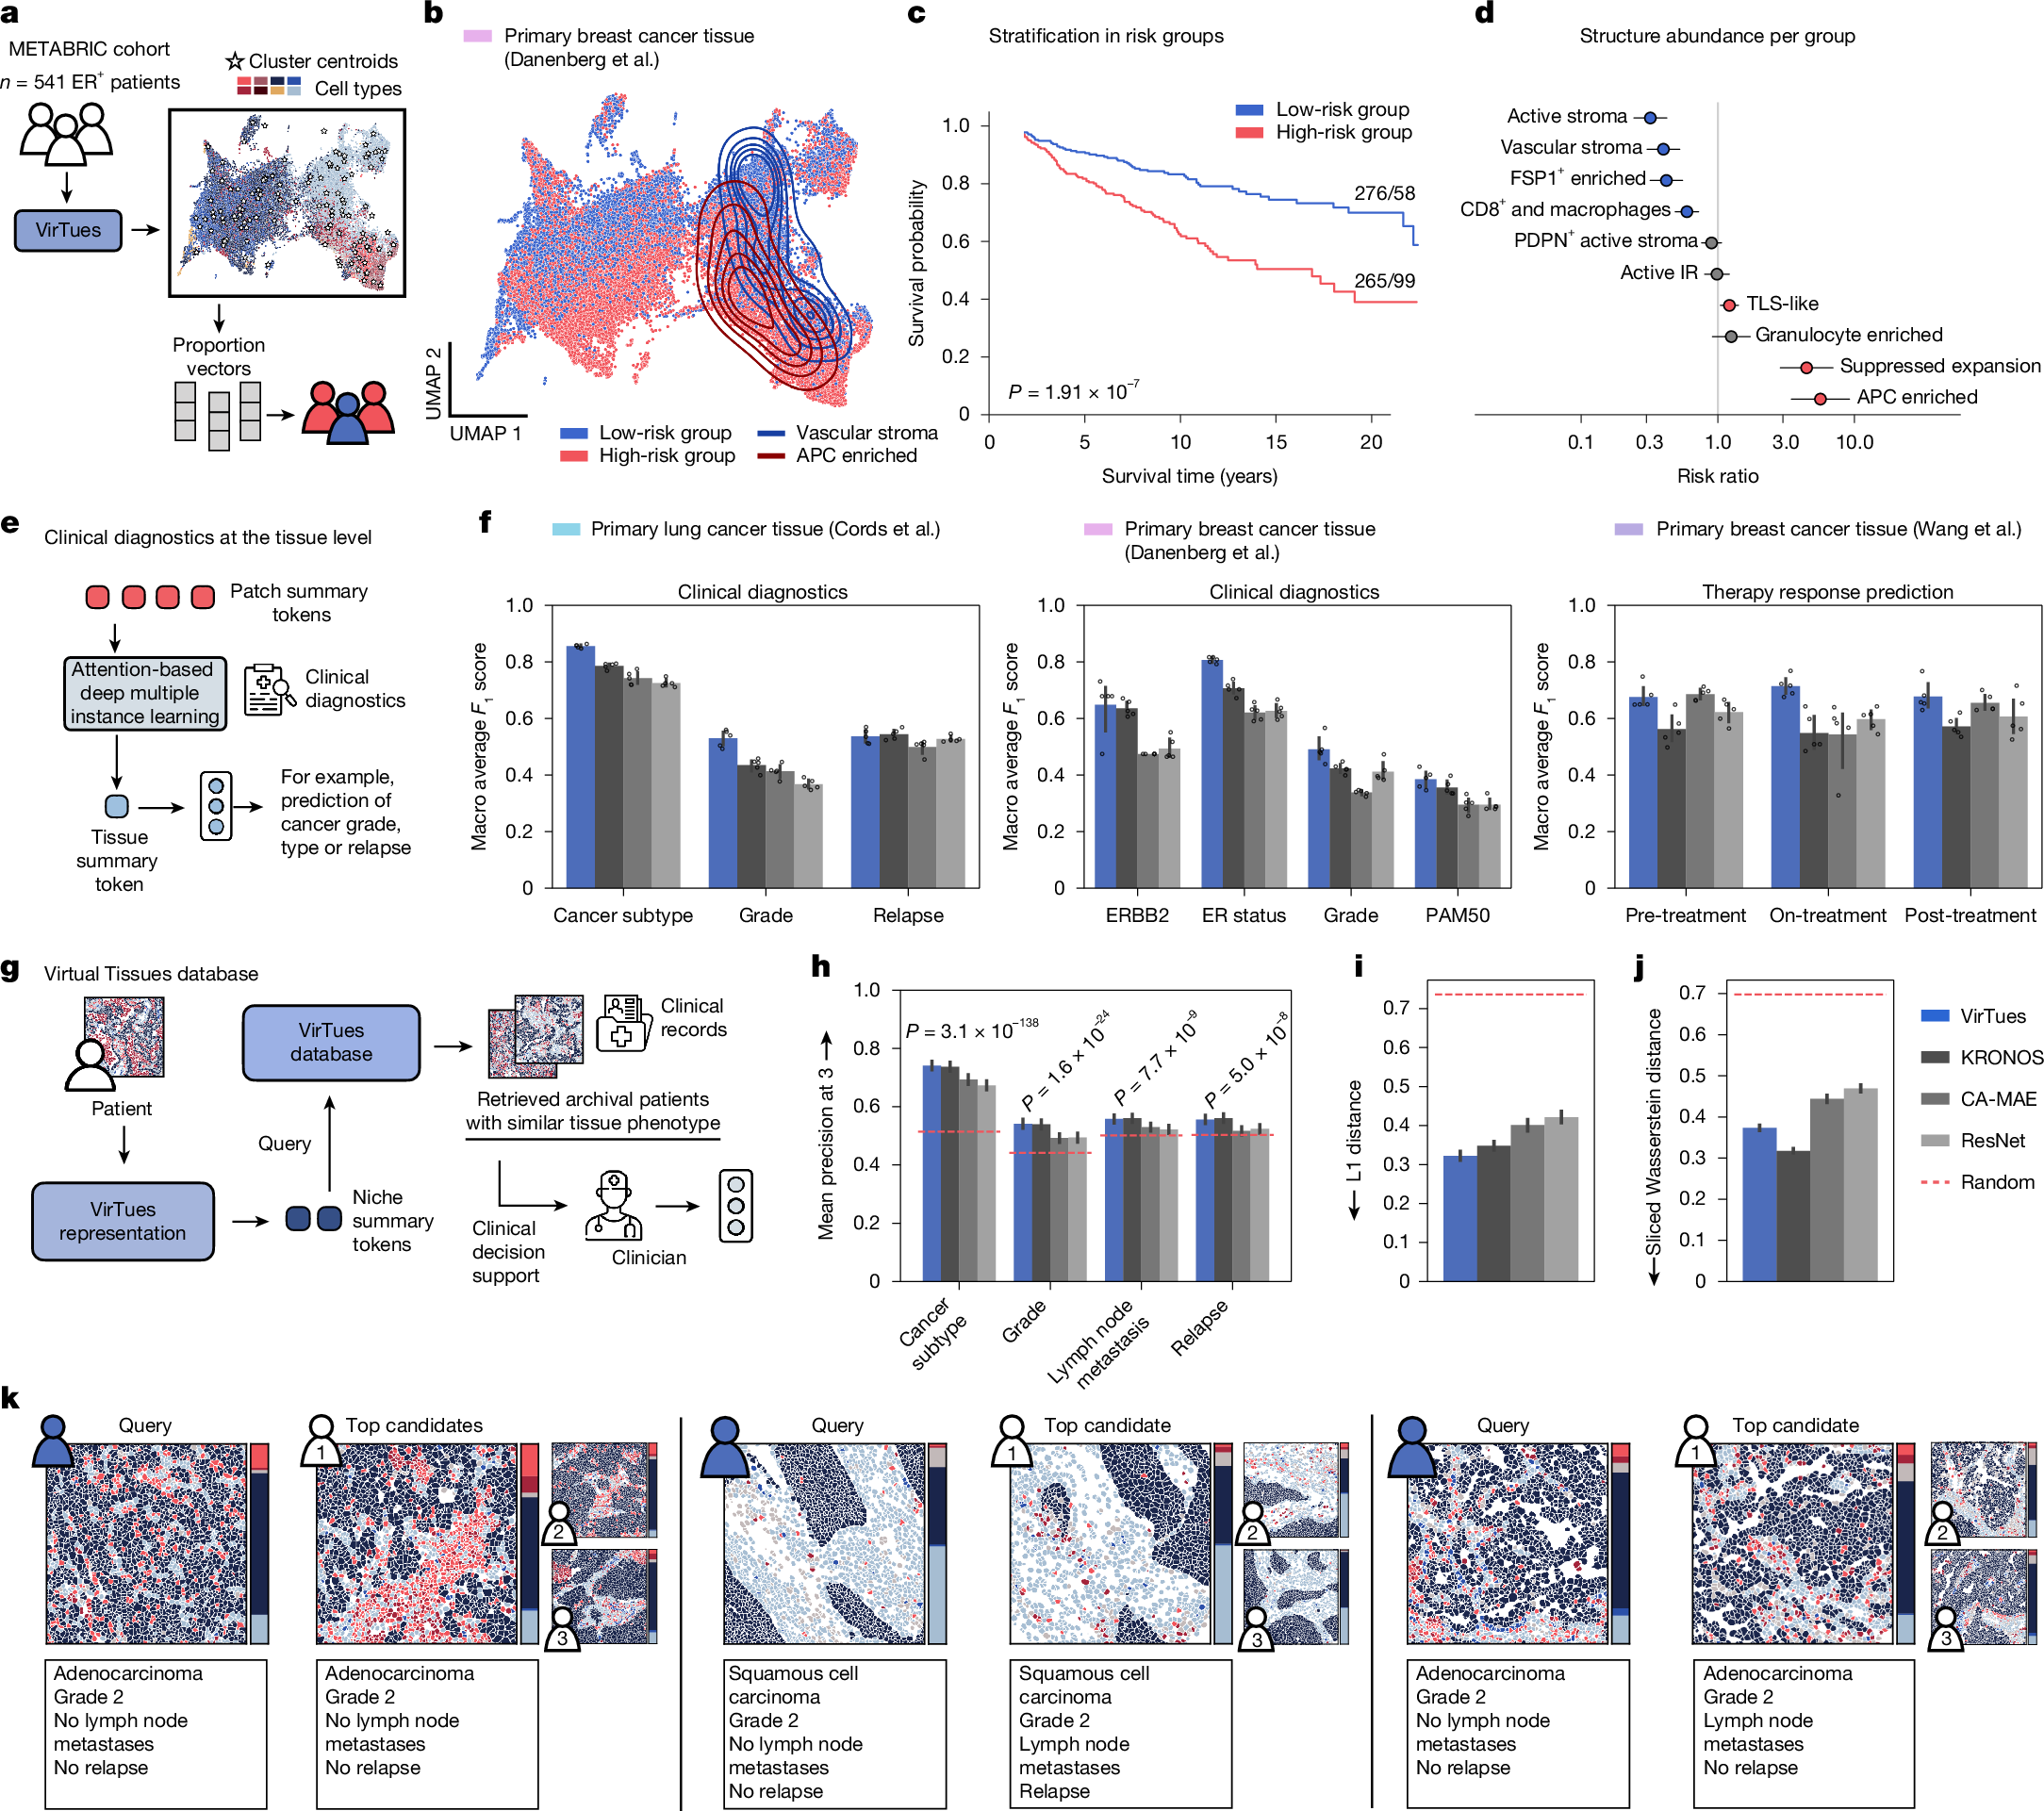 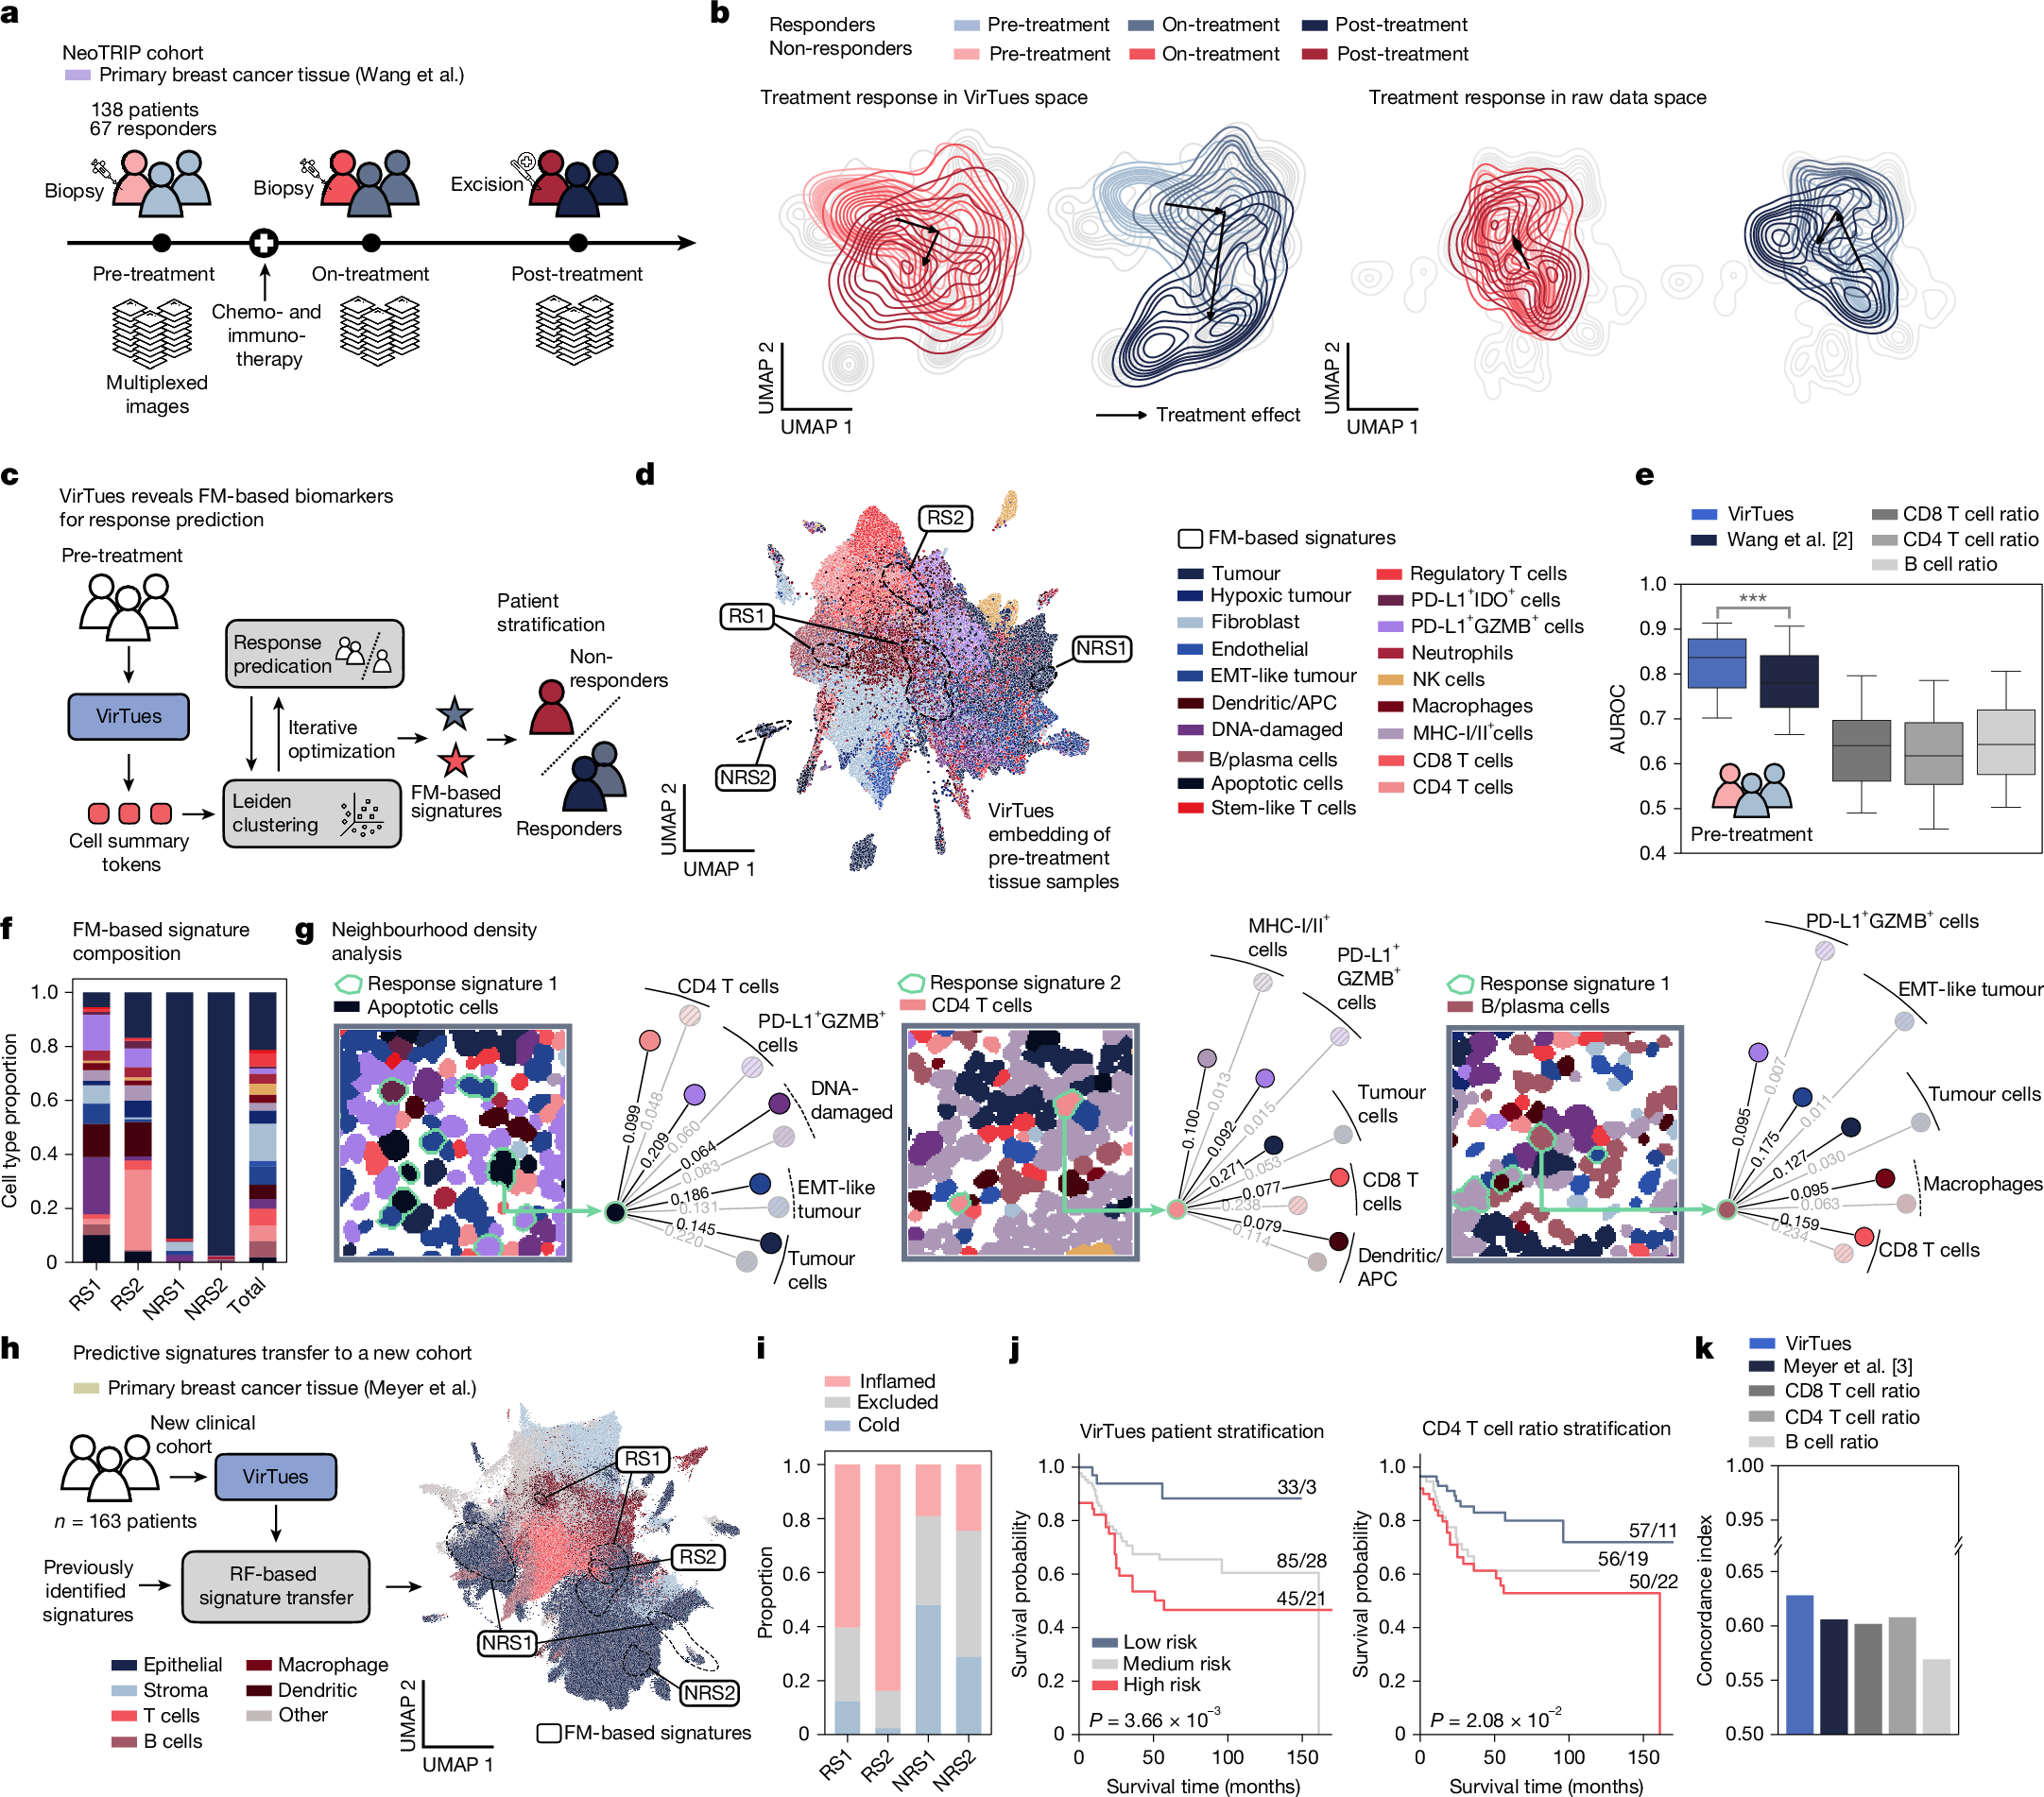 |
 回复此楼
» 猜你喜欢
 PRMT5·MTA 抑制剂 MRTX1719 的科研应用
已经有0人回复
-
SW033291 科研使用解析:分子特征、储存与实验获取要点
已经有0人回复
-
化学工程及工业化学论文润色/翻译怎么收费?
已经有84人回复
-
泛 RAS 抑制新思路:大环肽拟似物如何同时牵住突变型与野生型 RAS?
已经有0人回复
-
TYK2/JAK1 双靶点工具化合物 Brepocitinib:激酶选择性、研究进展与实验应用全解析
已经有0人回复
-
矢车菊素-3-O-葡萄糖苷质控实录:从一张HPLC图谱读懂纯度与稳定性
已经有0人回复
-
恩诺沙星(Enrofloxacin)科研解析:分子特征、LC-MS/MS 检测与实验室使用要点
已经有0人回复
-
Calderasib理化性质与实验操作技术笔记
已经有0人回复
-
RMC-6291怎么用?RAS(ON) 三重复合物工具化合物的实验室实操要点
已经有0人回复
-
苯并呋咱全解析:NBD 荧光衍生化试剂母核的化学特性与实验室应用
已经有0人回复
-
生物质炭与活化剂氢氧化钾混合注意事项
已经有0人回复
» 本主题相关商家推荐: (我也要在这里推广)




 200
