









| 查看: 59 | 回复: 5 | |||
[交流]
雷达盯不过百批目标的低空时代:开源大模型本地部署做跟踪数据标注与航迹报告生成
|
|||

|
雷达盯不过百批目标的低空时代:开源大模型本地部署做跟踪数据标注与航迹报告生成,JPDA到粒子滤波多传感器融合的算力工作站配置如何不走弯路 低空经济火起来之后,空域里肉眼可见地热闹了:物流无人机、巡检无人机、eVTOL试飞架次一年比一年多。空域热闹的直接后果,是监视系统要同时"盯住"的目标数量翻着倍涨。过去一部雷达盯十几批目标就够用,现在一个机场净空区加周边航线,同时出现的空中目标轻松过百。目标一多,跟踪这件事就从"滤波公式代入"升级成了真正的计算问题——数据关联的组合数随目标数平方级膨胀,多传感器的时空配准要在不同坐标系、不同采样率之间反复对齐,算法的每一项指标都靠成百上千次蒙特卡洛仿真才能站得住。 这个方向在国内高校里扎得很深。以南京航空航天大学的学科布局为例,探测制导与控制技术、电子信息工程两个学院长期围绕多源信息融合做文章。一个标志性线索是该校2022年10月申请、同年12月公开的发明专利《面向无人机群目标的空地联合多域探测系统和方法》(发明人张小飞、吴启晖等):这套系统把地面组网雷达、分布式频谱被动监测设备、无人机载移动多光谱和频谱监测设备拉到同一个框架里,先用联合卷积自编码深度学习网络融合多源异构信息,再依托知识图谱对群目标做推理。引用这个专利,是想说明一件事:多传感器融合跟踪早已是这个学科公认的主战场,而支撑它的算力门槛,比很多新入行的同学想象的要高。 那么课题组配机器该听谁的?实验室里通常有两派答案。多数派觉得:跟踪算法不就是几行卡尔曼滤波吗,普通电脑照样跑。踩过坑的会摇头:你把JPDA放到五十个目标的杂波场景里做一百次蒙特卡洛,笔记本当场死机。两派都只说对了一半。这篇文章摆个擂台,把CPU和GPU、在线和离线、自研和商业软件、本地和云端逐轮对比,最后落到开源大模型本地部署和具体配置推荐上,争取把"不走弯路"四个字落到实处。 多目标跟踪到底在算什么 数据关联:JPDA、MHT与粒子滤波 单目标跟踪的卡尔曼滤波,在教科书里是标准件。多目标跟踪的麻烦在于:每个雷达扫描周期收到一堆点迹,这些点迹哪些属于已有航迹、哪些是新目标、哪些是虚警,没人提前告诉你。这个"量测-航迹关联"环节,就是把多目标跟踪从线性代数拉进组合优化的深水区。 主流路线大致三族。JPDA(联合概率数据关联)对所有可能关联做概率加权,思路稳、实现直接,但计算量随目标数平方增长,目标一多就吃力。MHT(多假设跟踪)干脆保留一棵假设树,让证据慢慢裁决,密集目标场景精度好,代价是计算量指数级膨胀——论文里常见"假设修剪"四个字,翻译过来就是算不动了的妥协。粒子滤波走另一条路,用一堆随机样本近似后验分布,天然吃非线性、非高斯问题,成本是粒子数乘目标数,并行度倒是不错。 《雷达学报》2023年第12卷第1期刊登的综述《分布式多传感器多目标跟踪方法综述》(曾雅俊、王俊等,北京航空航天大学)把这场账算得很清楚:文中对比表给出,JPDA运算量中等、精度中等;MHT运算量高、精度高;PHD滤波运算量低、精度偏低;GLMB运算量高、精度高。选算法本质上是选算力预算——这句话建议抄在实验室的采购申请里。 多传感器融合:配准、关联、融合三步走 回到南航那个专利代表的典型场景:雷达给距离和方位,光电设备给角度和图像,频谱设备给辐射源线索。三种传感器量测维数不同、误差特性不同、采样率不同,谁也替换不了谁,融合之前必须先做三件事。 第一步是时空配准,把各传感器的量测统一到公共坐标系和统一时间基准上,不然关联全错。第二步是航迹关联,判断不同传感器报上来的两条航迹是不是同一个目标——综述里的一组典型数据是:SMBTANTD方法航迹关联正确率约99.6%、耗时约3.4秒,模糊函数法正确率约96.7%、耗时约8.1秒,精度每往上挤一个百分点,背后都是计算量的此消彼长。第三步才是估计融合,凸组合、协方差交集、广义协方差交集、算术平均融合各有适用边界,异构传感器混搭时GCI和AA类方法更常用。这三步串起来,才是完整的多目标跟踪流水线。 第一轮擂台:CPU平台对GPU平台 对比维度 CPU平台 GPU平台 典型任务 滤波递推、JPDA/MHT关联、蒙特卡洛仿真、航迹管理 深度学习融合网络、点迹级并行处理、大模型推理 并行方式 线程级细粒度,MATLAB/Python多核天然支持 大规模数据并行,代码需要专门改造 资源关键项 核数与内存容量 显存容量决定模型规模上限 成本结构 堆核相对便宜,单机可办 高端卡单价高,整机预算占比大 升级路径 加内存最省事 换卡受制于机箱、电源、散热 擂台结论:经典滤波和关联的主战场在CPU,内存容量决定能开多大规模的粒子集和蒙特卡洛批次;深度学习融合方法入场之后,GPU又变得不可替代。两者构成互补关系,典型课题组的负载形态是"CPU算关联、GPU跑学习和标注",一台CPU内存扎实、单张大显存卡的异构工作站,是当前最省心的主流形态。 第二轮擂台:在线实时处理对离线批处理 对比维度 在线实时处理 离线批处理 典型场景 外场试验实时监控、半实物仿真闭环 算法蒙特卡洛评估、数据集标注、论文复现实验 硬件侧重 单步延迟、数据接口吞吐、长时间稳定 总吞吐、内存容量、任务排队能力 目标规模 十几到几十批 仿真里放到成百上千批也常见 出错代价 丢帧、航迹断裂,现场无法补救 浪费机时,改完重跑即可 时间占比 外场那几天 科研日常的全部 擂台结论:科研阶段九成的时间花在离线批处理上,在线实时只是外场试验的短暂窗口。配机器应当按离线吞吐优先:大内存、多核、能7×24小时满载跑批,比追求单步极限延迟实在得多。外场那几天的在线需求,用同一台机器压低单批次规模也能顶过去。 开源大模型本地部署:跟踪数据标注与航迹报告生成 算法跑通之后,还有两件躲不掉的杂活:给大量历史航迹数据做事件标注,以及把每次仿真和外场试验的结果整理成航迹报告。这两件事交给开源大模型本地部署来做,正在变成课题组的标准动作。先说为什么值得本地部署。 数据保密是第一道门槛。雷达航迹、目标运动特征这类数据敏感等级高,传到公有云API上做处理,在多数项目里直接不合规,本地部署是硬性要求。 外场环境经常没网。试验现场要把当天的航迹批注、试验纪要整理出来,离线可用的大模型是刚需。 批量任务摊薄成本。上千段航迹逐段标注、几十轮仿真的报告逐份生成,按token调用付费长期算下来不划算,一次性投入的本地卡更省。 模型选型上,两个真实开源模型值得点名。Qwen3-32B由阿里在2025年4月开源,320亿参数稠密架构,推理质量和硬件门槛平衡得好,适合作为标注与报告生成的主力。GLM-4.5-Air由智谱在2025年7月以MIT协议开源,MoE架构总参数1060亿、激活参数120亿,128K的超长上下文是杀手锏——一整段长航迹的多目标批注、一整份试验报告素材,可以一次喂进去而不用切段。 显存怎么估,一条公式就够:所需显存约等于参数量(B)乘量化字节数再乘1.2。FP16每参数2字节、Q8每参数1字节、Q4每参数0.5字节。算例一:Qwen3-32B做Q4量化约需19到22GB显存,24GB显存属于舒适档;若坚持FP16全精度,约需77GB,得上数据中心级大显存卡。算例二:GLM-4.5-Air是MoE架构,这里有个容易踩的坑——MoE省算力不省显存,显存按总参数1060亿估算,Q4量化约需55到64GB,80GB显存档位的单卡才能装得下。 量化三档的分工也明确:FP16留给对措辞质量最挑剔的正式报告定稿;Q8作为日常交互的均衡档;Q4则是批量标注的主力档,几十段航迹连轴转,质量损失肉眼难辨。速度量级要有心理预期:纯CPU跑32B模型只有个位数tokens/s,写段批注能急死人;单卡GPU则能达到几十到上百tokens/s,批处理才真正成立。最后区分一下推理和微调:本场景以推理为主,若想让模型学会课题组自己的术语体系做LoRA微调,显存需求要按数倍于推理来预留,这直接决定了后面配置档位的选择。 软件生态:自研代码与商业软件的取舍 第三轮擂台:自研代码对商业软件 对比维度 自研代码(Python/MATLAB) 商业软件与平台 算法灵活度 公式随意改,新论文方法快速复现 封装固定,定制空间小 上手成本 高,滤波和关联细节要自己啃 低,流程化向导开箱即用 算力利用 可针对工作站针对性调优 通用化设计,难吃满特定硬件 经费支出 开源免费或校园版授权 授权费动辄数万元起步 成果归属 代码即论文素材 黑盒,写不进方法章节 擂台结论:科研阶段坚定选自研,论文复现、算法改进都靠它;到了工程交付阶段,再评估商业平台做系统集成不迟。一个务实的组合是:Python生态做主力开发(filterpy打底,JPDA、MHT、粒子滤波自研实现),MATLAB做结果对照,推理侧用vLLM、Ollama这类本地部署框架把Qwen3-32B和GLM-4.5-Air服务化,标注脚本和报告模板直接对接。 配置推荐 高校买设备跟企业不一样,钱不是花完就完事了,得走采购流程、过资产验收,还得考虑这台机器能不能撑过两届学生的毕业周期。结合前面几轮擂台磨出来的结论——CPU扛关联滤波、GPU扛深度学习与本地大模型、内存容量决定批处理规模——先解决"买本地还是租云端"这个方向题,再谈具体档位。 第四轮擂台:本地塔式对云端租用 对比维度 本地塔式工作站 云端租用 数据流向 航迹数据不出实验室 敏感数据外传有合规障碍 成本结构 一次性投入,三年摊薄 按小时计费,长期跑批反而更贵 可用性 7×24小时随时开机 排队、带宽、断网都是变量 定制自由度 硬件软件随便改 机型固定,环境受限 擂台结论:数据敏感加长期批处理,本地塔式是主线;云端只适合做弹性补充,比如临时借卡跑一轮超大蒙特卡洛。下面是按"够用三年、维护简单、升级有路"原则整理的三档参考。 方案A:教学验证与小规模仿真 适用场景:本科教学、单传感器小场景算法验证、跟踪数据标注的轻量推理。 推荐机型:A350 153128-MCT CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷 GPU:RTX 5090D v2 24GB+水冷 内存:128GB DDR5 存储:4TB NVME + 8TB SATA 显存:24GB 显存带宽:1.34 TB/s 注:CPU频率为UltraLAB全核超频实测优化频率。 方案B:多传感器融合与32B级本地部署主力 适用场景:多传感器时空配准与航迹关联的中等规模蒙特卡洛仿真、Qwen3-32B全精度档推理、GLM-4.5-Air量化档推理。 推荐机型:AX430 127128-MCA CPU:Xeon金牌6530(32核,2.7GHz) GPU:A100 80GB+水冷 内存:128GB DDR5 存储:4TB NVMe 显存:80GB 显存带宽:2 TB/s 注:CPU频率为UltraLAB全核超频实测优化频率。 方案C:团队共享与全参数微调 适用场景:全组共享的高并发批处理平台、32B模型的LoRA微调、大规模粒子滤波并行与超长上下文报告生成。 推荐机型:GX660M 227512-MD2A CPU:2×Xeon金牌6530(64核,2.7GHz) GPU:2×A100 80GB+水冷 内存:256GB DDR5 存储:4TB NVMe 显存:160GB 显存带宽:2×2 TB/s 注:CPU频率为UltraLAB全核超频实测优化频率。 FAQ 多目标跟踪仿真到底吃CPU还是吃GPU? 经典滤波、JPDA和MHT关联、航迹管理几乎全在CPU上跑,吃核数和内存;只有深度学习融合方法和大模型标注推理需要GPU。所以这台机器的正确形态是CPU内存扎实加一张大显存卡,两边都别瘸腿。 粒子滤波的粒子数设多少合适? 粒子数是精度换时间。工程上常见的起点是每目标一千到五千粒子,非线性强、噪声非高斯明显时往上加;做灵敏度分析时可以扫几个档位画曲线。记住粒子集要常驻内存,粒子数乘目标数乘蒙特卡洛批次,就是内存需求的主体。 Qwen3-32B本地部署需要多大显存? 按显存约等于参数量乘量化字节数乘1.2估算:Q4量化约19到22GB,24GB显存舒适;Q8约38GB;FP16约77GB。课题组做标注和报告生成,Q4档是性价比最高的主力档,留足上下文余量即可。 为什么GLM-4.5-Air激活参数只有120亿,显存占用却比32B稠密模型还高? MoE架构每次前向只激活部分专家,所以省算力;但全部专家参数都要驻留显存,所以显存按总参数1060亿算。Q4量化约需55到64GB,这就是它要求80GB显存档位单卡的原因。选型时记住:MoE省算力不省显存。 课题组一台机器多人共用,任务怎么调度? 按负载形态错峰:CPU密集的蒙特卡洛仿真挂后台排队跑,GPU推理服务常驻,显存大的模型和小的模型分卡部署或分时复用。约定好内存上限和临时数据清理规则,比买两台互相打架的杂牌机强。 手里已有一台工作站,能不能升级继续用? 能,先看三个瓶颈:内存够不够大(粒子集和批处理最先撞墙)、显存够不够装目标模型(决定能不能上GLM-4.5-Air)、电源和机箱还有没有余量(决定能不能换大卡)。内存和存储是最容易补的课,机箱电源见顶的机器再考虑整体换代。 结语 多目标跟踪这门课,前半场考数学,后半场考算力。JPDA、MHT、粒子滤波每一条公式背后都标着计算量的价签,多传感器融合的三步走里藏着配准和关联的真实开销,而数据标注和航迹报告这些"杂活",正在被Qwen3-32B和GLM-4.5-Air这样的开源模型接过去。把CPU、GPU、内存、显存四本账算清楚,再对照课题组未来三年的真实负载选档位,配置这件事就能一次走对。选型的尽头没有神机,只有匹配的负载。 关于 UltraLAB:UltraLAB(西安坤隆计算机科技有限公司)是国内知名高端定制图形工作站厂家,面向光学设计、计算光学、光子学、人工智能等领域提供 工具链→算法路径→硬件 精准匹配的专业计算平台,支持预装开源软件栈与多机集群交付。 本文基于公开技术资料与开源社区信息整理,硬件配置参数以 UltraLAB 官方最新方案为准 欢迎微信咨询 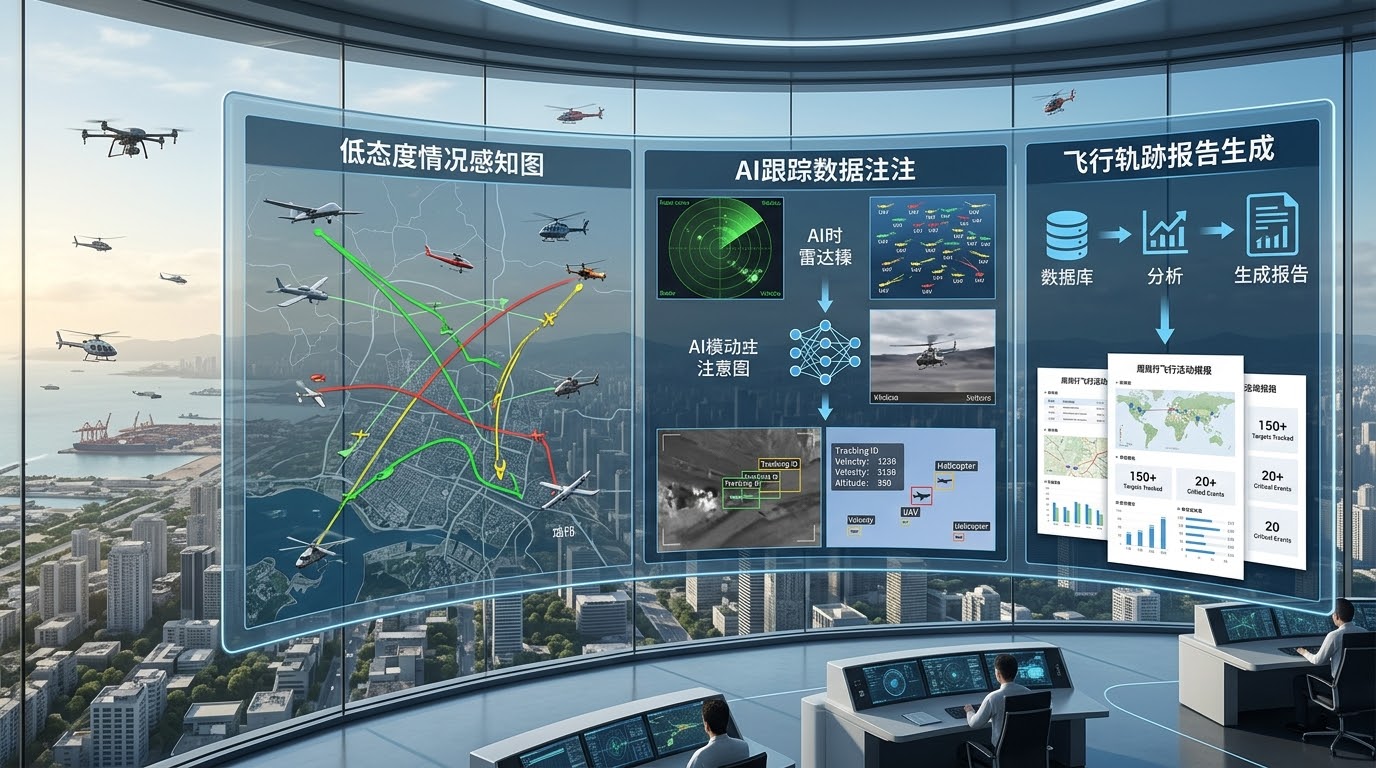 |
 回复此楼
» 猜你喜欢
 澳门大学IAPME李海峰教授常年招收博士研究生
已经有0人回复
-
深圳大学应用技术学院招聘凝聚态物理博士后
已经有124人回复
-
物理学I论文润色/翻译怎么收费?
已经有207人回复
-
求助中医院临床中医中标的青年标书学习,谢谢
已经有5人回复
-
浙大物院表面物理课题组长期招收普博及直博学生
已经有259人回复
-
【征稿】Springer Nature热电专题 Discover Materials / Discover Chemistry
已经有47人回复
-
25届硕士申请,材料计算方向
已经有2人回复
-
课题组招1-2名硕士
已经有1人回复
-
机时越来越贵之后,我把一部分 DFT 流程搬到了 AI 计算平台上
已经有0人回复
-
斯坦福大学与Elsevier世界前2%学者新排名查询
已经有0人回复
» 抢金币啦!回帖就可以得到:
-
2026年人文教育与社会发展国际会议(HESD 2026)
 +1/803
-
诚征女友
+1/481
-
重庆医科大学合川医院(合川区人民医院)公开招收博士后研究人员
+1/93
-
浙江农林大学生物质能源团队青年教师招聘通知
+1/90
-
祈祷我们论文发表顺利!!!
+1/84
-
中国科学院北京纳米能源与系统研究所 诚招2027级“申请-考核”制普通博士2名
+5/75
-
硫化物负极充电充不上去
+2/66
-
沈阳工业大学 环境电化学技术研究团队 招收硕士研究生(学硕/专硕)
+2/60
-
深圳理工大学—安徽大学 联合招聘博士后多名(电化学储能方向)
+1/49
-
浙江农林大学生物质能源团队青年教师招聘通知
+1/44
-
大湾区大学-中山大学联合培养2027级博士研究生(二维材料/量子输运/自旋电子学)
+3/43
-
北京工商大学食品与健康学院杨绍祥课题组食品科学与工程博士招生
+1/38
-
中国地质大学(武汉)氢能研究院杨明团队-招收27年博士-新能源材料化学及催化
+1/33
-
爱丁顿实验
+1/32
-
湖南大学-分析检测技术和生物柔性传感器-招收1名博士研究生 (2027年)
+1/23
-
坐标广州,诚征女友,结婚对象,非诚勿扰
+1/21
-
高分辨质谱测试丨科研单位对外服务
+1/18
-
上交化院邓楠楠组招收27年春/秋季入学申请考核博士-化学、生物相关方向
+1/10
-
华南师范大学 2027级申请考核制博士研究生招生
+1/2
-
海南大学材料学院国家级人才团队诚聘在职科研骨干和博士后
+1/1
简单回复
s9659z2楼
2026-10-14 18:14
回复
peterfxmc(金币+1): 谢谢参与

水云寒11203楼
2026-10-14 18:50
回复
peterfxmc(金币+1): 谢谢参与

psylhh4楼
2026-10-14 19:21
回复
peterfxmc(金币+1): 谢谢参与
2026-10-14 19:32
回复
peterfxmc(金币+1): 谢谢参与
lymjjh6楼
2026-10-14 20:09
回复
peterfxmc(金币+1): 谢谢参与


