









| 查看: 42 | 回复: 2 | |||
| 【有奖交流】积极回复本帖子,参与交流,就有机会分得作者 peterfxmc 的 3 个金币 ,回帖就立即获得 1 个金币,每人有 1 次机会 | |||
[交流]
从XPU到系统芯片:RISC-V存算一体与SoC验证——智能计算架构演进的算力工作站部署
|
|||

|
从XPU到系统芯片:RISC-V存算一体与SoC验证——智能计算架构演进的算力工作站配置该怎么选?AI大模型本地部署方案 2026年4月,在第九届数字中国建设峰会上,一款名为"星元智能体"的产品引起了行业关注。它基于中星微自主研发的XPU多核异构处理器架构,集成了标量、矢量和张量算力,能够单芯片同时运行通用语言大模型和视觉大模型。往前追溯一年,2025年4月发布的"星光智能五号"芯片已经实现了这一突破——它是我国首枚全自主可控、可单芯片运行通用语言大模型的嵌入式AI芯片,据官方资料介绍,多颗芯片协同部署可支撑大模型推理任务。 这些成果的背后,是一场关于"智能计算架构"的深层变革。传统CPU和GPU的架构设计逐渐触及物理极限,大模型的参数量以指数级膨胀,芯片行业正在经历从"通用计算"到"领域专用"、从"存算分离"到"存算一体"的范式转换。而这场变革的核心战场之一,正是系统芯片(SoC)的设计与验证。 一、智能计算架构的技术演进:从通用到异构 1.1 传统架构的瓶颈 在过去的几十年里,计算机体系结构遵循着相对稳定的演进路径:CPU负责通用计算,GPU负责并行图形渲染,各类专用加速器各司其职。这种分工在移动互联网时代运行良好,但在AI大模型时代暴露出了根本性的矛盾。 数据搬运已经成为性能提升的最大障碍。传统冯·诺依曼架构中,计算单元和存储单元物理分离,数据在两者之间频繁往返。当Transformer模型的参数量达到千亿级别时,内存带宽的瓶颈效应被急剧放大——GPU的计算单元可能在等待数据的过程中空转超过80%的时间。这种"内存墙"问题,倒逼芯片架构师重新思考计算的物理组织方式。 1.2 XPU与异构计算的崛起 中星微提出的XPU架构代表了异构计算的一种重要方向。它是在同一芯片内集成标量处理器(负责控制流)、矢量处理器(负责数据并行)和张量处理器(负责矩阵运算)三类计算单元,通过特定的调度模块实现高效算力分配。这种设计的核心思想是"用合适的工具做合适的事"——控制逻辑交给标量核,图像预处理交给矢量单元,大模型的注意力计算交给张量引擎。 2026年5月举办的首届人工智能院士论坛上,中国科学院计算技术研究所副所长包云岗分享了开源处理器技术的最新进展。依托RISC-V架构的开放性优势,国内研究团队正在构建可定制化的大规模算力平台。RISC-V的模块化指令集设计,使得芯片设计者可以根据具体应用场景灵活裁剪和扩展处理器的功能单元,这与XPU的异构理念形成了有趣的呼应。 1.3 存算一体与3D堆叠 在架构层面的另一大突破来自存算一体技术。2026年7月的世界人工智能大会上,清微智能展示了"可重构3.0"技术和新一代旗舰芯片TX82,推动三维存算融合芯片从概念走向现实。东方算芯展出了全球首颗基于国内成熟工艺的"软件定义+3D堆叠近存计算"AI芯片DF1000。这些产品的共同特点是缩短了计算单元与存储单元之间的物理距离,将部分计算直接放在存储阵列中完成,从而大幅减少数据搬运的能耗和延迟。 清微智能联合创始人欧阳鹏在论坛上指出,算力自主不能只理解为"用一颗国产芯片换一颗进口芯片",还要让中国企业真正拥有定义芯片、组织系统和建设生态的能力。这一观点切中了智能计算架构研究的核心——架构创新不仅是技术问题,更是生态问题。 二、系统芯片设计的核心挑战 2.1 复杂度爆炸 系统芯片(SoC)的设计正在经历前所未有的复杂度增长。一颗现代AI加速器芯片可能集成数百亿个晶体管,包含CPU核心、NPU核心、GPU核心、DSP、ISP、编解码器、高速接口控制器等数十种功能模块。这些模块之间通过片上网络(NoC)互联,时钟域跨越多个数量级,功耗管理涉及数十个电压域和电源门控区域。 EDA行业数据显示,仿真与验证环节约占整个芯片开发周期的50%到80%。这意味着,一款需要3到5年开发周期的SoC芯片,可能有超过一半的时间花在验证上。验证的复杂度呈现指数级增长,因为每一个新增的功能模块都可能与现有模块产生意想不到的交互效应。 2.2 EDA工具链:芯片设计的操作系统 支撑这一庞大工程的是EDA(电子设计自动化)工具链。从高层次架构设计、RTL编码、逻辑综合、物理实现到最终的签核(Sign-Off),芯片设计的每一个环节都依赖专业软件工具。 在数字芯片前端设计阶段,Synopsys的VCS Simulator和Cadence的Xcelium是业界主流的功能仿真工具,支持SystemVerilog和UVM验证方法论。静态分析方面,Synopsys的Spyglass用于跨时钟域检查和设计规则验证。形式化验证工具则确保设计在数学意义上的正确性。进入后端阶段,逻辑综合依赖Synopsys的Design Compiler,物理实现则使用Synopsys的IC Compiler II或Cadence的Innovus进行布局布线。时序签核需要Synopsys的PrimeTime或Cadence的Tempus进行精确的静态时序分析。 国产EDA工具近年来也取得了显著进展。上海弘快科技的RedEDA平台实现了从芯片封装设计、PCB布局到信号完整性仿真的全流程覆盖,支持2.5D和Chiplet等先进封装工艺。芯华章科技的桦捷HuaPro P2E双模验证平台已经落地联芸科技等存储主控芯片企业。合见工软、思尔芯等企业在FPGA原型验证和硬件仿真加速器领域也形成了自己的产品矩阵。 2.3 西北工业大学的布局 在国内高校中,西北工业大学计算机学院在智能计算架构与系统芯片方向有长期积累。学院设有"仿生芯片交叉研究中心",开展仿生感知和仿生计算相结合的新一代人工智能芯片研究。在计算机系统结构方向上,研究团队承担了多项国家自然科学基金重点项目和863课题,研发了面向星载遥感图像处理的目标识别专用加速器,解决了特殊算法对计算架构、数据组织和功耗约束的需求。 更值得关注的是学院在"智能计算系统"课程建设上的投入。2024年,学院获批教育教学改革项目"基于国产化嵌入式XPU的智能计算系统课程实验平台研究与构建",聚焦本科生系统能力培养,构建了从场景分析、算法设计、系统部署到硬件优化的完整全栈式实验案例。这种"从芯片到系统"的教学理念,正是智能计算架构人才培养的关键。 三、系统芯片设计中的主要软件工具 除了EDA工具链,系统芯片设计和智能计算架构研究还涉及一系列辅助软件。 在架构级探索阶段,研究人员常用gem5进行处理器微架构模拟,用McPAT进行功耗和面积建模,用CACTI分析存储系统的延迟和能耗特性。对于AI加速器的设计评估,Timeloop和Accelergy等开源工具可以帮助架构师快速评估不同数据流策略下的计算效率和存储访问模式。 在RTL实现层面,除了商业EDA工具,开源工具链也扮演着越来越重要的角色。Yosys开源综合工具配合NextPNR布局布线工具,为小型数字电路设计提供了零成本的验证路径。RISC-V生态系统中的Rocket Chip和BOOM处理器生成器,允许研究者通过Chisel硬件描述语言快速定制处理器核。 在验证环节,UVM(Universal Verification Methodology)是业界标准的方法学框架。Cocotb则为Python开发者提供了更轻量级的验证环境,可以直接用Python编写测试激励和参考模型,与SystemVerilog的DUT(被测设计)进行协同仿真。 对于智能计算架构的性能分析, roofline模型是评估算法在特定硬件上性能上限的经典工具。通过将计算强度(每字节内存访问对应的浮点运算次数)与硬件的峰值算力和内存带宽对比,可以直观判断一个计算任务是"计算受限"还是"内存带宽受限"。 四、AI大模型本地部署方案 在系统芯片设计和智能计算架构研究中,AI大模型的本地部署已经成为不可或缺的环节。无论是用于RTL代码生成、验证用例自动生成,还是用于架构搜索和功耗预测,大模型都能显著提升研发效率。 4.1 轻量级部署(7B~14B参数) 对于个人研究者或小型课题组,部署7B到14B参数规模的模型是最务实的选择。以Qwen2.5-7B或Llama-3.1-8B为例,这类模型在单张24GB显存的显卡上即可流畅运行,量化后甚至可以部署在16GB显存上。主要用于代码补全、文档问答和轻量级逻辑推理。推荐的推理框架包括llama.cpp和vLLM,前者适合CPU+GPU混合部署,后者在GPU独占场景下吞吐量更高。 4.2 中等规模部署(30B~70B参数) 30B到70B参数的模型(如DeepSeek-V2.5、Qwen2.5-72B)在代码理解、架构设计文档生成和复杂推理任务上表现明显优于小模型。这类模型需要单张48GB以上显存,或者两张24GB显卡通过张量并行加载。推荐使用vLLM或Text Generation Inference(TGI)框架,配合4-bit或8-bit量化技术,可以在显存占用和生成质量之间取得较好的平衡。 4.3 大规模部署(671B满血版) 671B参数的DeepSeek-V3/R1满血版是当前开源模型的天花板,需要至少8张80GB显存的A100或H100通过张量并行和流水线并行组合部署。这类部署主要面向大型芯片设计团队或数据中心,用于全自动化的设计空间探索和验证策略生成。部署框架通常选择Megatron-LM或DeepSpeed,配合高速InfiniBand网络实现多节点扩展。 值得注意的是,中星微"星光智能五号"芯片的8芯片协同方案提供了一种有趣的参考:通过多颗中等规模芯片的互连协作,同样可以支撑大模型的运行。这种思路对于芯片架构研究者尤为重要——它提示我们,大模型部署的优化空间不仅存在于单芯片内部,也存在于芯片间的互连拓扑和任务调度策略中。 五、算力工作站配置推荐 聊了这么多架构原理和软件工具,最终还是要回到一个实际问题:做智能计算架构和系统芯片设计,需要一台什么样的机器?EDA仿真的内存胃口、逻辑综合的运行时间、物理设计的迭代周期,都与硬件配置直接相关。基于前面分析的计算瓶颈和验证复杂度,下面这几套方案按不同规模的芯片设计任务来搭配,从个人学习到团队共享,你可以对号入座看看哪个档位更接近你的实际需求。 方案A:入门级EDA设计与仿真 适用场景:数字电路设计学习、小型IP核开发、本科/研究生课程实验、轻量级RTL仿真 推荐机型:A350 14832-MBX CPU:Intel Ultra5 245K(14核,6P核4.8GHz+4核3.8GHz)(4.8GHz为全核超频实测优化频率) GPU:RTX4060 8GB 显存带宽:272 GB/s 内存:32GB DDR5 存储:2TB NVMe(14GB/s) 这套配置适合刚开始接触数字芯片设计的学生和自学者。32GB内存可以支撑百万门级别的小型SoC的功能仿真,Intel Ultra5的高主频在RTL编译和逻辑综合阶段也有不错的响应速度。RTX4060虽然不是专业卡,但对于轻量级的AI辅助编程和文档处理绰绰有余。2TB高速NVMe存储确保了大型EDA工具套件和仿真数据库的快速读写。 方案B:EDA设计与后仿验证 适用场景:中等规模SoC前端设计、功能验证、综合后仿真、研究生课题开发 推荐机型:GT430P 15164-MCX CPU:Xeon W7-2475X(20核5.1GHz)+水冷(5.1GHz为全核超频实测优化频率) GPU:RTX 5080 16GB 显存带宽:960.0 GB/s 内存:64GB DDR5 存储:4TB NVMe SSD Xeon W7-2475X的20核心和5.1GHz全核频率为EDA工具提供了强劲的并行计算能力。64GB内存可以支撑千万门级SoC的完整仿真流程,RTX 5080的16GB显存和960GB/s带宽在运行AI辅助验证工具时也有充足余地。水冷散热方案确保了长时间高负载运行的稳定性,对于需要连续运行数小时的回归测试场景尤为重要。 方案C:芯片设计与仿真计算 适用场景:大规模SoC设计、物理实现、静态时序分析、多核处理器架构研究 推荐机型:AE450 145128-MCA CPU:AMD霄龙9275F(24核4.5GHz)+水冷(4.5GHz为全核超频实测优化频率) GPU:RTX A400 4GB 显存带宽:96.00 GB/s 内存:128GB DDR5 存储:4TB NVMe SSD 128GB内存是这套配置的核心优势。当进行大规模布局布线或静态时序分析时,EDA工具需要在内存中维护数十亿个对象的拓扑关系和数据属性,内存容量直接决定了能够处理的设计规模上限。AMD霄龙9275F的24核心和超大缓存为并行算法提供了充足的计算资源。RTX A400作为入门级专业图形卡,主要承担显示输出任务,计算负载由CPU主导,这正是EDA工具链的典型运行模式。 方案D:共享图形服务器平台(EDA设计与后仿) 适用场景:课题组共享、虚拟双机加速、超大规模SoC全流程设计、AI训练与芯片设计混合负载 推荐机型:AE450 141384-MCA CPU:AMD霄龙9755(128核4.1GHz,512MB缓存)+水冷(4.1GHz为全核超频实测优化频率) 图形卡:Quadro T400 4GB 计算卡:A100 40GB +水冷 显存带宽:80.00 GB/s / 1.56 TB/s 内存:384GB DDR5 系统盘:4TB NVMe 数据盘:20TB SATA 这套配置的定位是实验室级别的共享平台。128核AMD霄龙9755配合512MB超大缓存,在物理设计的全局布局阶段可以显著缩短迭代周期。384GB内存允许同时加载多个大型设计的完整数据库。A100 40GB计算卡不仅支撑芯片设计中的AI辅助流程(如基于机器学习的拥塞预测和时序估计),也可以用于课题组的大模型训练任务。20TB SATA数据盘提供了充足的长期存储空间,适合保存多版本的仿真结果和版图数据。虚拟双机加速能力意味着可以同时在同一台物理机上运行两套独立的EDA环境,提升资源利用率。 六、常见问题解答 芯片设计主要吃CPU还是GPU? 传统EDA流程(逻辑综合、布局布线、时序分析)以CPU计算为主,对单核性能和多核并行都有较高要求。但近年来,AI辅助的芯片设计方法(如基于深度学习的布局优化、时序预测)开始利用GPU加速。此外,GPU在大模型辅助编程和验证用例生成方面也越来越重要。因此,建议CPU和GPU均衡配置,优先保障CPU主频和内存容量。 做系统芯片设计,内存多少才够用? 这取决于设计规模。百万门级的小型IP核,32GB内存即可流畅运行。千万门级的中等SoC,建议64GB到128GB。亿门级以上的大型芯片,物理设计阶段可能需要256GB甚至更多。一个经验法则是:布局布线阶段的内存需求大约是门数量的1到2倍(以MB计)。如果内存不足,工具会频繁使用虚拟内存,导致运行时间成倍增加。 EDA工具对存储有什么特殊要求? EDA工具在仿真和综合阶段会产生大量临时文件和数据库文件,对存储的随机读写性能非常敏感。建议系统盘使用高速NVMe SSD(读取速度10GB/s以上),容量至少2TB。数据盘可以选用大容量SATA SSD或企业级机械硬盘,用于归档历史版本和仿真结果。如果预算允许,将工具安装目录、临时文件目录和项目工作目录分别放在不同的物理盘上,可以减少IO竞争。 国产EDA工具现在能用吗? 2026年的国产EDA工具已经在部分环节实现了可用到好用的跨越。RedEDA平台覆盖封装设计、PCB布局和信号完整性仿真,支持2.5D和Chiplet先进封装。芯华章的验证平台已经在存储主控芯片领域落地。但在数字芯片前端的高端综合、后端布局布线和时序签核环节,国产工具与Synopsys、Cadence等国际巨头仍有差距。建议根据项目需求灵活搭配——核心环节使用成熟商业工具,辅助环节尝试国产替代。 AI大模型能替代芯片架构师吗? 目前还不能。大模型在RTL代码生成、验证用例生成和文档撰写方面已经展现出显著的辅助价值,但在架构级决策(如缓存层次设计、数据流策略选择、功耗性能面积权衡)方面,仍然需要人类架构师的直觉和经验。更现实的定位是"AI辅助设计"——让大模型处理重复性工作,让架构师专注于创造性决策。 学习智能计算架构从哪里入手? 建议从三个层面同时推进。底层是计算机体系结构基础,推荐从《计算机体系结构:量化研究方法》和RISC-V相关的开源处理器入手。中间层是EDA工具使用,可以通过开源工具链(Yosys、OpenROAD)先建立完整的设计流程概念。上层是AI算法和硬件协同设计,了解Transformer等主流模型的计算特征,思考如何将它们映射到硬件上。西北工业大学等高校开设的"智能计算系统"课程,正是这种全栈培养模式的典型代表。 结语 从"星光智能五号"到"星元智能体",从XPU异构架构到3D存算融合,智能计算架构正在经历一场从底层到顶层的系统性变革。而系统芯片作为这场变革的物理载体,其设计方法论和验证流程也在同步进化。EDA工具链从单纯的自动化辅助,逐步进化为AI驱动的智能设计平台;芯片架构从通用处理器的"一招鲜",转向领域专用的"百花齐放"。 对于身处这一领域的学生和研究者而言,理解架构原理只是起点。真正有价值的工作,需要把算法需求翻译成硬件结构,把设计意图验证为可流片的版图,把单点创新整合为完整系统。而一台配置合理的工作站,就是支撑这一过程的物理基座——它不是终点,而是让你走得更远的基础设施。 UltraLAB专业图形工作站定制 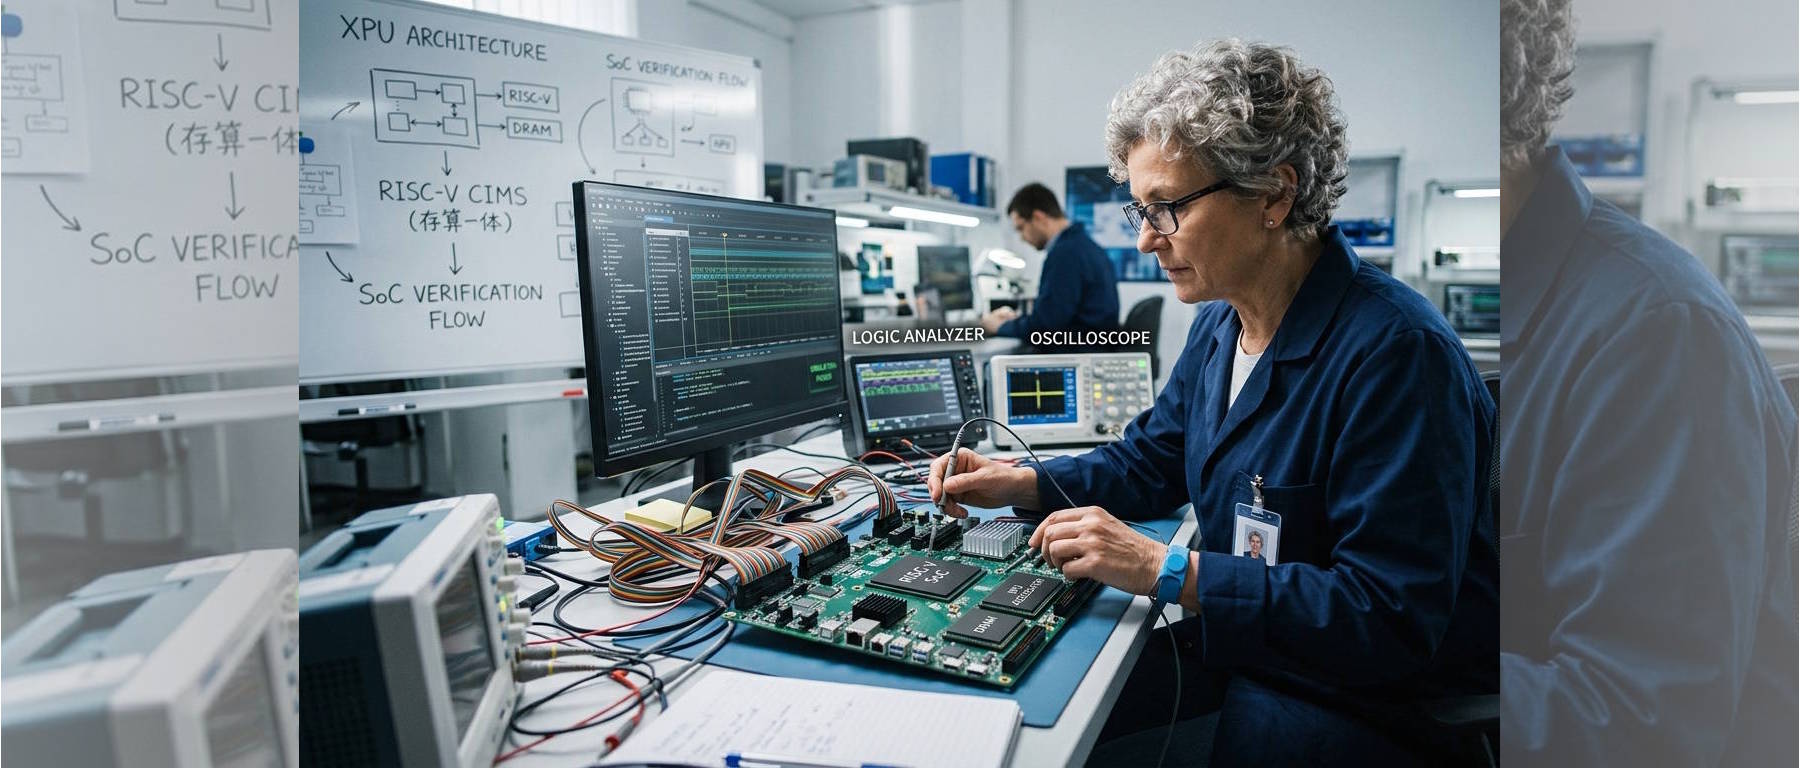 |
 回复此楼
» 猜你喜欢
 修改论文,如何借助其他力量?
已经有4人回复
-
中山大学潘越教授课题组2027级推免硕士研究生招生 新增一个专业医学技术名额
已经有21人回复
-
金属材料论文润色/翻译怎么收费?
已经有267人回复
» 抢金币啦!回帖就可以得到:
-
2027年航天航空、材料与人工智能国际会议(AMAI 2027)
 +1/996
-
2027年生物医学、农业与可持续发展国际会议(BASD 2027)
+1/899
-
大连理工大学控制科学与工程学院欧勇盛教授课题组2026年科研助理招聘启事
+2/164
-
澳门大学孙鹏展博士课题组招收全奖博士研究生1名
+2/88
-
哈工大深圳徐小川课题组招聘博士后
+1/33
-
加拿大UBC博士后招聘|人工智能 × 电池
+1/18
-
加拿大UBC博士/博士后招聘|人工智能 × 电池
+1/16
-
中国科大化学与材料科学学院/苏州高研院刘东课题组诚聘催化方向博士后
+1/10
-
【推免招生】招收材料、化工、环境、冶金类推免生
+1/9
-
加拿大UBC博士后招聘|人工智能 × 电池
+1/9
-
中国科大化学与材料科学学院/苏州高研院刘东课题组诚聘催化方向博士后
+1/9
-
求助《化学类课程思政教学设计》电子书
+1/7
-
博士和硕士推免名额-中国医学科学院/北京协和医学院
+1/6
-
一转眼,人生已是中年
+1/5
-
厦门大学航空航天学院智能制造课题组招2027年申请-考核制博士生
+1/4
-
今天爱思唯尔的官网是不是被黑客攻击了
+1/2
-
巨噬细胞空间 Marker 及原位检测技术的研究应用
+1/2
-
新药研发为什么这么难?多因子检测如何成为创新药的"数据引擎"
+1/1
-
院士领衔,ICBMBA生物功能材料与生物医学应用会议诚邀学者加入!
+1/1
-
环境控制与良率强绑定:手套箱的工程化进阶路径
+1/1
简单回复
2026-09-22 16:20
回复
peterfxmc(金币+1): 谢谢参与

庚辰辛丑3楼
2026-09-22 17:10
回复
peterfxmc(金币+1): 谢谢参与