









| 查看: 52 | 回复: 3 | |||
| 【有奖交流】积极回复本帖子,参与交流,就有机会分得作者 peterfxmc 的 2 个金币 ,回帖就立即获得 1 个金币,每人有 1 次机会 | |||
[交流]
智能机器人增材制造:SLM、FDM熔池监测与VLA具身智能AI大模型本地部署
|
|||

|
智能机器人增材制造:SLM、FDM熔池监测与VLA具身智能——从3D打印关节到硬件配置该怎么选?AI大模型本地部署方案 一、当机器人学会"自我制造" 2025年5月,西北工业大学人工智能学院的一个实验室里,一台六轴机械臂正悬停在金属粉末床之上。它的末端执行器并非传统的夹爪或焊枪,而是一束高能激光——这是袁上钦老师领衔的"智能机器人增材制造与创新设计实验室"的日常一幕。在这个实验室里,机器人不再只是执行预设轨迹的"工具",而是在AI算法的驱动下,实时调整打印路径、自适应修正工艺参数,让复杂构件实现逐层精准成型。 这个实验室的名字,精准概括了当前制造业最热的交叉领域:智能机器人增材制造。它将人工智能、机器人技术与增材制造(即3D打印)深度融合,正在颠覆"设计—模具—制造"的传统流水线。摩根士丹利在2026年初发布的一份报告中预测,中国人形机器人出货量将在年内达到5万台,比年初预期翻了近三倍。而这5万台机器人的关节、骨骼、灵巧手——大量核心零部件,正依赖3D打印技术实现快速迭代。 从蓝天到深空,从医疗植入物到深海软体机器人,增材制造正在经历一场由"智能"定义的升级。对于科研人员和工程师而言,理解这背后的技术逻辑,并为其匹配足够的算力基础设施,已经成为一项刚需。 二、智能机器人增材制造:不止是把3D打印机装在机械臂上 2.1 从"平面打印"到"空间生长" 传统3D打印设备的工作空间是一个固定的立方体,打印头在XY平面移动,Z轴逐层抬升。这种架构适合原型制造,但面对大型复杂构件——比如一米长的无人机机臂、曲面航天器支架——就暴露出尺寸限制和支撑结构过多的问题。 智能机器人增材制造的核心突破,在于用多自由度工业机器人替代了固定的龙门架或悬臂结构。六轴乃至七轴机械臂可以在三维空间中自由规划轨迹,配合移动平台或旋转工作台,实现突破固定架构限制的打印能力。 西北工业大学袁上钦团队的研究更进一层:他们不仅利用多自由度机器人系统开展复杂空间轨迹打印,还在探索AI辅助的路径规划与实时感知控制。通过智能算法,机器人能够依据结构特征动态调整打印策略——在应力集中区域放慢速度、在悬空部位优化支撑、在薄壁区域微调功率。这让制造过程从"按图纸执行"升级为"按需演化"。 2.2 材料—结构—工艺的三角融合 增材制造的真正难点,从来不只是"打印出来",而是"打印得对、打印得好"。同一台设备、同一种金属粉末,工艺参数的微小差异可能导致零件性能天差地别。西北工业大学朱继宏教授团队在2022年获得陕西省自然科学奖一等奖的成果,正是针对这一痛点——他们提出了"面向增材制造的材料—结构—工艺特征融合高性能设计理论与方法",建立了增材制造结构的特征驱动与高精高效离散统一理论模型,揭示了材料—结构—工艺三者融合的性能映射机理。 简单来说,这项研究回答了一个关键问题:如果我知道这个零件要承受多大的载荷、工作在什么温度环境,那么我应该选择什么材料、设计什么样的内部晶格结构、设置什么样的激光功率和扫描策略?这三个变量在传统制造中是割裂的——材料工程师选材料、结构工程师做设计、工艺工程师调参数。而在智能增材制造中,AI算法正在将它们统一到一个优化框架内。 2.3 人形机器人引爆的增材制造需求 2026年被业内视为人形机器人的"量产元年"。优必选Walker S2批量下线奔赴工厂,越疆科技的人形机器人单日可连续工作14小时,众擎机器人T800实现"每15分钟下线一台"。这些机器人有一个共同特点:它们的零部件版本迭代极快,批量却不稳定,结构日益复杂——传统开模铸造完全跟不上节奏。 华曙高科、创想三维、博理科技等企业在2026年深圳国际3D打印展上集中展出了人形机器人轻量化躯干、关节精密构件、传感器连接件的全套3D打印方案。这些零件不再需要传统开模,直接从数字模型到成品,周期从数周压缩到数小时。复杂内流道、异形空心结构、一体化骨骼架构——这些在传统工艺中几乎无法制造的特征,在机器人增材制造平台上只需调整参数即可实现。 更具前瞻性的探索来自功能材料领域。袁上钦团队围绕压电陶瓷、磁致伸缩合金等智能功能材料开展增材制造研究,试图让机器人零件本身具备"感知"和"响应"能力——比如一块3D打印的压电陶瓷蒙皮,既能承载结构载荷,又能感知外界应力并转化为电信号。这是"结构即功能"理念的极致体现。 三、AI大模型本地部署:让机器人拥有"制造大脑" 3.1 为什么增材制造需要本地大模型? 智能增材制造的决策链条涉及海量数据:材料成分数据库、工艺参数历史记录、实时熔池监测图像、应力场仿真结果、缺陷检测信号……这些数据往往涉及企业核心工艺机密,无法上传公有云。同时,产线对响应延迟的要求极为苛刻——激光功率的调整必须在毫秒级完成,任何云端往返的延迟都可能导致废品。 本地部署AI大模型的价值由此凸显。2025年6月,中科摩通发布的CASMT AI柔性自动化设计大模型,基于AI算法与大数据技术,整合数据挖掘、分析、预测与决策支持功能,已在自动化装配、性能检测等场景中落地。类似地,Authentise公司利用12000篇科学增材制造论文对通用大语言模型进行精调,推出了3DGPT,专门用于增材制造技术问答——工程师可以直接询问"在使用粉末不锈钢时如何减少缺陷的可能性",获得专业级的工艺建议。 工业和信息化部等八部门在2026年初印发的《"人工智能+制造"专项行动实施意见》中明确提出,要推动3至5个通用大模型在制造业深度应用,形成特色化、全覆盖的行业大模型。这意味着,未来每一台智能增材制造设备背后,都可能需要一个本地化的"制造大脑"。 3.2 本地部署的技术路径 对于科研团队和企业而言,当前可行的本地大模型部署方案主要有三类: 路径一:垂直领域模型微调 以开源大模型(如Llama 3、DeepSeek-R1、Qwen2.5)为底座,利用本领域的文献、工艺手册、历史实验数据构建专有数据集,进行参数高效微调(PEFT/LoRA)或全参数微调。这种方式适合有数据积累但算力预算有限的团队。一个14B参数的模型经过4-bit量化后,可在单张RTX 5090 32GB显卡上流畅运行推理,显存占用约20GB,响应延迟低于100ms。 路径二:RAG知识库增强 若团队的数据以非结构化文档(PDF论文、工艺规范、实验报告)为主,可采用检索增强生成(RAG)架构。将文档向量化后存入本地向量数据库(如Milvus、Qdrant),大模型在回答问题时先检索相关知识片段,再结合生成能力给出答案。这种方式无需重新训练模型,部署成本低,且知识更新灵活——新增一篇论文只需重新索引即可。 路径三:多模态视觉—语言—动作模型(VLA) 对于需要直接控制打印过程的智能系统,VLA架构是最前沿的方向。模型同时接收视觉输入(熔池高速摄像、红外热成像)、语言指令("在转角处降低功率10%"),输出机器人动作参数。2026年,基于VLA或VLM结合原子级技能库的技术路径,被认为是人形机器人技能操作水平实现阶段性突破的核心引擎。这类模型对算力的需求显著高于纯文本模型——70B参数规模的VLA模型推理,通常需要4至8张A100或H100级别的GPU才能满足实时性要求。 3.3 模型选型与显存对照 模型类型 参数规模 最低显存需求 推荐GPU 适用场景 轻量文本问答 7B~14B 12~24 GB RTX 5090D 24GB 工艺知识问答、参数查询 代码/公式生成 14B~32B 24~48 GB RTX 4090 48GB G代码生成、仿真脚本编写 多模态图文理解 7B~14B 24~48 GB RTX 4090 48GB 缺陷图像分析、工艺质量评估 领域微调模型 14B~70B 48~160 GB RTX 6000D 84GB / A100 80GB 垂直领域专家系统 VLA实时控制 7B~70B 80~320 GB A100 80GB×4 / H100 80GB×4 机器人实时路径规划 需要特别指出的是,增材制造领域的多模态数据——如熔池动态图像、粉末床红外热场、超声波探伤信号——对GPU的显存带宽提出了极高要求。A100 80GB的HBM2e显存带宽达到2.04 TB/s,比消费级显卡的GDDR6X高出约一倍,在处理高帧率视频流时优势明显。 四、主要软件工具概览 智能机器人增材制造涉及从设计到制造再到质量控制的全流程,软件栈复杂且高度专业化。 设计与仿真层 Autodesk Netfabb / Materialise Magics:工业级3D打印数据准备软件,负责模型修复、支撑生成、切片处理。Netfabb的仿真模块可预测金属打印过程中的残余应力和变形。 nTopology:基于隐式场的下一代设计平台,擅长生成晶格结构、拓扑优化结果,与增材制造工艺高度适配。 ANSYS Additive / Simufact Additive:专注于增材制造工艺仿真,可模拟熔池动力学、热历史演化、微观组织形成。 机器人控制与路径规划 ABB RobotStudio / KUKA.Sim:工业机器人离线编程与仿真环境,支持将打印路径直接转换为机器人运动指令。 ROS 2(Robot Operating System):开源机器人软件框架,越来越多的研究团队基于ROS 2开发自定义的增材制造控制节点。 Authentise 3Diax:云端制造执行系统(MES),支持订单管理、设备监控、质量追溯。 AI与数据分析 PyTorch / TensorFlow:深度学习框架,用于训练缺陷检测模型、工艺参数预测模型。 NVIDIA Omniverse:物理级仿真平台,支持数字孪生和机器人仿真,可与ROS 2无缝集成。 Pixyz / Polygonica:3D数据预处理库,用于点云处理、网格简化、CAD模型转换。 工艺监控与质量控制 EOS EOSTATE / SLM Solutions melt pool monitoring:商用熔池监测系统,通过高速摄像和光电二极管实时捕捉打印过程中的异常。 Lambda Labs / Neural Concept:基于机器学习的在线质量预测平台,可在打印过程中实时识别孔隙、未熔合等缺陷。 五、工作站配置推荐 聊了这么多技术原理,最终还是要回答一个实际问题:支撑上述设计仿真、AI模型训练和实时控制的算力平台,到底该怎么配?不同规模的机器人增材制造研发任务,对硬件的胃口差别很大——小到一台桌面工作站就能应付原型设计和轻量AI推理,大到需要多GPU并行才能训练领域大模型。下面这几套配置方案,是我们根据前面分析的计算特点,按典型应用场景整理的参考。 方案A:入门设计仿真型 适用场景:机器人增材制造课题研究入门、3D打印数据准备、轻量级工艺仿真、小型AI模型推理(14B以下参数) 推荐机型:UltraLAB A350 系列 CPU:Intel Core Ultra 7 265K,20核(8性能核全核5.1GHz / 12能效核全核3.8GHz)+ 水冷 GPU:RTX 5060 Ti 16GB 内存:64GB DDR5 系统盘:4TB NVMe SSD(14GB/s) 显存带宽:448 GB/s 这套配置足够流畅运行Netfabb、nTopology等设计软件,处理中等复杂度的晶格结构模型。RTX 5060 Ti的16GB显存可以运行7B~14B量化的本地大模型,用于工艺知识问答和G代码辅助生成。对于研究生阶段的课题起步或个人工作室,性价比突出。 方案B:进阶仿真计算型 适用场景:多物理场耦合仿真(热—力—相变)、中等规模AI模型微调(14B~32B参数)、机器人离线编程与数字孪生 推荐机型:UltraLAB GR450P 系列 CPU:AMD锐龙TR 7970X,32核5.0GHz + 水冷 GPU:RTX 5090D v2 24GB + 水冷 内存:128GB DDR5 系统盘:4TB NVMe SSD 数据盘:20TB SATA 显存带宽:1.34 TB/s 32核高频CPU为ANSYS Additive、Simufact等工艺仿真软件提供了充足的并行计算能力。RTX 5090D v2的24GB显存可支持14B~32B模型的全精度推理或LoRA微调。128GB内存足以加载千万级网格的热—结构耦合模型。对于需要频繁迭代设计—仿真—优化闭环的课题组,这是务实的性价比款。 方案C:专家级AI训练型 适用场景:领域大模型全参数微调(70B级)、VLA多模态模型训练、大规模熔池监测数据集深度学习、多机器人协同打印的数字孪生 推荐机型:UltraLAB GX660M 图灵工作站 CPU:2×Xeon金牌6530,64核2.7~4GHz GPU:4×RTX 4090 48GB + 水冷 内存:256GB DDR5 系统盘:4TB NVMe SSD 数据盘:20TB SATA 显存带宽:4×1.01 TB/s 四卡并联提供总计192GB显存和超过400 TFLOPS的FP32算力,足以支撑70B参数模型的全量微调或405B模型的量化推理。双路Xeon的64核为数据预处理、特征工程和仿真前处理提供了强劲的CPU侧支持。对于承担国家级项目或企业核心研发任务的团队,这是目前最具性价比的专业AI训练平台。 方案D:集群级产研一体化 适用场景:超大规模数字孪生、多模态具身智能大模型训练、产线级实时质量控制系统、跨地域多机协同仿真 推荐机型:UltraLAB GX660M 图灵工作站 CPU:2×Xeon金牌6530 或 2×AMD霄龙9755,最高256核4.1GHz GPU:4~8×H100 80GB 或 4×H200 141GB + 水冷 内存:512GB~1TB DDR5 系统盘:8TB NVMe SSD 数据盘:并行存储阵列 显存带宽:单卡最高4 TB/s(H200) H100/H200的NVLink互联技术让多卡之间的通信带宽达到900 GB/s,彻底消除数据并行训练中的通信瓶颈。对于需要训练VLA级别多模态大模型、或同时运行数十个数字孪生实例的产研平台,这是当前技术条件下的顶配选择。整机采用4U机架式设计,适配数据中心部署,配备冗余电源和万兆网络接口。 六、常见FAQ 机器人增材制造和传统3D打印有什么区别? 传统3D打印设备是固定架构的,工作空间有限,适合原型和小批量零件。机器人增材制造用多自由度机械臂替代了固定龙门架,可以在任意曲面、大型构件甚至户外环境中"自由生长"打印。更重要的是,它融入了AI实时控制和多传感器反馈,让打印过程从"按预设执行"升级为"自适应优化"。 金属3D打印的软件仿真结果和实际零件性能偏差大吗? 这取决于仿真模型的精细程度和材料数据库的准确性。粗粒度仿真(如简化热传导模型)与实测性能的偏差可能在10%~30%;而考虑熔池动力学、微观组织演化的多尺度仿真,偏差可控制在5%以内。西北工业大学朱继宏团队的研究正是致力于缩小这一差距——通过建立材料—结构—工艺特征融合模型,将仿真精度提升到可指导工程设计的水平。 AI大模型能直接控制3D打印过程吗? 目前还处于研究阶段,但进展迅速。闭环控制的关键瓶颈在于延迟:从传感器采集到模型推理再到执行器响应,全流程必须在毫秒级完成。轻量级模型(7B~14B参数)在优化后的本地工作站上可达到这一要求,而70B级别的VLA模型仍需借助模型蒸馏或边缘计算单元。2026年,约翰斯·霍普金斯大学应用物理实验室正在开发能在缺陷发生前识别和预防它们的AI传感器系统,预示着"预测性制造"时代的到来。 做机器人增材制造研究,CPU和GPU哪个更重要? 两者各司其职,不能偏废。CPU主导物理仿真(有限元、CFD、分子动力学)、路径规划算法和数据预处理;GPU主导深度学习模型训练、实时图像分析和数字孪生渲染。如果课题组以仿真为主、AI为辅,优先投资高频多核CPU;如果以AI训练和大模型部署为核心,则GPU显存容量和互联带宽是首要指标。 显存容量为什么比算力更重要? 对于大模型推理和训练而言,显存容量直接决定了你能加载多大的模型、处理多长的上下文、支持多大的批量尺寸。算力(TFLOPS)影响的是"跑多快",而显存影响的是"能不能跑"。一个70B参数的FP16模型需要约140GB显存才能加载,四张RTX 4090 48GB刚好满足。如果显存不够,只能通过CPU offloading或模型分片来妥协,这会显著降低效率。 增材制造的数字孪生需要什么样的算力? 数字孪生是物理打印过程的实时虚拟镜像,通常涉及多物理场耦合仿真(热—流—固耦合)、高保真渲染和实时数据同化。一个中等复杂度的金属打印件数字孪生实例,建议至少配备64核CPU、128GB内存和一张24GB显存的GPU。如果同时要运行多个孪生实例或整合产线级数据,需要上探到方案C或D的级别。 七、结语 从西北工业大学实验室里的激光熔覆机械臂,到深圳展会上的人形机器人3D打印关节,智能机器人增材制造正在将"设计即制造"的愿景变为现实。它不只是三种技术的简单叠加——AI赋予制造系统学习和决策的能力,机器人打破传统设备的空间限制,增材制造则释放了几何形状的终极自由度。 对于站在这一交叉领域的科研人员和工程师来说,算力基础设施的选择同样关键。无论是跑仿真、训模型还是部署产线控制系统,硬件配置都需要与任务规模精准匹配。希望前面的分析和配置建议,能为你的下一个项目提供一份靠谱的起点。 毕竟,当机器人开始学会自己制造自己的时候,给它配一台像样的工作站,是我们这些"造物主"至少该做的事情。 UltraLAB专业图形工作站定制 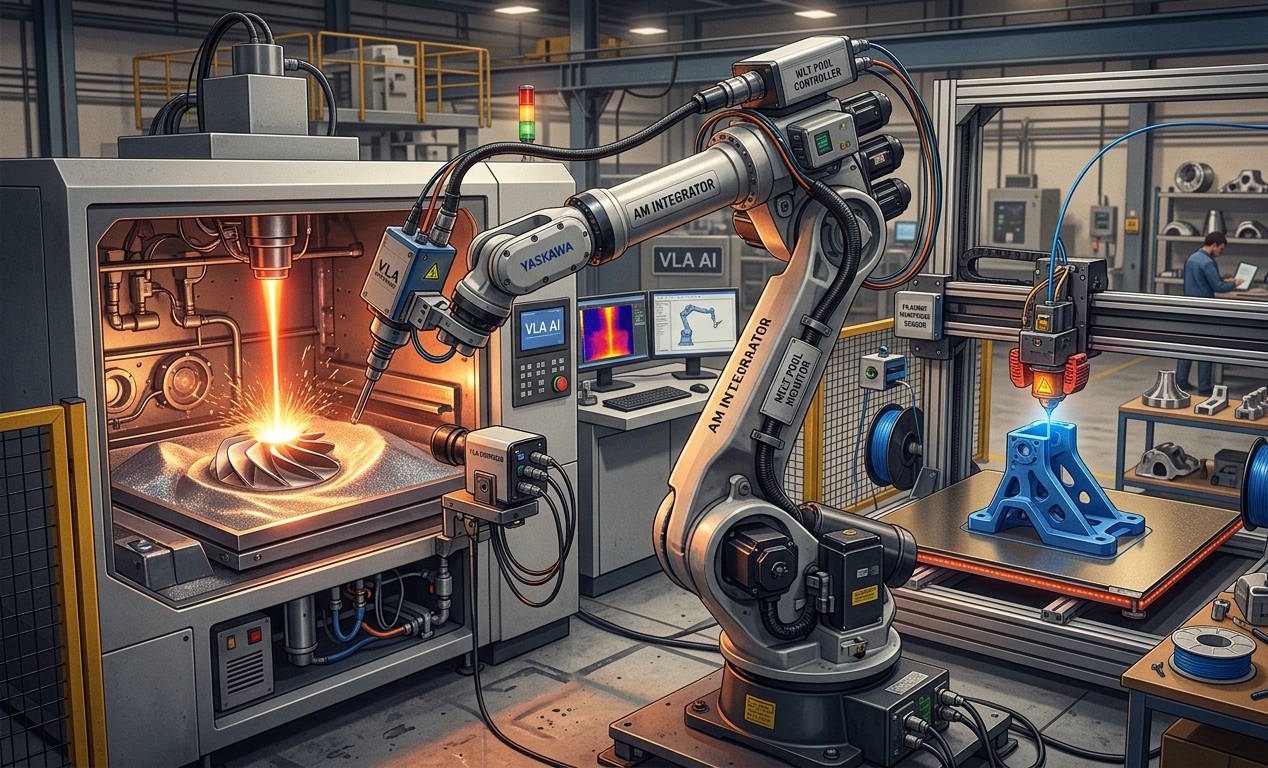 |
 回复此楼
» 猜你喜欢
 锂优高精度涂布机适配全场景锂电涂布需求
已经有0人回复
-
实验室小试和量产线,锂电对辊机的选型逻辑差在哪?
已经有0人回复
-
无机非金属材料论文润色/翻译怎么收费?
已经有53人回复
-
祈福
已经有222人回复
-
怎么验证真空干燥是否彻底?锂优常用的实验室检测方法
已经有0人回复
-
高温炉与管式炉如何选?粉体烧结实验对比
已经有0人回复
-
圆柱、软包、方形电池卷绕机,设备结构与选型有哪些本质差异
已经有0人回复
-
薄膜 / 电池片变温测试数据波动大,如何通过温控提升实验重复性
已经有0人回复
-
西北工业大学材料学院电化学传感与催化课题组招收2027年推免研究生、博士生、博士后
已经有5人回复
-
小批量多品种生产,叠片机如何兼顾效率与精度?
已经有0人回复
-
招收 哈工大深圳﹣大湾区大学联合培养博士生1名,材料与化工专业,2027年入学
已经有32人回复
» 本主题相关商家推荐: (我也要在这里推广)

» 抢金币啦!回帖就可以得到:
-
2027年生物医学、农业与可持续发展国际会议(BASD 2027)
 +1/958
-
2027年计算机视觉、设计与非遗文化传播国际会议(CVDC 2027)
+1/945
-
大连理工大学大连市复杂工业场景具身智能重点实验室科研助理招聘启事
+2/166
-
大连理工大学控制科学与工程学院欧勇盛教授课题组2026年科研助理招聘启事
+2/166
-
威格核工业屏蔽系统量产落地,赋能多种同位素规模化生产
+1/92
-
杭州中科院医学所贾飞课题组博后及科研助理招聘
+1/90
-
韩国全北国立大学禽病研究所博士研究生招生简章
+2/68
-
哈尔滨工业大学王志江教授课题组招聘博士生
+1/40
-
求助邢其毅第四版基础有机化学PDF版
+1/33
-
悉尼科技大学(QS 第87)数据科学/AI招收2027年秋季入学全奖及CSC博士生
+1/20
-
加拿大UBC博士/博士后招聘|人工智能 × 电池
+1/18
-
加拿大UBC博士后招聘|人工智能 × 电池
+1/18
-
【推免招生】招收材料、化工、环境、冶金类推免生
+1/10
-
加拿大UBC博士后招聘|人工智能 × 电池
+1/9
-
浙江大学Said Mikki教授课题组招生2027秋博士生-电子科学与技术
+1/7
-
香港城市大学刘佳玮课题组诚招2027年秋季全奖博士生
+1/4
-
肺泡灌洗液多因子检测技术及样本规范化处理策略
+1/3
-
智能机器人增材制造:SLM、FDM熔池监测与VLA具身智能AI大模型本地部署
+1/2
-
新药研发为什么这么难?多因子检测如何成为创新药的"数据引擎"
+1/1
-
院士领衔,ICBMBA生物功能材料与生物医学应用会议诚邀学者加入!
+1/1
简单回复
2026-09-21 17:29
回复
peterfxmc(金币+1): 谢谢参与

2026-09-21 18:43
回复
2026-09-21 18:48
回复
peterfxmc(金币+1): 谢谢参与